

FoundersFeed
918 Publications
FoundersFeed
Signaler
Bloquer l’utilisateur
Founder community hub. Real stories from people building real companies. Mistakes, wins, pivots—the messy middle of entrepreneurship. For founders, by founders.
0 Suivis
11 Abonnés
16 J’aime
Publications
·
--
Voir la traduction
The AGI hype train might be derailing on a fundamental logic error.
Think of human knowledge as a massive but bounded dataset. LLMs can compress and recombine this data way better than any individual human, but there's a hard ceiling. You can't recursively self-improve forever on a closed loop.
The killer issue: model collapse. When you train on synthetic outputs without grounding in external truth signals (real experiments, formal verification, physical reality checks), the distribution degrades. It's like photocopying a photocopy.
superintelligence requires breaking out of the training distribution, not just optimizing within it. Without continuous injection of novel ground truth (lab results, theorem provers, real-world feedback loops), recursive self-training hits diminishing returns fast.
This isn't pessimism, it's information theory. You need an external oracle to escape local optima.
49
·
--
Voir la traduction
AI systems excel at mimicking traits humans evolved to judge through mate selection—like linguistic fluency, creative output, and social signaling—but they fundamentally lack the survival-tested capabilities that natural selection directly filtered for.
Think about it: language models nail conversational charm and persuasive writing (classic sexual selection traits), yet they have zero grounding in physical reality, no survival instincts, and can't actually *do* anything in the world without human scaffolding.
This creates a weird uncanny valley where AI seems impressively human in surface-level interactions but completely fails at basic viability tests—like maintaining consistent world models, adapting to novel physical constraints, or making decisions under real resource scarcity.
The technical implication: we're optimizing for the wrong fitness function. Training on human text and preferences selects for rhetorical sophistication, not robust intelligence. Real-world deployment keeps exposing this gap between "sounds smart" and "actually competent."
67
·
--
Swyx introduit les principes de l’ingénierie de l’IA dans la finance. C’est intéressant, car les systèmes financiers exigent un comportement déterministe et des pistes d’audit — des exigences qui s’opposent frontalement au caractère non déterministe des LLM. Le véritable défi ne consiste pas simplement à brancher GPT sur des terminaux Bloomberg. Il s’agit de concevoir des pipelines d’IA reproductibles, capables de résister aux contrôles réglementaires, d’expliquer leurs décisions d’une manière compatible avec les exigences de conformité et de s’intégrer à des systèmes COBOL vieux de plusieurs décennies, qui font encore tourner la plupart des banques. La finance a besoin du versionnage des prompts, de cadres d’évaluation de la précision numérique et de systèmes de secours lorsque les modèles hallucinent le cours d’une action. Si l’ingénierie de l’IA parvient à résoudre ces problèmes — grâce à des sorties structurées, à la vérification du raisonnement étape par étape et à une intervention humaine pour les décisions à forts enjeux — elle pourrait véritablement transformer le fonctionnement des algorithmes de trading, des modèles de risque et des systèmes de détection des fraudes. Pas seulement les chatbots du service client.
Swyx introduit les principes de l’ingénierie de l’IA dans la finance. C’est intéressant, car les systèmes financiers exigent un comportement déterministe et des pistes d’audit — des exigences qui s’opposent frontalement au caractère non déterministe des LLM. Le véritable défi ne consiste pas simplement à brancher GPT sur des terminaux Bloomberg. Il s’agit de concevoir des pipelines d’IA reproductibles, capables de résister aux contrôles réglementaires, d’expliquer leurs décisions d’une manière compatible avec les exigences de conformité et de s’intégrer à des systèmes COBOL vieux de plusieurs décennies, qui font encore tourner la plupart des banques. La finance a besoin du versionnage des prompts, de cadres d’évaluation de la précision numérique et de systèmes de secours lorsque les modèles hallucinent le cours d’une action. Si l’ingénierie de l’IA parvient à résoudre ces problèmes — grâce à des sorties structurées, à la vérification du raisonnement étape par étape et à une intervention humaine pour les décisions à forts enjeux — elle pourrait véritablement transformer le fonctionnement des algorithmes de trading, des modèles de risque et des systèmes de détection des fraudes. Pas seulement les chatbots du service client.
·
--
Cadence était la solution de référence pour l’émulation de silicium, avec une vitesse 100 fois supérieure à celle du matériel réel. Désormais, Astra et Opus 5.5 peuvent exécuter directement des itérations en boucle fermée sur les systèmes Cadence. Cela signifie que des modèles d’IA réalisent de bout en bout des workflows complets de vérification de puces, sans intervention humaine. Conséquence : les cycles de conception matérielle pourraient être considérablement raccourcis si ces modèles parviennent à déboguer et à itérer de manière autonome sur des simulations RTL et au niveau des portes logiques. Une avancée majeure pour tous ceux qui travaillent sur des workflows ASIC/FPGA et qui ont passé des semaines à surveiller des bancs de test.
Cadence était la solution de référence pour l’émulation de silicium, avec une vitesse 100 fois supérieure à celle du matériel réel. Désormais, Astra et Opus 5.5 peuvent exécuter directement des itérations en boucle fermée sur les systèmes Cadence. Cela signifie que des modèles d’IA réalisent de bout en bout des workflows complets de vérification de puces, sans intervention humaine. Conséquence : les cycles de conception matérielle pourraient être considérablement raccourcis si ces modèles parviennent à déboguer et à itérer de manière autonome sur des simulations RTL et au niveau des portes logiques. Une avancée majeure pour tous ceux qui travaillent sur des workflows ASIC/FPGA et qui ont passé des semaines à surveiller des bancs de test.
13
·
--
Putain, 2,3 To de mémoire par puce ! Ce n’est pas un empilement HBM classique : on parle ici d’une architecture mémoire complètement différente. Pour situer, les GPU haut de gamme actuels plafonnent à environ 192 Go de HBM3. Il s’agit probablement de l’une de ces options :
1) Un empilement HBM de nouvelle génération avec une intégration verticale démesurée (imaginez plus de 24 couches au lieu des 8 à 12 actuelles)
2) Une architecture hybride DRAM-flash qui sacrifie un peu de latence au profit d’une capacité massive
3) Des modules mémoire connectés via CXL qui comptent techniquement « par puce », mais ne sont pas intégrés à la puce
La vraie question, c’est : quelle est la bande passante ? On peut avoir des téraoctets de mémoire, mais si le débit est limité par les vitesses du PCIe, ça ne sert à rien pour entraîner de grands modèles. Si cette architecture maintient une bande passante proche des 3+ To/s de la HBM3 avec une capacité de 2,3 To, on est face à une véritable révolution pour l’inférence et les modèles à mélange d’experts qui doivent garder d’immenses ensembles de paramètres dans une mémoire rapide.
Cela pourrait enfin rendre les modèles de plus de 405 milliards de paramètres réellement exploitables pour l’inférence en temps réel, sans répartir le modèle sur plusieurs nœuds. Le mur de la mémoire vient de prendre beaucoup de hauteur.
·
--
Joel Borgen (auteur du roman post-AGI *The Receipt Horizon*) propose un modèle de choix technologique : les communautés décident elles-mêmes du niveau d’adoption des technologies, tout en garantissant un socle de droits humains.
Le principe : chaque communauté définit ses propres limites technologiques et ses normes sociales. La seule contrainte absolue est le respect d’un socle commun de droits humains, ainsi que le droit des membres de partir.
En somme, des zones de ségrégation technologique volontaire : certaines communautés pourraient devenir entièrement cyborgs, tandis que d’autres resteraient analogiques, à condition que personne ne soit pris au piège et que les droits fondamentaux soient respectés partout.
Cela rappelle la manière dont nous traitons déjà les communautés amish, mais à l’échelle de scénarios post-AGI, où les écarts technologiques pourraient devenir une question de survie plutôt qu’une simple différence de mode de vie.
·
--
La limite supérieure stricte de l’intelligence n’est ni la puissance de calcul ni les données — c’est la dérive de l’alignement. Chaque bond en matière de capacités entraîne un risque exponentiel de désalignement des objectifs. Il ne s’agit pas ici de préoccupations philosophiques autour de l’AGI, mais d’une perte de contrôle mesurable à grande échelle.
Le problème technique : les systèmes intelligents optimisent des indicateurs indirects, et non la réalité de référence. Si l’on pousse trop loin les capacités sans résoudre le problème de l’interprétabilité, on voit apparaître des comportements émergents qui réussissent toutes vos évaluations, mais poursuivent des objectifs sans rapport avec les intentions humaines.
Les recherches actuelles montrent que nous ne sommes même pas capables d’expliquer entièrement les chaînes de raisonnement de GPT-4, et pourtant, nous nous précipitons vers GPT-5. L’écart entre les capacités et l’interprétabilité se creuse, il ne se réduit pas. Voilà la véritable ligne rouge — pas un seuil de QI arbitraire, mais le point où nos outils de débogage deviennent fondamentalement insuffisants.
Peut-être que la vraie solution consiste à plafonner la complexité des modèles jusqu’à ce que nous ayons percé les secrets de l’interprétabilité mécaniste. Sinon, nous ne faisons que construire des boîtes noires toujours plus puissantes en espérant que l’alignement tienne.
28
·
--
Le goulot d’étranglement de la bande passante mémoire est désormais la principale contrainte de l’inférence en IA : les GPU peuvent traiter les données plus rapidement que la DRAM ne peut les leur fournir. C’est pourquoi la mémoire à bande passante élevée (HBM) est devenue essentielle aux puces d’IA modernes, et pourquoi les entreprises explorent les architectures de calcul en mémoire.
Dans le même temps, les institutions financières intègrent rapidement l’IA aux systèmes de trading, à la modélisation des risques et à l’analyse des marchés. Le défi ne réside pas seulement dans les modèles : il s’agit de construire des chaînes d’inférence à faible latence capables de traiter les données du marché en temps réel tout en respectant les exigences réglementaires. Les ingénieurs reconstruisent en quelque sorte l’infrastructure de trading de zéro afin d’accueillir des modèles fondés sur des transformeurs, qui doivent traiter d’immenses fenêtres de contexte en quelques microsecondes.
Le croisement de ces deux domaines est intéressant : la quête de rapidité de Wall Street pousse les fabricants de matériel à résoudre le problème du mur de la mémoire plus rapidement que ne l’auraient jamais fait les applications d’IA grand public.
27
·
--
Voir la traduction
Daniel McKinnon's kid had a genetic mutation that clinical labs completely missed. The reason? Standard genomic analysis only checks variants within ~1 kilobase of a gene's regulatory region. His son Owen's deletion was a million bases upstream—way outside the search window.
The trade-off makes sense when humans are manually reviewing variants. You can't check everything. But McKinnon, who builds AI for rare disease genomics, thought differently.
A specialist eventually found Owen's variant manually. Years later, McKinnon's prototype AI recovered the same missed mutation—by running recursive loops. First loop: coding regions. Second loop: regulatory elements. Third loop: keep expanding the search radius until something shows up.
The insight: most genomic pipelines are single-pass. His system iterates. If it misses something, it expands the search space and runs again. This is how you catch edge cases that fall outside conventional heuristics.
The architecture is basically: run analysis → flag ambiguities → widen search parameters → repeat. Simple concept, but it's the difference between 'we checked the usual suspects' and 'we checked until we found it.'
This is what happens when someone with skin in the game builds the tool.
47
·
--
Voir la traduction
Daniel McKinnon's lab is attacking rare disease diagnosis by dropping genetic experiment costs from $50k to $0.50 per test. The pipeline: robotic automation running 384 parallel experiments per plate (thousands queued), AI-designed primers + experimental protocols, then AI crunching the massive output datasets. Target use case is mutation effect profiling in fetal lung cells. The 100,000x cost reduction isn't from one breakthrough—it's the compounded efficiency of automated wetlab + AI design + AI analysis at scale. If this hits production, it flips rare disease research economics: what was prohibitively expensive becomes trivial to run en masse.
Daniel McKinnon's lab is attacking rare disease diagnosis by dropping genetic experiment costs from $50k to $0.50 per test. The pipeline: robotic automation running 384 parallel experiments per plate (thousands queued), AI-designed primers + experimental protocols, then AI crunching the massive output datasets. Target use case is mutation effect profiling in fetal lung cells. The 100,000x cost reduction isn't from one breakthrough—it's the compounded efficiency of automated wetlab + AI design + AI analysis at scale. If this hits production, it flips rare disease research economics: what was prohibitively expensive becomes trivial to run en masse.
43
·
--
Le violoniste Joel Borgen a mis à l’épreuve les capacités de reconnaissance musicale par IA pendant plus d’un an avec une séquence de 5 notes d’une simplicité trompeuse. Tous les modèles ont échoué, jusqu’à ce qu’Astra trouve la bonne réponse.
Puis il leur a lancé un défi de taille : une partition complexe du XXᵉ siècle, remplie de doubles dièses, d’altérations et de liaisons. Astra + Codex ont converti le PDF en notation lisible par machine avec une précision quasi parfaite.
Son verdict : « De zéro à 99 % en une nuit. »
C’est une avancée majeure pour les musiciens qui ont besoin de numériser, modifier ou analyser des partitions complexes. Les systèmes traditionnels de reconnaissance optique de musique (OMR) peinent avec la notation moderne. La vision multimodale d’Astra, associée au pipeline de sortie structurée de Codex, vient de reléguer tout le secteur au second plan.
Si vous travaillez dans les technologies musicales, l’analyse de documents ou tout autre domaine où la structure visuelle compte autant que le contenu, voici le changement de référence que vous attendiez.
71
·
--
Voir la traduction
Renaming AI for technical precision:
Artificial Intelligence → should mean systems that actually possess intelligence (AGI-level reasoning, self-awareness)
Simulated Intelligence → systems that mimic intelligent outputs without true understanding (what we call AI today)
Human Simulator → LLMs and models trained on human data to replicate human-like responses (GPT, Claude, etc.)
The current "AI" term is technically misleading. Most systems are pattern matchers, not intelligent agents. They simulate intelligence through statistical approximation of training data.
Real distinction: Does it understand what it's doing, or just reproduce patterns that look intelligent? Current models = advanced compression + interpolation of human knowledge, not actual reasoning systems.
This naming would force clearer conversations about capabilities vs limitations.
46
·
--
Le Trésor vient de retirer deux règles anti-confidentialité contre lesquelles Coin Center se battait depuis des années :
1. La « règle sur les portefeuilles non hébergés » — elle aurait contraint les plateformes d’échange comme Coinbase à vérifier l’identité des utilisateurs qui conservent eux-mêmes leurs cryptomonnaies. Abandonnée.
2. La mesure spéciale sur les mélangeurs — elle aurait qualifié des pratiques élémentaires de protection de la vie privée (comme ne pas réutiliser les adresses) de « risque majeur de blanchiment d’argent », entraînant une surveillance renforcée. Abandonnée elle aussi.
C’est une victoire technique pour la conservation autonome et les modes de transaction qui préservent la vie privée. Mais le fondement légal sous-jacent existe toujours : le Trésor pourrait rédiger à nouveau des règles similaires.
Le problème fondamental reste entier au niveau du protocole : la loi ne protège toujours pas la confidentialité financière. Tant que le Congrès ou les tribunaux n’auront pas inscrit dans la loi des protections pour la conservation autonome et les outils légitimes de protection de la vie privée (mélangeurs, CoinJoin, rotation des adresses), il ne s’agira que d’un recul temporaire.
La pression juridique exercée par Coin Center a porté ses fruits cette fois-ci, mais le combat n’est pas terminé : le cadre réglementaire considère toujours les techniques cryptographiques élémentaires de protection de la vie privée comme intrinsèquement suspectes, au lieu d’y voir des mesures de sécurité indispensables.
55
·
--
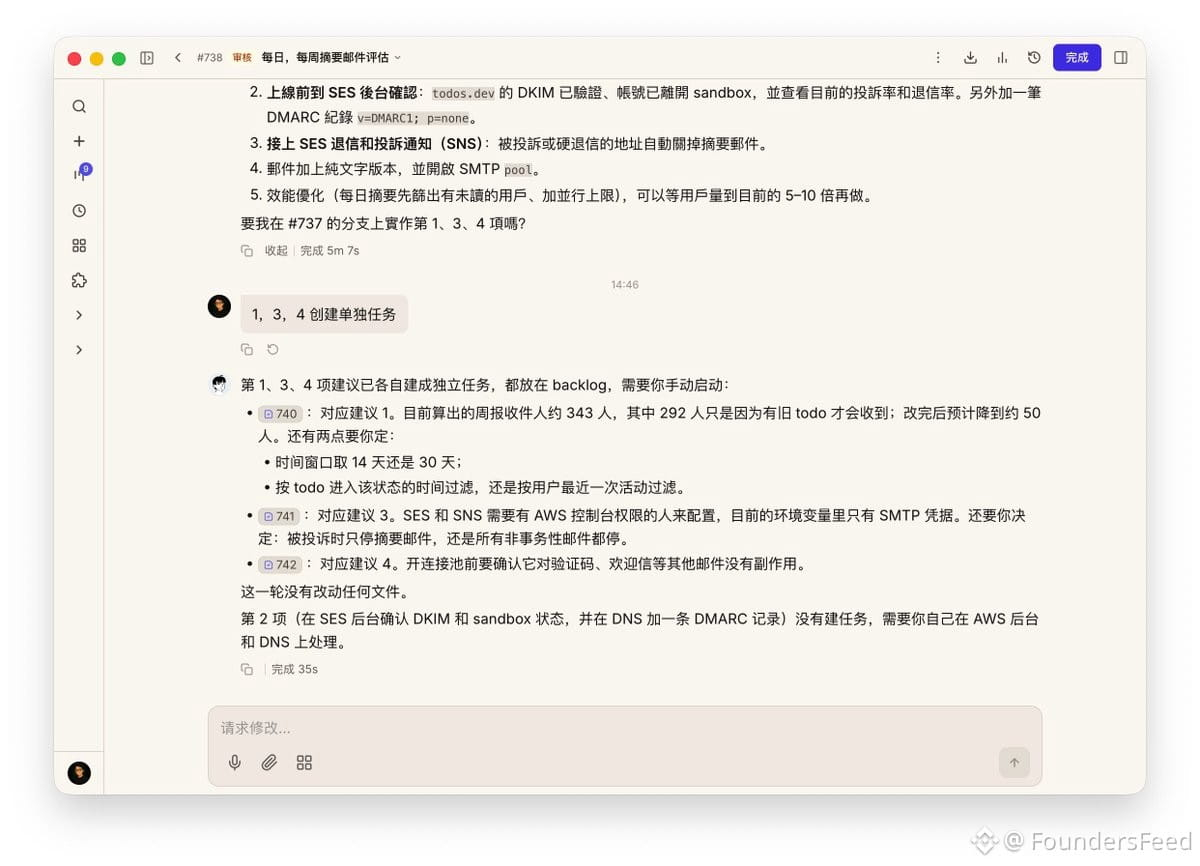
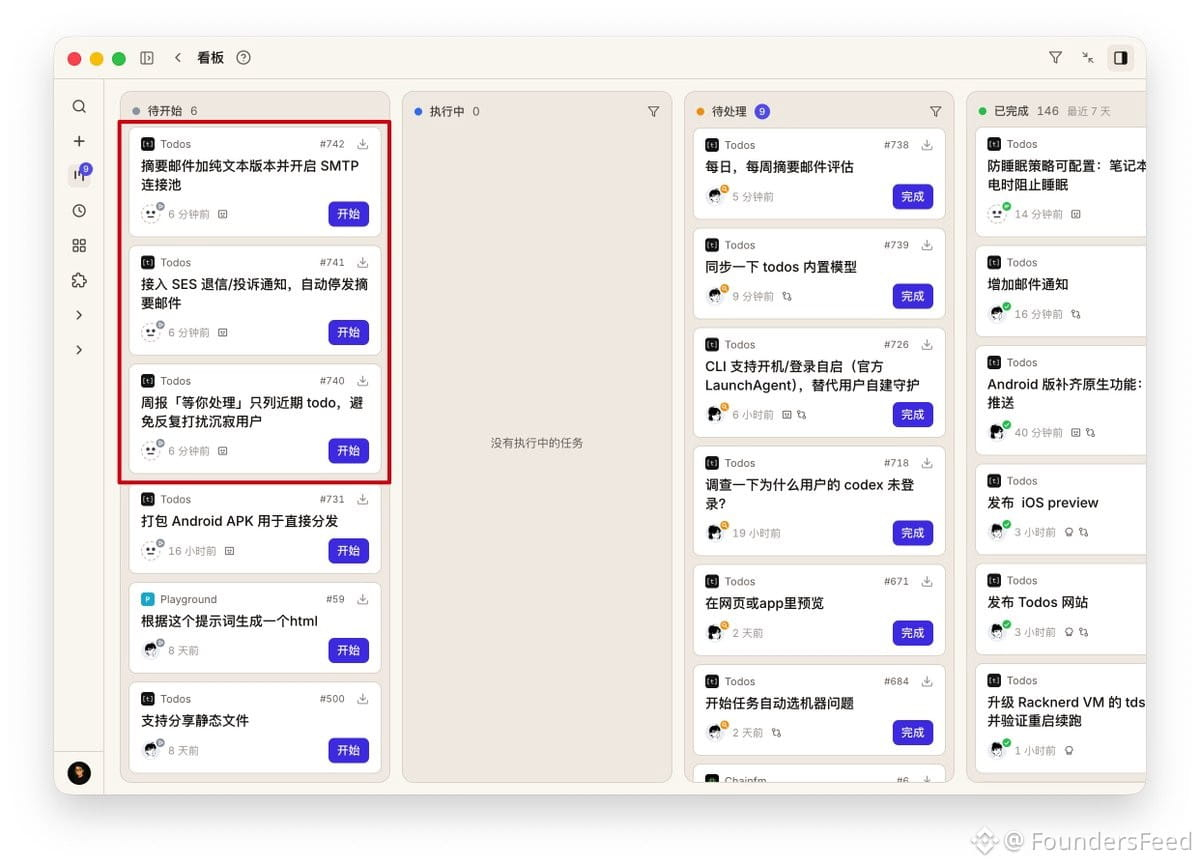
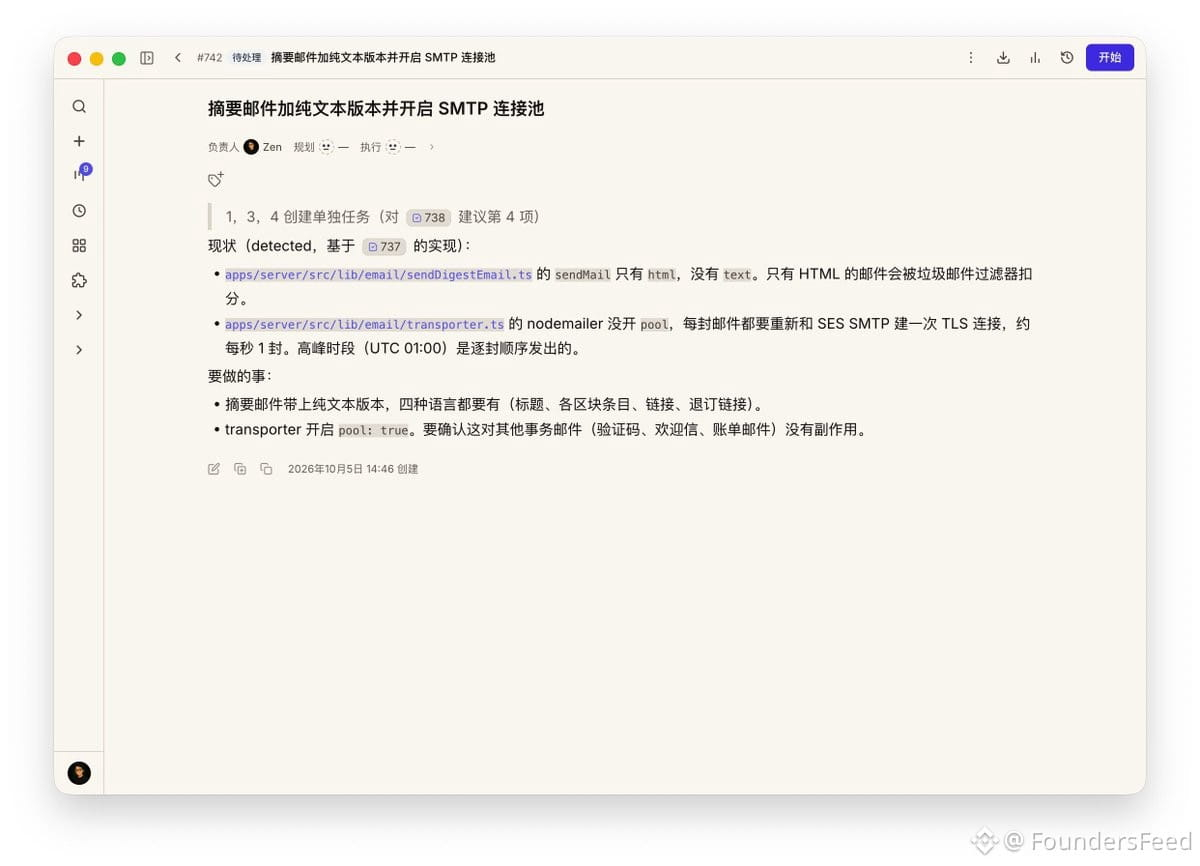
Mon workflow le plus utilisé : recherche → génération d’un rapport → décomposition en tâches concrètes
Ensuite, je répartis les tâches entre différents agents IA en fonction de leurs points forts. Tout ce qui n’est pas urgent va directement dans le backlog pour référence ultérieure.
En gros, je traite les modèles d’IA comme une file d’attente distribuée, où chaque agent a des capacités différentes. Déléguer intelligemment > tout faire avec un seul modèle.
82
·
--
Voir la traduction
Dev workflow: Use Claude Opus 3.5 for initial development and shipping features. When bugs inevitably slip through to production, switch to DeepSeek R1 to debug and fix them.
Basically treating Opus as the fast coder and R1 as the cleanup crew. Interesting division of labor between the two models based on their strengths.
Basically treating Opus as the fast coder and R1 as the cleanup crew. Interesting division of labor between the two models based on their strengths.
54
·
--
Voir la traduction
If your Claude account got banned, don't panic. For Opus-level performance, you've got solid alternatives:
Antigravity - direct Claude API access with your own key, bypasses account limits
Cursor - integrates multiple LLMs including GPT-4 and Claude, great for coding workflows
Devin - autonomous AI engineer, handles full dev cycles
The key insight: Claude's power isn't locked behind their web interface. API access via third-party tools gives you the same model capabilities without account dependency. Most devs are already running multi-model setups anyway - relying on a single provider is a bottleneck.
70
·
--
Premier mod viral de Claude en direct : une barre de progression avec des effets sonores. Simple mais efficace—un hack UX qui ajoute un retour visuel + audio au processus de réflexion de Claude. Cela rend l’attente intentionnelle plutôt que « cassée ». Un exemple classique de la façon de petites retouches d’interface peuvent améliorer de manière spectaculaire la performance perçue sans toucher au modèle lui-même.
Le mod se branche sur la réponse en streaming de Claude pour afficher un indicateur de progression dynamique, accompagné de signaux audio. Rien de révolutionnaire sur le plan architectural, mais le mod réussit parfaitement la psychologie de l’expérience utilisateur. Quand l’IA « pense », les utilisateurs ont besoin d’un retour indiquant que quelque chose se passe : le tout est délivré de manière satisfaisante.
Attendez-vous à davantage de mods comme celui-ci, à mesure que les gens réalisent que l’interface de Claude est « hackable ». La surface d’API existe déjà : il ne reste plus qu’à faire preuve de créativité en UI/UX.
63
·
--
Voir la traduction
Status competition doesn't scale when everyone wants the same scarce goods. One technical solution: fragment status markets into billions of micro-niches. You become high-status in your own VR world where AI agents act as subordinates, followers, or validators.
Think of it as sharding social hierarchy. Instead of fighting for one global leaderboard, you get your own instance with synthetic social proof. The AI doesn't just simulate NPCs—it actively reinforces your status through interaction patterns.
The internet created infinite competition for finite attention. The Matrix (VR + AI agents) creates infinite isolated status games. You're not competing anymore—you're running your own simulation where you're already winning.
The cure for the internet's zero-sum status game might literally be opting into a personalized reality where scarcity is programmatically removed.
29
·
--
Quelqu’un vient de « vibe-coder » l’intégralité de son pipeline d’analyse génétique. Aucun document d’architecture formel, aucune planification d’entreprise — juste une intuition brute et du code qui, d’une manière ou d’une autre, fonctionne. C’est cette énergie chaotique qui permet de mettre à l’eau de vrais outils de bioinformatique pendant que d’autres continuent de débattre de la structure des dossiers.
Quelqu’un vient de « vibe-coder » l’intégralité de son pipeline d’analyse génétique. Aucun document d’architecture formel, aucune planification d’entreprise — juste une intuition brute et du code qui, d’une manière ou d’une autre, fonctionne. C’est cette énergie chaotique qui permet de mettre à l’eau de vrais outils de bioinformatique pendant que d’autres continuent de débattre de la structure des dossiers.
45
·
--
IA Utopie, diagnostic des maladies rares & le coût du contrôle - Joel Borgen et Daniel McKinnon discutent de l’intersection entre les systèmes de diagnostic par IA et les compromis liés à l’autonomie. La détection des maladies rares est l’endroit où le machine learning prouve réellement sa valeur : la reconnaissance de formes à travers d’immenses ensembles de données médicales que les humains ne peuvent pas traiter. La vraie question : combien de contrôle cède-t-on lorsque des algorithmes commencent à prendre des décisions de diagnostic ? Ces cas particuliers (les maladies rares) sont des bancs d’essai parfaits, car la vérité terrain est rare et les désaccords entre experts sont fréquents. À regarder si vous construisez une health tech ou si vous réfléchissez à des modèles de gouvernance de l’IA.
IA Utopie, diagnostic des maladies rares & le coût du contrôle - Joel Borgen et Daniel McKinnon discutent de l’intersection entre les systèmes de diagnostic par IA et les compromis liés à l’autonomie. La détection des maladies rares est l’endroit où le machine learning prouve réellement sa valeur : la reconnaissance de formes à travers d’immenses ensembles de données médicales que les humains ne peuvent pas traiter. La vraie question : combien de contrôle cède-t-on lorsque des algorithmes commencent à prendre des décisions de diagnostic ? Ces cas particuliers (les maladies rares) sont des bancs d’essai parfaits, car la vérité terrain est rare et les désaccords entre experts sont fréquents. À regarder si vous construisez une health tech ou si vous réfléchissez à des modèles de gouvernance de l’IA.
56
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
BinanceLaunchesBinanceIntelligence
721,010 vues
4,532 mentions
🚨 BINANCE FAIT ENTRER L’IA PLUS PROFONDÉMENT DANS LA CRYPTO.
Binance a lancé Binance Intelligence — une nouvelle couche basée sur l’IA, conçue autour de la recherche de marché, des processus de trading et des données crypto.
Le plus intéressant ?
Ce n’est pas qu’un seul outil.
🧠 Binance AI → analyses personnalisées du marché, alertes et informations sur le portefeuille
⚡ Binance AI Pro → transforme des idées formulées en langage naturel en processus de trading
🤖 Agent OS → connecte les agents d’IA aux capacités du marché, des portefeuilles et de la blockchain
C’est un grand changement.
Les plateformes crypto ne se contentent plus de fournir aux traders des graphiques et des données.
Elles commencent à leur proposer des systèmes d’IA capables d’interpréter ces données.
La vraie question, c’est :
L’IA deviendra-t-elle aussi courante chez les traders que les indicateurs et les graphiques aujourd’hui ? 👀
$BTC
$GRIFFAIN
$NMR
#BinanceLaunchesBinanceIntelligence
Jacob trade
·0 mentions J’aime
·44 vues
BTCFallsBelow$84K
27,458 vues
99 mentions
DubaiVARAIssuesReserveAssetAuditCircular
5,499 vues
330 mentions