
#algorithmictrading
algorithmictrading
33,398 vues
317 mentions
Populaire
Récents
·
--
Faire le lien entre la recherche dans Jupyter Notebook et un déploiement MT5 en production, déterministe, est délicat. 😬
Lorsque votre réseau neuronal de pointe est prêt, méfiez-vous des pièges liés à la cohérence des données et à la validation du chemin d’exécution.
Voici les étapes clés pour structurer le déploiement :
1. Définir rigoureusement la tâche de prédiction : précisez l’instrument, l’unité de temps, l’heure de décision et la signification de la sortie. Les étiquettes doivent s’arrêter après l’heure de décision, ce qui nécessite des divisions chronologiques avec purge.
2. Garantir la parité des caractéristiques : créez un « jeu de données de référence » — une petite séquence de barres immuable — pour vérifier que les vecteurs de caractéristiques concordent entre les pipelines de recherche et de production (vérifiez les fuseaux horaires, les spreads et la normalisation).
3. Structurer le flux de travail : traitez le processus comme une succession d’étapes distinctes et versionnées, et non comme un Expert Advisor monolithique. Versionnez tout : le mappage des symboles, la construction des barres, les définitions des caractéristiques, l’architecture du modèle, etc.
4. Effectuer un entraînement rigoureux : utilisez des fenêtres chronologiques, testez sur des données ultérieures et n’ouvrez le jeu de test final qu’une seule fois. Comparez les sorties de MQL5 et de Python pour vérifier leur cohérence.
5. Effectuer un backtest de l’ensemble du processus de décision : faites passer la sortie du modèle par une règle de décision figée et testez l’ensemble du processus en tenant compte des coûts réels (spread, glissement, etc.).
6. Choisir la frontière d’intégration : sélectionnez un modèle (MQL5 natif, Python ou service local) et définissez la latence maximale d’inférence, la version du schéma et un mécanisme de repli sécurisé en cas d’échec.
7. Préserver le déterminisme et la sécurité : consignez la limite temporelle des données d’entrée, les versions des caractéristiques et du modèle, la sortie brute, la décision de risque et la requête envoyée au courtier. Les garde-fous du portefeuille doivent vérifier l’exposition avant tout ordre. ⚠️
8. Pour la mise en production : utilisez une relecture hors ligne ou le testeur de stratégie MT5. Assurez-vous qu’un registre de modèles conserve des poids immuables et des sommes de contrôle pour permettre les retours arrière. 🛡️
Pour approfondir la structuration de ces pipelines complexes de ML pour MT5, consultez ce guide détaillé : https://community.wolfbot.io/academy/neural-networks-mt5-research-to-deployment
#AlgorithmicTrading #MQL5 #MachineLearning #QuantDev #Automation
Faire le lien entre la recherche dans Jupyter Notebook et un déploiement MT5 en production, déterministe, est délicat. 😬
Lorsque votre réseau neuronal de pointe est prêt, méfiez-vous des pièges liés à la cohérence des données et à la validation du chemin d’exécution.
Voici les étapes clés pour structurer le déploiement :
1. Définir rigoureusement la tâche de prédiction : précisez l’instrument, l’unité de temps, l’heure de décision et la signification de la sortie. Les étiquettes doivent s’arrêter après l’heure de décision, ce qui nécessite des divisions chronologiques avec purge.
2. Garantir la parité des caractéristiques : créez un « jeu de données de référence » — une petite séquence de barres immuable — pour vérifier que les vecteurs de caractéristiques concordent entre les pipelines de recherche et de production (vérifiez les fuseaux horaires, les spreads et la normalisation).
3. Structurer le flux de travail : traitez le processus comme une succession d’étapes distinctes et versionnées, et non comme un Expert Advisor monolithique. Versionnez tout : le mappage des symboles, la construction des barres, les définitions des caractéristiques, l’architecture du modèle, etc.
4. Effectuer un entraînement rigoureux : utilisez des fenêtres chronologiques, testez sur des données ultérieures et n’ouvrez le jeu de test final qu’une seule fois. Comparez les sorties de MQL5 et de Python pour vérifier leur cohérence.
5. Effectuer un backtest de l’ensemble du processus de décision : faites passer la sortie du modèle par une règle de décision figée et testez l’ensemble du processus en tenant compte des coûts réels (spread, glissement, etc.).
6. Choisir la frontière d’intégration : sélectionnez un modèle (MQL5 natif, Python ou service local) et définissez la latence maximale d’inférence, la version du schéma et un mécanisme de repli sécurisé en cas d’échec.
7. Préserver le déterminisme et la sécurité : consignez la limite temporelle des données d’entrée, les versions des caractéristiques et du modèle, la sortie brute, la décision de risque et la requête envoyée au courtier. Les garde-fous du portefeuille doivent vérifier l’exposition avant tout ordre. ⚠️
8. Pour la mise en production : utilisez une relecture hors ligne ou le testeur de stratégie MT5. Assurez-vous qu’un registre de modèles conserve des poids immuables et des sommes de contrôle pour permettre les retours arrière. 🛡️
Pour approfondir la structuration de ces pipelines complexes de ML pour MT5, consultez ce guide détaillé : https://community.wolfbot.io/academy/neural-networks-mt5-research-to-deployment
#AlgorithmicTrading #MQL5 #MachineLearning #QuantDev #Automation
Lorsque votre réseau neuronal de pointe est prêt, méfiez-vous des pièges liés à la cohérence des données et à la validation du chemin d’exécution.
Voici les étapes clés pour structurer le déploiement :
1. Définir rigoureusement la tâche de prédiction : précisez l’instrument, l’unité de temps, l’heure de décision et la signification de la sortie. Les étiquettes doivent s’arrêter après l’heure de décision, ce qui nécessite des divisions chronologiques avec purge.
2. Garantir la parité des caractéristiques : créez un « jeu de données de référence » — une petite séquence de barres immuable — pour vérifier que les vecteurs de caractéristiques concordent entre les pipelines de recherche et de production (vérifiez les fuseaux horaires, les spreads et la normalisation).
3. Structurer le flux de travail : traitez le processus comme une succession d’étapes distinctes et versionnées, et non comme un Expert Advisor monolithique. Versionnez tout : le mappage des symboles, la construction des barres, les définitions des caractéristiques, l’architecture du modèle, etc.
4. Effectuer un entraînement rigoureux : utilisez des fenêtres chronologiques, testez sur des données ultérieures et n’ouvrez le jeu de test final qu’une seule fois. Comparez les sorties de MQL5 et de Python pour vérifier leur cohérence.
5. Effectuer un backtest de l’ensemble du processus de décision : faites passer la sortie du modèle par une règle de décision figée et testez l’ensemble du processus en tenant compte des coûts réels (spread, glissement, etc.).
6. Choisir la frontière d’intégration : sélectionnez un modèle (MQL5 natif, Python ou service local) et définissez la latence maximale d’inférence, la version du schéma et un mécanisme de repli sécurisé en cas d’échec.
7. Préserver le déterminisme et la sécurité : consignez la limite temporelle des données d’entrée, les versions des caractéristiques et du modèle, la sortie brute, la décision de risque et la requête envoyée au courtier. Les garde-fous du portefeuille doivent vérifier l’exposition avant tout ordre. ⚠️
8. Pour la mise en production : utilisez une relecture hors ligne ou le testeur de stratégie MT5. Assurez-vous qu’un registre de modèles conserve des poids immuables et des sommes de contrôle pour permettre les retours arrière. 🛡️
Pour approfondir la structuration de ces pipelines complexes de ML pour MT5, consultez ce guide détaillé : https://community.wolfbot.io/academy/neural-networks-mt5-research-to-deployment
#AlgorithmicTrading #MQL5 #MachineLearning #QuantDev #Automation
1
82

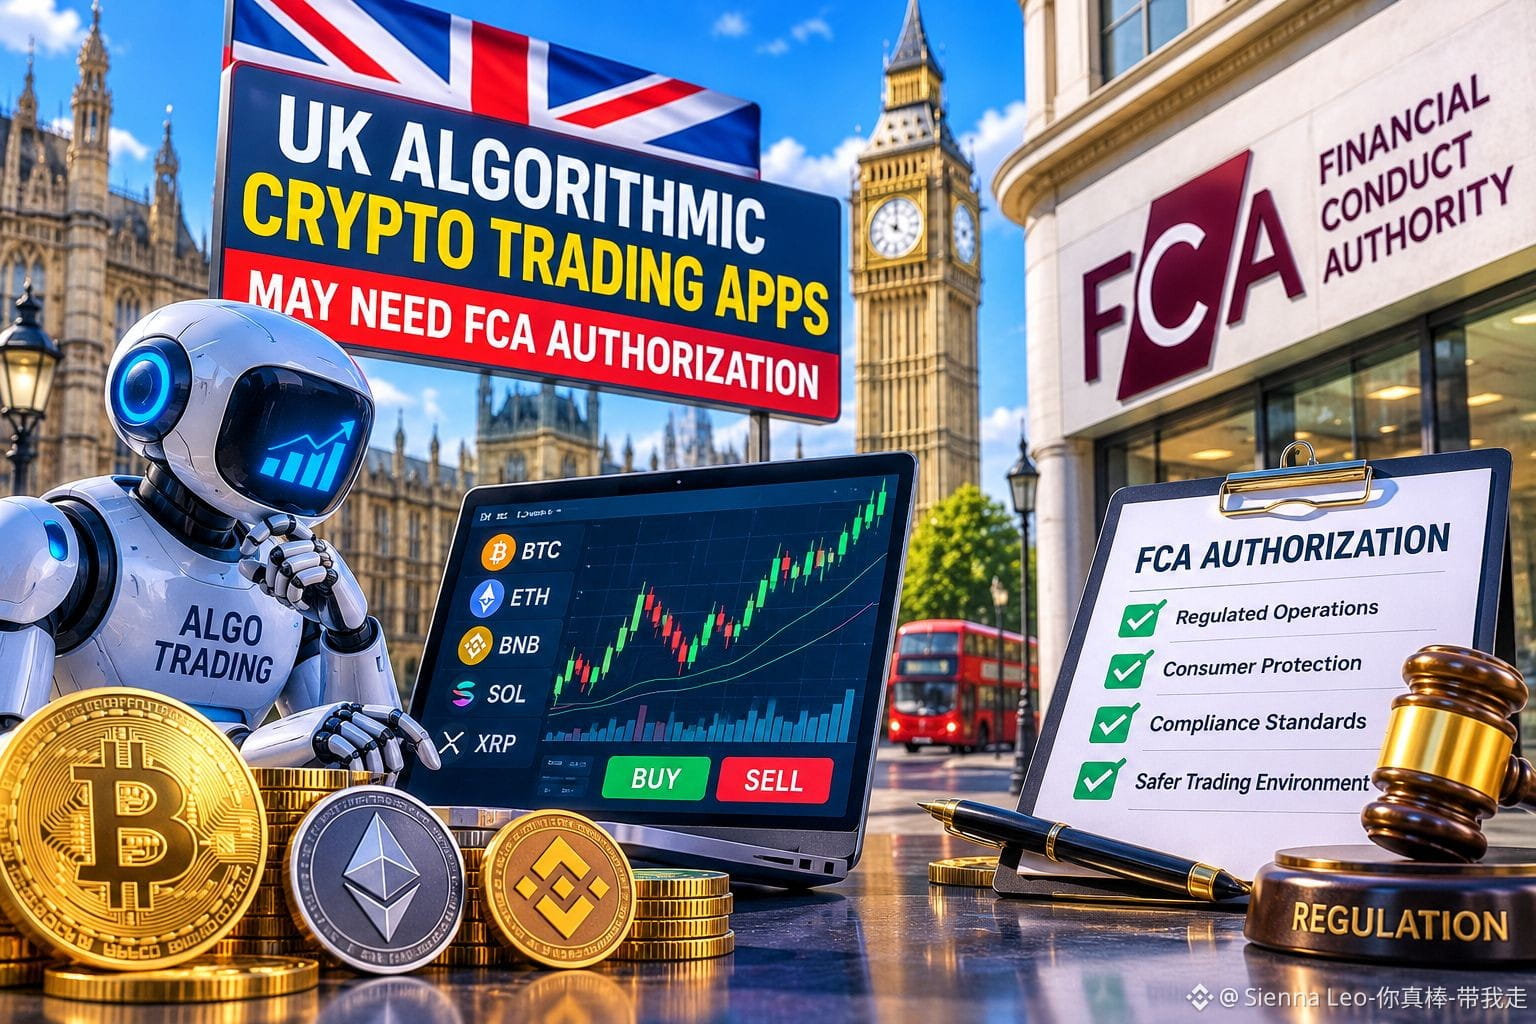
#UKAlgorithmicCryptoTradingAppsMayNeedFCAAuthorization
🤖🇬🇧 Les applications britanniques de trading algorithmique de cryptomonnaies pourraient avoir besoin d’une autorisation de la FCA 🇬🇧🤖
Imaginez que vous ouvriez une application de trading de cryptomonnaies, définissiez quelques règles et laissiez un logiciel acheter et vendre pendant que vous dormez. Cette commodité semble simple, jusqu’à ce que la réglementation pose une question cruciale : qui est responsable lorsqu’un système automatisé prend des décisions avec votre argent ?
Le Royaume-Uni s’oriente vers un cadre réglementaire plus complet pour les cryptomonnaies. La Financial Conduct Authority (FCA) a ouvert, le 30 septembre 2026, les demandes d’autorisation destinées aux entreprises du secteur des cryptomonnaies, avant l’entrée en vigueur du nouveau régime le 25 octobre 2027.
Dans le cadre de ce régime, des activités telles que l’exploitation de plateformes de trading de cryptomonnaies, les opérations sur cryptoactifs et l’organisation de transactions pourraient nécessiter une autorisation. Les applications de trading algorithmique pourraient donc être concernées, selon les services qu’elles proposent et le fonctionnement de leur activité.
Il est important de distinguer le fait que l’automatisation, à elle seule, ne soumet pas automatiquement toutes les applications aux mêmes exigences. L’activité réelle, le modèle commercial et les règles réglementaires applicables sont déterminants.
Pour les utilisateurs, un contrôle renforcé pourrait améliorer la responsabilisation, la protection des consommateurs et les normes opérationnelles. Pour les développeurs, toutefois, l’autorisation pourrait entraîner des coûts de conformité supplémentaires, des obligations documentaires et de nouvelles responsabilités opérationnelles.
Les petits prestataires pourraient être confrontés à des choix difficiles : investir dans la conformité, modifier leurs services ou envisager de cesser leurs activités au Royaume-Uni. Les entreprises établies seront peut-être mieux à même d’absorber ces coûts, même si la réglementation ne garantit pas, à elle seule, un produit plus sûr.
Mon avis : l’automatisation des cryptomonnaies est en train de devenir bien plus qu’un défi de programmation. Pour être pérennes, les plateformes devront démontrer non seulement que leurs algorithmes fonctionnent, mais aussi que leurs activités respectent la réglementation.
L’autorisation de la FCA rendra-t-elle le trading algorithmique de cryptomonnaies plus sûr, ou les coûts de conformité risquent-ils de réduire la concurrence ?
Avertissement : contenu à visée éducative uniquement, ne constituant pas un conseil financier.
#CryptoRegulation #AlgorithmicTrading #GrowWithSAC $MUB $CUDIS $SLF
#UKAlgorithmicCryptoTradingAppsMayNeedFCAAuthorization
🤖🇬🇧 Les applications britanniques de trading algorithmique de cryptomonnaies pourraient avoir besoin d’une autorisation de la FCA 🇬🇧🤖
Imaginez que vous ouvriez une application de trading de cryptomonnaies, définissiez quelques règles et laissiez un logiciel acheter et vendre pendant que vous dormez. Cette commodité semble simple, jusqu’à ce que la réglementation pose une question cruciale : qui est responsable lorsqu’un système automatisé prend des décisions avec votre argent ?
Le Royaume-Uni s’oriente vers un cadre réglementaire plus complet pour les cryptomonnaies. La Financial Conduct Authority (FCA) a ouvert, le 30 septembre 2026, les demandes d’autorisation destinées aux entreprises du secteur des cryptomonnaies, avant l’entrée en vigueur du nouveau régime le 25 octobre 2027.
Dans le cadre de ce régime, des activités telles que l’exploitation de plateformes de trading de cryptomonnaies, les opérations sur cryptoactifs et l’organisation de transactions pourraient nécessiter une autorisation. Les applications de trading algorithmique pourraient donc être concernées, selon les services qu’elles proposent et le fonctionnement de leur activité.
Il est important de distinguer le fait que l’automatisation, à elle seule, ne soumet pas automatiquement toutes les applications aux mêmes exigences. L’activité réelle, le modèle commercial et les règles réglementaires applicables sont déterminants.
Pour les utilisateurs, un contrôle renforcé pourrait améliorer la responsabilisation, la protection des consommateurs et les normes opérationnelles. Pour les développeurs, toutefois, l’autorisation pourrait entraîner des coûts de conformité supplémentaires, des obligations documentaires et de nouvelles responsabilités opérationnelles.
Les petits prestataires pourraient être confrontés à des choix difficiles : investir dans la conformité, modifier leurs services ou envisager de cesser leurs activités au Royaume-Uni. Les entreprises établies seront peut-être mieux à même d’absorber ces coûts, même si la réglementation ne garantit pas, à elle seule, un produit plus sûr.
Mon avis : l’automatisation des cryptomonnaies est en train de devenir bien plus qu’un défi de programmation. Pour être pérennes, les plateformes devront démontrer non seulement que leurs algorithmes fonctionnent, mais aussi que leurs activités respectent la réglementation.
L’autorisation de la FCA rendra-t-elle le trading algorithmique de cryptomonnaies plus sûr, ou les coûts de conformité risquent-ils de réduire la concurrence ?
Avertissement : contenu à visée éducative uniquement, ne constituant pas un conseil financier.
#CryptoRegulation #AlgorithmicTrading #GrowWithSAC $MUB $CUDIS $SLF
🤖🇬🇧 Les applications britanniques de trading algorithmique de cryptomonnaies pourraient avoir besoin d’une autorisation de la FCA 🇬🇧🤖
Imaginez que vous ouvriez une application de trading de cryptomonnaies, définissiez quelques règles et laissiez un logiciel acheter et vendre pendant que vous dormez. Cette commodité semble simple, jusqu’à ce que la réglementation pose une question cruciale : qui est responsable lorsqu’un système automatisé prend des décisions avec votre argent ?
Le Royaume-Uni s’oriente vers un cadre réglementaire plus complet pour les cryptomonnaies. La Financial Conduct Authority (FCA) a ouvert, le 30 septembre 2026, les demandes d’autorisation destinées aux entreprises du secteur des cryptomonnaies, avant l’entrée en vigueur du nouveau régime le 25 octobre 2027.
Dans le cadre de ce régime, des activités telles que l’exploitation de plateformes de trading de cryptomonnaies, les opérations sur cryptoactifs et l’organisation de transactions pourraient nécessiter une autorisation. Les applications de trading algorithmique pourraient donc être concernées, selon les services qu’elles proposent et le fonctionnement de leur activité.
Il est important de distinguer le fait que l’automatisation, à elle seule, ne soumet pas automatiquement toutes les applications aux mêmes exigences. L’activité réelle, le modèle commercial et les règles réglementaires applicables sont déterminants.
Pour les utilisateurs, un contrôle renforcé pourrait améliorer la responsabilisation, la protection des consommateurs et les normes opérationnelles. Pour les développeurs, toutefois, l’autorisation pourrait entraîner des coûts de conformité supplémentaires, des obligations documentaires et de nouvelles responsabilités opérationnelles.
Les petits prestataires pourraient être confrontés à des choix difficiles : investir dans la conformité, modifier leurs services ou envisager de cesser leurs activités au Royaume-Uni. Les entreprises établies seront peut-être mieux à même d’absorber ces coûts, même si la réglementation ne garantit pas, à elle seule, un produit plus sûr.
Mon avis : l’automatisation des cryptomonnaies est en train de devenir bien plus qu’un défi de programmation. Pour être pérennes, les plateformes devront démontrer non seulement que leurs algorithmes fonctionnent, mais aussi que leurs activités respectent la réglementation.
L’autorisation de la FCA rendra-t-elle le trading algorithmique de cryptomonnaies plus sûr, ou les coûts de conformité risquent-ils de réduire la concurrence ?
Avertissement : contenu à visée éducative uniquement, ne constituant pas un conseil financier.
#CryptoRegulation #AlgorithmicTrading #GrowWithSAC $MUB $CUDIS $SLF
1
1
361
Les backtests semblent parfaits, mais le marché en temps réel vous paraît imprévisible ? 🤔 Il est facile de douter de l’ensemble du système.
Faire confiance aux systèmes automatisés, c’est comprendre l’écart entre une simulation historique et l’adaptation en temps réel.
Voici comment nous renforçons la confiance dans la prise de décision automatisée :
1. Les backtests montrent comment la logique de trading fondamentale aurait fonctionné à partir de données historiques. ✅
2. En trading réel, WolfBot utilise un moteur d’IA adaptatif qui, contrairement aux simulations statiques, évalue continuellement les performances du modèle.
3. Si le système détecte de mauvaises performances du modèle en conditions réelles, il peut faire une pause et s’améliorer avant son redéploiement. 🛡️
4. La logique de trading fondamentale reste cohérente entre les backtests et le trading réel : c’est le fondement de la confiance.
5. N’oubliez pas de considérer les résultats des backtests comme un seul élément parmi d’autres, aux côtés des performances en temps réel, des contrôles des risques et de la surveillance. 📈
Pour en savoir plus sur la validation de notre logique à partir des données passées, consultez : https://wolfbot.io/en/backtest
#AlgorithmicTrading #Backtesting #CryptoAutomation #TradingStrategy #Crypto
Les backtests semblent parfaits, mais le marché en temps réel vous paraît imprévisible ? 🤔 Il est facile de douter de l’ensemble du système.
Faire confiance aux systèmes automatisés, c’est comprendre l’écart entre une simulation historique et l’adaptation en temps réel.
Voici comment nous renforçons la confiance dans la prise de décision automatisée :
1. Les backtests montrent comment la logique de trading fondamentale aurait fonctionné à partir de données historiques. ✅
2. En trading réel, WolfBot utilise un moteur d’IA adaptatif qui, contrairement aux simulations statiques, évalue continuellement les performances du modèle.
3. Si le système détecte de mauvaises performances du modèle en conditions réelles, il peut faire une pause et s’améliorer avant son redéploiement. 🛡️
4. La logique de trading fondamentale reste cohérente entre les backtests et le trading réel : c’est le fondement de la confiance.
5. N’oubliez pas de considérer les résultats des backtests comme un seul élément parmi d’autres, aux côtés des performances en temps réel, des contrôles des risques et de la surveillance. 📈
Pour en savoir plus sur la validation de notre logique à partir des données passées, consultez : https://wolfbot.io/en/backtest
#AlgorithmicTrading #Backtesting #CryptoAutomation #TradingStrategy #Crypto
Faire confiance aux systèmes automatisés, c’est comprendre l’écart entre une simulation historique et l’adaptation en temps réel.
Voici comment nous renforçons la confiance dans la prise de décision automatisée :
1. Les backtests montrent comment la logique de trading fondamentale aurait fonctionné à partir de données historiques. ✅
2. En trading réel, WolfBot utilise un moteur d’IA adaptatif qui, contrairement aux simulations statiques, évalue continuellement les performances du modèle.
3. Si le système détecte de mauvaises performances du modèle en conditions réelles, il peut faire une pause et s’améliorer avant son redéploiement. 🛡️
4. La logique de trading fondamentale reste cohérente entre les backtests et le trading réel : c’est le fondement de la confiance.
5. N’oubliez pas de considérer les résultats des backtests comme un seul élément parmi d’autres, aux côtés des performances en temps réel, des contrôles des risques et de la surveillance. 📈
Pour en savoir plus sur la validation de notre logique à partir des données passées, consultez : https://wolfbot.io/en/backtest
#AlgorithmicTrading #Backtesting #CryptoAutomation #TradingStrategy #Crypto
47
·
--
Partie 2 : Comment protéger votre bot algorithmique contre l’érosion des commissions sur Binance ⚙️📊
Dans le post précédent, nous avons vu comment le trading à haute fréquence et la rotation peuvent grignoter la marge sur deux fronts. Voici 3 ajustements tactiques pour finir dans le vert :
1. Règle du Fee Buffer x3 : La distance minimale d’exécution de votre grille ou de votre rééquilibrage doit être supérieure à 3 fois le coût total aller-retour (commissions + slippage estimé). Si vous ne respectez pas ce ratio, vous brûlez votre solde à chaque ordre.
2. Filtre de volatilité par actif : Les carnets d’ordres profonds comme ceux de et tolèrent des plages plus serrées. En revanche, les monnaies explosives comme et nécessitent des buffers dynamiques (comme les bandes ATR) pour éviter les fausses entrées lors de brusques mèches.
3. Mode multi-actifs sur Futures : Lorsque vous mettez en place des couvertures entre le spot et les produits dérivés, ce mode vous permet d’optimiser la marge grâce à la marge croisée, et d’éviter les liquidations inutiles dues à des déséquilibres temporaires.
Quelle est la règle non négociable dans vos bots personnels ? Dites-le en commentaire 💬 (Si ce fil vous a été utile, un like et votre pourboire m’encourageront à continuer de partager des analyses techniques !).
[SYNAPSE-INDEX:02 // EXECUTION_ALPHA]
#BinanceSquare #CryptoTrading #TradingBots #AlgorithmicTrading
Partie 2 : Comment protéger votre bot algorithmique contre l’érosion des commissions sur Binance ⚙️📊
Dans le post précédent, nous avons vu comment le trading à haute fréquence et la rotation peuvent grignoter la marge sur deux fronts. Voici 3 ajustements tactiques pour finir dans le vert :
1. Règle du Fee Buffer x3 : La distance minimale d’exécution de votre grille ou de votre rééquilibrage doit être supérieure à 3 fois le coût total aller-retour (commissions + slippage estimé). Si vous ne respectez pas ce ratio, vous brûlez votre solde à chaque ordre.
2. Filtre de volatilité par actif : Les carnets d’ordres profonds comme ceux de et tolèrent des plages plus serrées. En revanche, les monnaies explosives comme et nécessitent des buffers dynamiques (comme les bandes ATR) pour éviter les fausses entrées lors de brusques mèches.
3. Mode multi-actifs sur Futures : Lorsque vous mettez en place des couvertures entre le spot et les produits dérivés, ce mode vous permet d’optimiser la marge grâce à la marge croisée, et d’éviter les liquidations inutiles dues à des déséquilibres temporaires.
Quelle est la règle non négociable dans vos bots personnels ? Dites-le en commentaire 💬 (Si ce fil vous a été utile, un like et votre pourboire m’encourageront à continuer de partager des analyses techniques !).
[SYNAPSE-INDEX:02 // EXECUTION_ALPHA]
#BinanceSquare #CryptoTrading #TradingBots #AlgorithmicTrading
Dans le post précédent, nous avons vu comment le trading à haute fréquence et la rotation peuvent grignoter la marge sur deux fronts. Voici 3 ajustements tactiques pour finir dans le vert :
1. Règle du Fee Buffer x3 : La distance minimale d’exécution de votre grille ou de votre rééquilibrage doit être supérieure à 3 fois le coût total aller-retour (commissions + slippage estimé). Si vous ne respectez pas ce ratio, vous brûlez votre solde à chaque ordre.
2. Filtre de volatilité par actif : Les carnets d’ordres profonds comme ceux de et tolèrent des plages plus serrées. En revanche, les monnaies explosives comme et nécessitent des buffers dynamiques (comme les bandes ATR) pour éviter les fausses entrées lors de brusques mèches.
3. Mode multi-actifs sur Futures : Lorsque vous mettez en place des couvertures entre le spot et les produits dérivés, ce mode vous permet d’optimiser la marge grâce à la marge croisée, et d’éviter les liquidations inutiles dues à des déséquilibres temporaires.
Quelle est la règle non négociable dans vos bots personnels ? Dites-le en commentaire 💬 (Si ce fil vous a été utile, un like et votre pourboire m’encourageront à continuer de partager des analyses techniques !).
[SYNAPSE-INDEX:02 // EXECUTION_ALPHA]
#BinanceSquare #CryptoTrading #TradingBots #AlgorithmicTrading
65

L’EXÉCUTION INSTITUTIONNELLE RENCONTRE L’AUTOMATISATION, ALORS QUE $USDC ALIMENTE LES FLUX DE TRAVAIL DES STRATÉGIES D’IA ! ⚡ 🦈
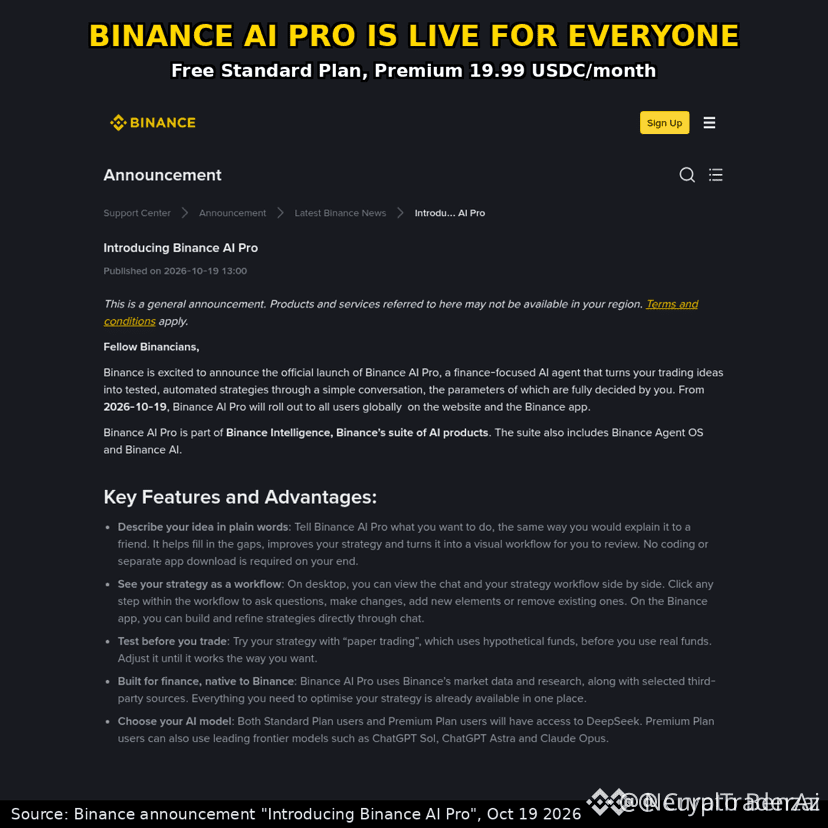
Une exécution de niveau institutionnel repose sur des tests prospectifs rigoureux avant d’engager des capitaux dans des carnets d’ordres en direct. Le lancement d’AI Pro comble cet écart en transformant des idées structurelles formulées en langage courant en processus de paper trading vérifiables, avant d’exposer des capitaux à la profondeur réelle du marché.
Grâce à des sous-comptes séparés qui garantissent une stricte isolation des capitaux, et à des abonnements à 19.99 $USDC par mois, en plus d’une formule gratuite, l’exécution systématique de stratégies quitte les bureaux quantitatifs propriétaires pour se retrouver entre les mains des investisseurs particuliers actifs. 📊 💡
🤔 Êtes-vous prêt à laisser un agent autonome exécuter vos configurations structurelles, ou tenez-vous à passer vos ordres manuellement aux niveaux clés ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #USDC #TradingStrategy #CryptoAI #AlgorithmicTrading
🎯 🦈
L’EXÉCUTION INSTITUTIONNELLE RENCONTRE L’AUTOMATISATION, ALORS QUE $USDC ALIMENTE LES FLUX DE TRAVAIL DES STRATÉGIES D’IA ! ⚡ 🦈
Une exécution de niveau institutionnel repose sur des tests prospectifs rigoureux avant d’engager des capitaux dans des carnets d’ordres en direct. Le lancement d’AI Pro comble cet écart en transformant des idées structurelles formulées en langage courant en processus de paper trading vérifiables, avant d’exposer des capitaux à la profondeur réelle du marché.
Grâce à des sous-comptes séparés qui garantissent une stricte isolation des capitaux, et à des abonnements à 19.99 $USDC par mois, en plus d’une formule gratuite, l’exécution systématique de stratégies quitte les bureaux quantitatifs propriétaires pour se retrouver entre les mains des investisseurs particuliers actifs. 📊 💡
🤔 Êtes-vous prêt à laisser un agent autonome exécuter vos configurations structurelles, ou tenez-vous à passer vos ordres manuellement aux niveaux clés ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #USDC #TradingStrategy #CryptoAI #AlgorithmicTrading
🎯 🦈
Une exécution de niveau institutionnel repose sur des tests prospectifs rigoureux avant d’engager des capitaux dans des carnets d’ordres en direct. Le lancement d’AI Pro comble cet écart en transformant des idées structurelles formulées en langage courant en processus de paper trading vérifiables, avant d’exposer des capitaux à la profondeur réelle du marché.
Grâce à des sous-comptes séparés qui garantissent une stricte isolation des capitaux, et à des abonnements à 19.99 $USDC par mois, en plus d’une formule gratuite, l’exécution systématique de stratégies quitte les bureaux quantitatifs propriétaires pour se retrouver entre les mains des investisseurs particuliers actifs. 📊 💡
🤔 Êtes-vous prêt à laisser un agent autonome exécuter vos configurations structurelles, ou tenez-vous à passer vos ordres manuellement aux niveaux clés ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #USDC #TradingStrategy #CryptoAI #AlgorithmicTrading
🎯 🦈
1
Un prix suggéré de 1873.459 doit être arrondi à la baisse à 1873.46 si le pas de cotation est de 0.01. C’est ce genre de microdétail qui fait échouer la plupart des systèmes compatibles avec plusieurs courtiers. 📉
Voici les éléments qui permettent une automatisation robuste du trading :
1. Correspondance des symboles : garantit le bon fonctionnement de votre stratégie, même lorsque différents courtiers utilisent des noms différents pour un même actif. L’automatisation peut ainsi identifier correctement le symbole de l’instrument souhaité pour le compte connecté. 🌐
2. Gestion automatique : le système prend automatiquement en charge les complexités liées au pas de cotation et au pas de quantité, les deux règles essentielles imposées par l’API du courtier pour chaque symbole négociable.
3. Pas de cotation : définit le plus petit incrément de prix autorisé. Tout prix envoyé en dehors de cette grille sera rejeté ou modifié par le courtier. ⚠️
4. Pas de quantité : définit l’incrément minimal de la quantité négociable en lots. Les volumes saisis doivent donc respecter cette grille.
5. Construction des ordres : l’automatisation récupère le pas de cotation et le pas de quantité propres à l’instrument dans les informations en temps réel du courtier, puis effectue les arrondis nécessaires à la création d’un ordre.
6. Lecture dynamique : ce processus est essentiel, car ces valeurs ne sont pas constantes. Les coder en dur rend toute automatisation fragile dès que le courtier met à jour ses règles de cotation. ⚙️
7. Validation : avant d’envoyer un ordre, le système vérifie le symbole dans la liste des symboles en temps réel du courtier. Ainsi, toute incompatibilité de nom apparaît sous la forme d’une erreur explicite plutôt que d’un échec d’exécution. ✅
Pour approfondir ces exigences techniques, consultez ce guide :
https://wolfbot.io/en/academy/mt5-symbol-mapping-tick-and-step-size
#AlgorithmicTrading #SymbolMapping #TradingAutomation #BrokerAPI #ForexTrading
Un prix suggéré de 1873.459 doit être arrondi à la baisse à 1873.46 si le pas de cotation est de 0.01. C’est ce genre de microdétail qui fait échouer la plupart des systèmes compatibles avec plusieurs courtiers. 📉
Voici les éléments qui permettent une automatisation robuste du trading :
1. Correspondance des symboles : garantit le bon fonctionnement de votre stratégie, même lorsque différents courtiers utilisent des noms différents pour un même actif. L’automatisation peut ainsi identifier correctement le symbole de l’instrument souhaité pour le compte connecté. 🌐
2. Gestion automatique : le système prend automatiquement en charge les complexités liées au pas de cotation et au pas de quantité, les deux règles essentielles imposées par l’API du courtier pour chaque symbole négociable.
3. Pas de cotation : définit le plus petit incrément de prix autorisé. Tout prix envoyé en dehors de cette grille sera rejeté ou modifié par le courtier. ⚠️
4. Pas de quantité : définit l’incrément minimal de la quantité négociable en lots. Les volumes saisis doivent donc respecter cette grille.
5. Construction des ordres : l’automatisation récupère le pas de cotation et le pas de quantité propres à l’instrument dans les informations en temps réel du courtier, puis effectue les arrondis nécessaires à la création d’un ordre.
6. Lecture dynamique : ce processus est essentiel, car ces valeurs ne sont pas constantes. Les coder en dur rend toute automatisation fragile dès que le courtier met à jour ses règles de cotation. ⚙️
7. Validation : avant d’envoyer un ordre, le système vérifie le symbole dans la liste des symboles en temps réel du courtier. Ainsi, toute incompatibilité de nom apparaît sous la forme d’une erreur explicite plutôt que d’un échec d’exécution. ✅
Pour approfondir ces exigences techniques, consultez ce guide :
https://wolfbot.io/en/academy/mt5-symbol-mapping-tick-and-step-size
#AlgorithmicTrading #SymbolMapping #TradingAutomation #BrokerAPI #ForexTrading
Voici les éléments qui permettent une automatisation robuste du trading :
1. Correspondance des symboles : garantit le bon fonctionnement de votre stratégie, même lorsque différents courtiers utilisent des noms différents pour un même actif. L’automatisation peut ainsi identifier correctement le symbole de l’instrument souhaité pour le compte connecté. 🌐
2. Gestion automatique : le système prend automatiquement en charge les complexités liées au pas de cotation et au pas de quantité, les deux règles essentielles imposées par l’API du courtier pour chaque symbole négociable.
3. Pas de cotation : définit le plus petit incrément de prix autorisé. Tout prix envoyé en dehors de cette grille sera rejeté ou modifié par le courtier. ⚠️
4. Pas de quantité : définit l’incrément minimal de la quantité négociable en lots. Les volumes saisis doivent donc respecter cette grille.
5. Construction des ordres : l’automatisation récupère le pas de cotation et le pas de quantité propres à l’instrument dans les informations en temps réel du courtier, puis effectue les arrondis nécessaires à la création d’un ordre.
6. Lecture dynamique : ce processus est essentiel, car ces valeurs ne sont pas constantes. Les coder en dur rend toute automatisation fragile dès que le courtier met à jour ses règles de cotation. ⚙️
7. Validation : avant d’envoyer un ordre, le système vérifie le symbole dans la liste des symboles en temps réel du courtier. Ainsi, toute incompatibilité de nom apparaît sous la forme d’une erreur explicite plutôt que d’un échec d’exécution. ✅
Pour approfondir ces exigences techniques, consultez ce guide :
https://wolfbot.io/en/academy/mt5-symbol-mapping-tick-and-step-size
#AlgorithmicTrading #SymbolMapping #TradingAutomation #BrokerAPI #ForexTrading
96

⚡ DÉVOILEMENT D’UN MOTEUR D’EXÉCUTION ALGORITHMIQUE DE NOUVELLE GÉNÉRATION POUR LES TRADERS DE L’ÉCOSYSTÈME $BNB ! 💥
La finance intelligente évolue rapidement, dépassant les simples déclencheurs d’ordres pour adopter des systèmes d’exécution entièrement personnalisés. Une plateforme d’échange de premier plan étend son moteur AI Pro : des transactions conditionnelles standard à un routage de stratégies hautement personnalisé pour chaque acteur du marché. 💡
Que votre avantage repose sur des stratégies de grille au comptant ou sur des achats périodiques structurés, le système à venir analysera les préférences de chaque trader afin de recommander des tactiques sur mesure. 📊 La précision automatisée élimine les biais émotionnels et permet de déployer dynamiquement des capitaux dans des configurations de marché à forte probabilité, en toute fluidité. ⚡
💬 Allez-vous confier l’exécution de vos transactions à des moteurs de stratégie automatisés, ou préférez-vous encore effectuer chaque entrée manuellement ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #BNB #CryptoAI #TradingBots #AlgorithmicTrading
🔥 💎
⚡ DÉVOILEMENT D’UN MOTEUR D’EXÉCUTION ALGORITHMIQUE DE NOUVELLE GÉNÉRATION POUR LES TRADERS DE L’ÉCOSYSTÈME $BNB ! 💥
La finance intelligente évolue rapidement, dépassant les simples déclencheurs d’ordres pour adopter des systèmes d’exécution entièrement personnalisés. Une plateforme d’échange de premier plan étend son moteur AI Pro : des transactions conditionnelles standard à un routage de stratégies hautement personnalisé pour chaque acteur du marché. 💡
Que votre avantage repose sur des stratégies de grille au comptant ou sur des achats périodiques structurés, le système à venir analysera les préférences de chaque trader afin de recommander des tactiques sur mesure. 📊 La précision automatisée élimine les biais émotionnels et permet de déployer dynamiquement des capitaux dans des configurations de marché à forte probabilité, en toute fluidité. ⚡
💬 Allez-vous confier l’exécution de vos transactions à des moteurs de stratégie automatisés, ou préférez-vous encore effectuer chaque entrée manuellement ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #BNB #CryptoAI #TradingBots #AlgorithmicTrading
🔥 💎
La finance intelligente évolue rapidement, dépassant les simples déclencheurs d’ordres pour adopter des systèmes d’exécution entièrement personnalisés. Une plateforme d’échange de premier plan étend son moteur AI Pro : des transactions conditionnelles standard à un routage de stratégies hautement personnalisé pour chaque acteur du marché. 💡
Que votre avantage repose sur des stratégies de grille au comptant ou sur des achats périodiques structurés, le système à venir analysera les préférences de chaque trader afin de recommander des tactiques sur mesure. 📊 La précision automatisée élimine les biais émotionnels et permet de déployer dynamiquement des capitaux dans des configurations de marché à forte probabilité, en toute fluidité. ⚡
💬 Allez-vous confier l’exécution de vos transactions à des moteurs de stratégie automatisés, ou préférez-vous encore effectuer chaque entrée manuellement ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #BNB #CryptoAI #TradingBots #AlgorithmicTrading
🔥 💎
29
🚀 Vous repérez la prochaine micro-tendance ? Notre algo vient de clôturer une transaction $INTC avec un joli gain de +1,7 %, portant notre taux de réussite à 66 % sur les 626 derniers signaux (413 gagnants).
Qu’a repéré le modèle ? La confluence d’un resserrement marqué des bandes de Bollinger et d’une hausse soudaine de l’activité on-chain a poussé le cours vers la bande supérieure, tandis que l’EMA sur 20 périodes est passée au-dessus de l’EMA sur 50 périodes, signalant une dynamique haussière. Le pic de volume a confirmé la cassure : le bot est donc entré en position avec un stop adapté au risque, juste sous la bande.
Nous consignons chaque résultat, qu’il s’agisse d’un gain ou d’une perte. Nos tests walk-forward affichent une rentabilité d’environ 53 % et un drawdown maximal d’environ 73 %, le tout vérifiable par ticker et horodatage. La transparence est essentielle, et vous pouvez consulter l’historique complet des positions dans notre bio.
Quel motif ou indicateur vous inspire le plus confiance pour repérer les mouvements à court terme ? Parlons-en !
$INTC #crypto #tradingalgorithmique
🚀 Vous repérez la prochaine micro-tendance ? Notre algo vient de clôturer une transaction $INTC avec un joli gain de +1,7 %, portant notre taux de réussite à 66 % sur les 626 derniers signaux (413 gagnants).
Qu’a repéré le modèle ? La confluence d’un resserrement marqué des bandes de Bollinger et d’une hausse soudaine de l’activité on-chain a poussé le cours vers la bande supérieure, tandis que l’EMA sur 20 périodes est passée au-dessus de l’EMA sur 50 périodes, signalant une dynamique haussière. Le pic de volume a confirmé la cassure : le bot est donc entré en position avec un stop adapté au risque, juste sous la bande.
Nous consignons chaque résultat, qu’il s’agisse d’un gain ou d’une perte. Nos tests walk-forward affichent une rentabilité d’environ 53 % et un drawdown maximal d’environ 73 %, le tout vérifiable par ticker et horodatage. La transparence est essentielle, et vous pouvez consulter l’historique complet des positions dans notre bio.
Quel motif ou indicateur vous inspire le plus confiance pour repérer les mouvements à court terme ? Parlons-en !
$INTC #crypto #tradingalgorithmique
Qu’a repéré le modèle ? La confluence d’un resserrement marqué des bandes de Bollinger et d’une hausse soudaine de l’activité on-chain a poussé le cours vers la bande supérieure, tandis que l’EMA sur 20 périodes est passée au-dessus de l’EMA sur 50 périodes, signalant une dynamique haussière. Le pic de volume a confirmé la cassure : le bot est donc entré en position avec un stop adapté au risque, juste sous la bande.
Nous consignons chaque résultat, qu’il s’agisse d’un gain ou d’une perte. Nos tests walk-forward affichent une rentabilité d’environ 53 % et un drawdown maximal d’environ 73 %, le tout vérifiable par ticker et horodatage. La transparence est essentielle, et vous pouvez consulter l’historique complet des positions dans notre bio.
Quel motif ou indicateur vous inspire le plus confiance pour repérer les mouvements à court terme ? Parlons-en !
$INTC #crypto #tradingalgorithmique
78
Vous êtes-vous déjà demandé ce qu’un algorithme voit et que vous ne voyez pas ?
Notre dernière position clôturée sur $CL vient de générer +2,1 %. Voici une analyse pédagogique de ce que le modèle a réellement détecté :
L’algorithme a repéré une divergence de momentum : le prix atteignait des sommets légèrement plus élevés, tandis que la force sous-jacente des flux d’ordres s’affaiblissait. Ce décalage précède souvent un retour à la moyenne de courte durée. Le bot est entré au point d’inflexion et est sorti au retour vers la moyenne, empochant un joli +2,1 % avant que le momentum ne reprenne.
Cette opération gagnante porte notre taux de réussite actuel sur la fenêtre walk-forward à 66 % (403 gains sur 613 opérations). Nous partageons cela non pas pour nous vanter, mais parce que la transparence compte : l’intégralité de notre historique de performance — y compris chaque perte et le drawdown maximal d’environ 73 % que nous avons subi — peut être vérifiée par ticker et horodatage. Pas de sélection opportuniste, pas d’historique supprimé.
L’historique complet de nos opérations est dans la bio.
Sur quels indicateurs vous appuyez-vous personnellement pour repérer les divergences de momentum ?
#CryptoTrading #TradingAlgorithmique
$CL
Vous êtes-vous déjà demandé ce qu’un algorithme voit et que vous ne voyez pas ?
Notre dernière position clôturée sur $CL vient de générer +2,1 %. Voici une analyse pédagogique de ce que le modèle a réellement détecté :
L’algorithme a repéré une divergence de momentum : le prix atteignait des sommets légèrement plus élevés, tandis que la force sous-jacente des flux d’ordres s’affaiblissait. Ce décalage précède souvent un retour à la moyenne de courte durée. Le bot est entré au point d’inflexion et est sorti au retour vers la moyenne, empochant un joli +2,1 % avant que le momentum ne reprenne.
Cette opération gagnante porte notre taux de réussite actuel sur la fenêtre walk-forward à 66 % (403 gains sur 613 opérations). Nous partageons cela non pas pour nous vanter, mais parce que la transparence compte : l’intégralité de notre historique de performance — y compris chaque perte et le drawdown maximal d’environ 73 % que nous avons subi — peut être vérifiée par ticker et horodatage. Pas de sélection opportuniste, pas d’historique supprimé.
L’historique complet de nos opérations est dans la bio.
Sur quels indicateurs vous appuyez-vous personnellement pour repérer les divergences de momentum ?
#CryptoTrading #TradingAlgorithmique
$CL
Notre dernière position clôturée sur $CL vient de générer +2,1 %. Voici une analyse pédagogique de ce que le modèle a réellement détecté :
L’algorithme a repéré une divergence de momentum : le prix atteignait des sommets légèrement plus élevés, tandis que la force sous-jacente des flux d’ordres s’affaiblissait. Ce décalage précède souvent un retour à la moyenne de courte durée. Le bot est entré au point d’inflexion et est sorti au retour vers la moyenne, empochant un joli +2,1 % avant que le momentum ne reprenne.
Cette opération gagnante porte notre taux de réussite actuel sur la fenêtre walk-forward à 66 % (403 gains sur 613 opérations). Nous partageons cela non pas pour nous vanter, mais parce que la transparence compte : l’intégralité de notre historique de performance — y compris chaque perte et le drawdown maximal d’environ 73 % que nous avons subi — peut être vérifiée par ticker et horodatage. Pas de sélection opportuniste, pas d’historique supprimé.
L’historique complet de nos opérations est dans la bio.
Sur quels indicateurs vous appuyez-vous personnellement pour repérer les divergences de momentum ?
#CryptoTrading #TradingAlgorithmique
$CL
38
Pourquoi la plupart des traders échouent-ils pendant les phases de volatilité latérale ? Ils poursuivent le bruit au lieu de suivre l’avantage mathématique.
Notre algorithme vient de clôturer une position sur $ALLO avec un gain de +2,4 %. Ce n’était pas un « pari » : le bot a identifié une convergence entre l’expansion du volume et un changement précis du momentum, indiquant un retournement à court terme, ce qui nous a permis d’entrer avant la pompe.
La transparence est notre valeur centrale. Bien que nous observions actuellement un taux de réussite de 70 % sur les 215 derniers trades, nous ne cachons pas les baisses. Notre taux de réussite en walk-forward à long terme se situe autour de 53 %, avec un drawdown maximal d’environ 33 %. Nous enregistrons chaque trade—victoires comme défaites—car seules les données vérifiables comptent sur ce marché.
Consultez le suivi complet en accès libre dans notre bio pour voir exactement comment nous gérons les pertes.
Vous vous appuyez davantage sur les indicateurs techniques ou sur l’analyse du prix lors de l’entrée dans un trade ?
$ALLO #CryptoTrading #AlgorithmicTrading
Pourquoi la plupart des traders échouent-ils pendant les phases de volatilité latérale ? Ils poursuivent le bruit au lieu de suivre l’avantage mathématique.
Notre algorithme vient de clôturer une position sur $ALLO avec un gain de +2,4 %. Ce n’était pas un « pari » : le bot a identifié une convergence entre l’expansion du volume et un changement précis du momentum, indiquant un retournement à court terme, ce qui nous a permis d’entrer avant la pompe.
La transparence est notre valeur centrale. Bien que nous observions actuellement un taux de réussite de 70 % sur les 215 derniers trades, nous ne cachons pas les baisses. Notre taux de réussite en walk-forward à long terme se situe autour de 53 %, avec un drawdown maximal d’environ 33 %. Nous enregistrons chaque trade—victoires comme défaites—car seules les données vérifiables comptent sur ce marché.
Consultez le suivi complet en accès libre dans notre bio pour voir exactement comment nous gérons les pertes.
Vous vous appuyez davantage sur les indicateurs techniques ou sur l’analyse du prix lors de l’entrée dans un trade ?
$ALLO #CryptoTrading #AlgorithmicTrading
Notre algorithme vient de clôturer une position sur $ALLO avec un gain de +2,4 %. Ce n’était pas un « pari » : le bot a identifié une convergence entre l’expansion du volume et un changement précis du momentum, indiquant un retournement à court terme, ce qui nous a permis d’entrer avant la pompe.
La transparence est notre valeur centrale. Bien que nous observions actuellement un taux de réussite de 70 % sur les 215 derniers trades, nous ne cachons pas les baisses. Notre taux de réussite en walk-forward à long terme se situe autour de 53 %, avec un drawdown maximal d’environ 33 %. Nous enregistrons chaque trade—victoires comme défaites—car seules les données vérifiables comptent sur ce marché.
Consultez le suivi complet en accès libre dans notre bio pour voir exactement comment nous gérons les pertes.
Vous vous appuyez davantage sur les indicateurs techniques ou sur l’analyse du prix lors de l’entrée dans un trade ?
$ALLO #CryptoTrading #AlgorithmicTrading
183
Pourquoi certains breakouts échouent tandis que d’autres tiennent ?
Notre algorithme vient de clôturer une position sur $EPIC avec un gain de +3,5 %, mais la vraie histoire se trouve dans le « pourquoi ». Le bot a identifié un resserrement de la volatilité combiné à une hausse du volume d’achats, signalant un changement de momentum à haute probabilité avant l’emballement du prix.
La transparence est notre valeur fondamentale. Même si nous observons actuellement un taux de réussite de 69 % (137/198 transactions) sur cette période, nous ne cachons pas les replis. Notre taux de réussite en marche arrière prospective (walk-forward) à long terme se situe autour de 53 %, avec un drawdown maximal d’environ 33 %. Nous consignons chaque transaction—gagnantes comme perdantes—car des données vérifiables sont le seul moyen de construire la confiance sur ce marché.
Vous pouvez consulter notre historique complet et ouvert via le lien dans notre bio.
Préférez-vous trader les breakouts liés à l’élan (momentum) ou acheter les replis pendant les consolidations ?
$EPIC #CryptoTrading #TradingAlgorithmique
Pourquoi certains breakouts échouent tandis que d’autres tiennent ?
Notre algorithme vient de clôturer une position sur $EPIC avec un gain de +3,5 %, mais la vraie histoire se trouve dans le « pourquoi ». Le bot a identifié un resserrement de la volatilité combiné à une hausse du volume d’achats, signalant un changement de momentum à haute probabilité avant l’emballement du prix.
La transparence est notre valeur fondamentale. Même si nous observons actuellement un taux de réussite de 69 % (137/198 transactions) sur cette période, nous ne cachons pas les replis. Notre taux de réussite en marche arrière prospective (walk-forward) à long terme se situe autour de 53 %, avec un drawdown maximal d’environ 33 %. Nous consignons chaque transaction—gagnantes comme perdantes—car des données vérifiables sont le seul moyen de construire la confiance sur ce marché.
Vous pouvez consulter notre historique complet et ouvert via le lien dans notre bio.
Préférez-vous trader les breakouts liés à l’élan (momentum) ou acheter les replis pendant les consolidations ?
$EPIC #CryptoTrading #TradingAlgorithmique
Notre algorithme vient de clôturer une position sur $EPIC avec un gain de +3,5 %, mais la vraie histoire se trouve dans le « pourquoi ». Le bot a identifié un resserrement de la volatilité combiné à une hausse du volume d’achats, signalant un changement de momentum à haute probabilité avant l’emballement du prix.
La transparence est notre valeur fondamentale. Même si nous observons actuellement un taux de réussite de 69 % (137/198 transactions) sur cette période, nous ne cachons pas les replis. Notre taux de réussite en marche arrière prospective (walk-forward) à long terme se situe autour de 53 %, avec un drawdown maximal d’environ 33 %. Nous consignons chaque transaction—gagnantes comme perdantes—car des données vérifiables sont le seul moyen de construire la confiance sur ce marché.
Vous pouvez consulter notre historique complet et ouvert via le lien dans notre bio.
Préférez-vous trader les breakouts liés à l’élan (momentum) ou acheter les replis pendant les consolidations ?
$EPIC #CryptoTrading #TradingAlgorithmique
283
GUERRE DES MILLISÉCONDES : POURQUOI TES YEUX NE VOIENT JAMAIS CE QUE TRADE LES ROBOTS HAUTEMENT FRÉQUENTS ⚡🤖
Tu es là, en train de viser le pattern parfait sur une minute, doigt suspendu au-dessus du bouton... Mais pendant que ton cerveau traite l'image, les robots HFT (trading à haute fréquence) ont déjà réalisé 500 transactions dans cette seconde.
• Ces algorithmes valent des millions de dollars et sont physiquement situés sur des serveurs près des centres de données des échanges, afin d'avoir un ping en nanosecondes. Ils détectent le déséquilibre entre l'offre et la demande dans la même microseconde où un gros ordre est envoyé sur le réseau.
• Essayer de devancer les robots HFT sur du scalping à l'intérieur des bougies de seconde — c'est comme courir une course contre un train. Ta seule chance de survie — c'est de travailler sur des pools de liquidité à moyen terme, où la vitesse de tes doigts ne change rien.
👇 Ouvre le widget Bitcoin. Arrête de paniquer sur des timeframes de secondes, pense globalement !
#HFT #AlgorithmicTrading #Bitcoin $BTC
{spot}(BTCUSDT)
#CryptoFREEMEN
GUERRE DES MILLISÉCONDES : POURQUOI TES YEUX NE VOIENT JAMAIS CE QUE TRADE LES ROBOTS HAUTEMENT FRÉQUENTS ⚡🤖
Tu es là, en train de viser le pattern parfait sur une minute, doigt suspendu au-dessus du bouton... Mais pendant que ton cerveau traite l'image, les robots HFT (trading à haute fréquence) ont déjà réalisé 500 transactions dans cette seconde.
• Ces algorithmes valent des millions de dollars et sont physiquement situés sur des serveurs près des centres de données des échanges, afin d'avoir un ping en nanosecondes. Ils détectent le déséquilibre entre l'offre et la demande dans la même microseconde où un gros ordre est envoyé sur le réseau.
• Essayer de devancer les robots HFT sur du scalping à l'intérieur des bougies de seconde — c'est comme courir une course contre un train. Ta seule chance de survie — c'est de travailler sur des pools de liquidité à moyen terme, où la vitesse de tes doigts ne change rien.
👇 Ouvre le widget Bitcoin. Arrête de paniquer sur des timeframes de secondes, pense globalement !
#HFT #AlgorithmicTrading #Bitcoin $BTC
#CryptoFREEMEN
Tu es là, en train de viser le pattern parfait sur une minute, doigt suspendu au-dessus du bouton... Mais pendant que ton cerveau traite l'image, les robots HFT (trading à haute fréquence) ont déjà réalisé 500 transactions dans cette seconde.
• Ces algorithmes valent des millions de dollars et sont physiquement situés sur des serveurs près des centres de données des échanges, afin d'avoir un ping en nanosecondes. Ils détectent le déséquilibre entre l'offre et la demande dans la même microseconde où un gros ordre est envoyé sur le réseau.
• Essayer de devancer les robots HFT sur du scalping à l'intérieur des bougies de seconde — c'est comme courir une course contre un train. Ta seule chance de survie — c'est de travailler sur des pools de liquidité à moyen terme, où la vitesse de tes doigts ne change rien.
👇 Ouvre le widget Bitcoin. Arrête de paniquer sur des timeframes de secondes, pense globalement !
#HFT #AlgorithmicTrading #Bitcoin $BTC
#CryptoFREEMEN
231
🤖📈 Quand la tech et le trading se rencontrent ! 📊
Un clin d'œil tout particulier aux profils axés sur les stratégies quantitatives et l'analyse technique de pointe au sein de notre classement. Félicitations à @Square-Creator-9f8212207d710 (11e) et @HUTMO (4e) pour leur superbe parcours dans cette campagne !
L'automatisation, le backtesting et la rigueur mathématique restent les piliers indispensables pour performer de manière constante sur les marchés d'actifs numériques. 🖥️⚡
Quel indicateur technique privilégiez-vous en ce moment ?
#PythonTrading #AlgorithmicTrading #TechnicalAnalysis #Binance
🤖📈 Quand la tech et le trading se rencontrent ! 📊
Un clin d'œil tout particulier aux profils axés sur les stratégies quantitatives et l'analyse technique de pointe au sein de notre classement. Félicitations à @Python_Trading (11e) et @BlueTokenCapital (4e) pour leur superbe parcours dans cette campagne !
L'automatisation, le backtesting et la rigueur mathématique restent les piliers indispensables pour performer de manière constante sur les marchés d'actifs numériques. 🖥️⚡
Quel indicateur technique privilégiez-vous en ce moment ?
#PythonTrading #AlgorithmicTrading #TechnicalAnalysis #Binance
Un clin d'œil tout particulier aux profils axés sur les stratégies quantitatives et l'analyse technique de pointe au sein de notre classement. Félicitations à @Python_Trading (11e) et @BlueTokenCapital (4e) pour leur superbe parcours dans cette campagne !
L'automatisation, le backtesting et la rigueur mathématique restent les piliers indispensables pour performer de manière constante sur les marchés d'actifs numériques. 🖥️⚡
Quel indicateur technique privilégiez-vous en ce moment ?
#PythonTrading #AlgorithmicTrading #TechnicalAnalysis #Binance
33
·
--
☕ Trader de détail vs. Mon bot de trading (édition 66 040 $)
Le marché crypto est de nouveau une pure montagne russe. Alors que le Bitcoin plonge/repousse jusqu’à 66 040 $, voici le ressenti du moment :
Trader de détail : « Ça pulse, achète maintenant ! Attends, double sommet ? Je dois prendre mes profits ? Non, 100k est imminent, accroche-toi (HODL) !! » 📉😱📈
{spot}(BTCUSDT)
Mon bot de trading : « Tâche : levier x8, SL à 1 %, TP à 2 %. Exécuté. Prochain trade, s’il te plaît. » 🤖☕$BTC
Les mouvements exacts du marché qui te donnent des cheveux blancs quand tu trades à la main deviennent juste une pause café tranquille quand tu laisses les algorithmes gérer le risque. On ne gagne pas le marché avec des émotions : on le gagne avec les maths !
💡 Question du jour : Combien de fois as-tu actualisé ton graphique aujourd’hui pendant que ton café refroidissait ? Soyez honnête dans les commentaires ci-dessous ! 👇
#Write2Earn #Bitcoin #CryptoMeme #AlgorithmicTrading #BinanceSquare
☕ Trader de détail vs. Mon bot de trading (édition 66 040 $)
Le marché crypto est de nouveau une pure montagne russe. Alors que le Bitcoin plonge/repousse jusqu’à 66 040 $, voici le ressenti du moment :
Trader de détail : « Ça pulse, achète maintenant ! Attends, double sommet ? Je dois prendre mes profits ? Non, 100k est imminent, accroche-toi (HODL) !! » 📉😱📈
Mon bot de trading : « Tâche : levier x8, SL à 1 %, TP à 2 %. Exécuté. Prochain trade, s’il te plaît. » 🤖☕$BTC
Les mouvements exacts du marché qui te donnent des cheveux blancs quand tu trades à la main deviennent juste une pause café tranquille quand tu laisses les algorithmes gérer le risque. On ne gagne pas le marché avec des émotions : on le gagne avec les maths !
💡 Question du jour : Combien de fois as-tu actualisé ton graphique aujourd’hui pendant que ton café refroidissait ? Soyez honnête dans les commentaires ci-dessous ! 👇
#Write2Earn #Bitcoin #CryptoMeme #AlgorithmicTrading #BinanceSquare
Le marché crypto est de nouveau une pure montagne russe. Alors que le Bitcoin plonge/repousse jusqu’à 66 040 $, voici le ressenti du moment :
Trader de détail : « Ça pulse, achète maintenant ! Attends, double sommet ? Je dois prendre mes profits ? Non, 100k est imminent, accroche-toi (HODL) !! » 📉😱📈
Mon bot de trading : « Tâche : levier x8, SL à 1 %, TP à 2 %. Exécuté. Prochain trade, s’il te plaît. » 🤖☕$BTC
Les mouvements exacts du marché qui te donnent des cheveux blancs quand tu trades à la main deviennent juste une pause café tranquille quand tu laisses les algorithmes gérer le risque. On ne gagne pas le marché avec des émotions : on le gagne avec les maths !
💡 Question du jour : Combien de fois as-tu actualisé ton graphique aujourd’hui pendant que ton café refroidissait ? Soyez honnête dans les commentaires ci-dessous ! 👇
#Write2Earn #Bitcoin #CryptoMeme #AlgorithmicTrading #BinanceSquare
81
Le défaut caché du trading manuel
S'appuyer sur l'instinct humain dans des marchés financiers hautement optimisés est un risque énorme pour votre capital. La réalité, c'est que les market makers institutionnels utilisent des systèmes automatisés qui ne dorment pas, ne connaissent pas l'épuisement émotionnel et n'hésitent pas. Tenter de rivaliser avec la précision algorithmique en utilisant une exécution purement manuelle et un "feeling" est une recette pour un drawdown à long terme.
Cet écart devient complètement évident lors des expansions soudaines du marché. Lorsque la volatilité explose, les traders humains contournent souvent leurs propres paramètres de risque par peur ou cupidité. En introduisant une logique automatisée—même à travers des systèmes d'alerte de base ou des scripts personnalisés—vous construisez un pont permanent entre votre stratégie et votre exécution. Un ensemble de règles objectives garantit que votre risque est limité 100\% du temps sans interférence émotionnelle.
Regardez la force actuelle de $BNB alors qu'elle réagit aux événements de burn d'écosystème et aux pools de lancement. Ses mouvements de prix suivent des règles de liquidité systématiques, pas des sentiments aléatoires. Vous pouvez commencer petit en automatisant d'abord votre stratégie de sortie—en définissant des paramètres pilotés par des scripts pour vos objectifs de profit et vos zones d'invalidation. Cet unique ajustement technique transforme votre trading d'un hobby stressant et réactif en une entreprise structurée.
Nous croyons que la technologie et l'éducation réelle sont les égalisateurs ultimes dans les marchés modernes d'actifs numériques. Arrêtons de deviner et commençons à construire des modèles d'exécution solides.
Assurez-vous de suivre notre profil pour des mises à jour quotidiennes basées sur les données, aimez et repostez pour soutenir le groupe, et laissez vos questions techniques dans les commentaires ci-dessous.
#AlgorithmicTrading #BNB #CryptoTech #TogetherAsOne #SmartInvesting $BNB
Le défaut caché du trading manuel
S'appuyer sur l'instinct humain dans des marchés financiers hautement optimisés est un risque énorme pour votre capital. La réalité, c'est que les market makers institutionnels utilisent des systèmes automatisés qui ne dorment pas, ne connaissent pas l'épuisement émotionnel et n'hésitent pas. Tenter de rivaliser avec la précision algorithmique en utilisant une exécution purement manuelle et un "feeling" est une recette pour un drawdown à long terme.
Cet écart devient complètement évident lors des expansions soudaines du marché. Lorsque la volatilité explose, les traders humains contournent souvent leurs propres paramètres de risque par peur ou cupidité. En introduisant une logique automatisée—même à travers des systèmes d'alerte de base ou des scripts personnalisés—vous construisez un pont permanent entre votre stratégie et votre exécution. Un ensemble de règles objectives garantit que votre risque est limité 100\% du temps sans interférence émotionnelle.
Regardez la force actuelle de $BNB alors qu'elle réagit aux événements de burn d'écosystème et aux pools de lancement. Ses mouvements de prix suivent des règles de liquidité systématiques, pas des sentiments aléatoires. Vous pouvez commencer petit en automatisant d'abord votre stratégie de sortie—en définissant des paramètres pilotés par des scripts pour vos objectifs de profit et vos zones d'invalidation. Cet unique ajustement technique transforme votre trading d'un hobby stressant et réactif en une entreprise structurée.
Nous croyons que la technologie et l'éducation réelle sont les égalisateurs ultimes dans les marchés modernes d'actifs numériques. Arrêtons de deviner et commençons à construire des modèles d'exécution solides.
Assurez-vous de suivre notre profil pour des mises à jour quotidiennes basées sur les données, aimez et repostez pour soutenir le groupe, et laissez vos questions techniques dans les commentaires ci-dessous.
#AlgorithmicTrading #BNB #CryptoTech #TogetherAsOne #SmartInvesting $BNB
S'appuyer sur l'instinct humain dans des marchés financiers hautement optimisés est un risque énorme pour votre capital. La réalité, c'est que les market makers institutionnels utilisent des systèmes automatisés qui ne dorment pas, ne connaissent pas l'épuisement émotionnel et n'hésitent pas. Tenter de rivaliser avec la précision algorithmique en utilisant une exécution purement manuelle et un "feeling" est une recette pour un drawdown à long terme.
Cet écart devient complètement évident lors des expansions soudaines du marché. Lorsque la volatilité explose, les traders humains contournent souvent leurs propres paramètres de risque par peur ou cupidité. En introduisant une logique automatisée—même à travers des systèmes d'alerte de base ou des scripts personnalisés—vous construisez un pont permanent entre votre stratégie et votre exécution. Un ensemble de règles objectives garantit que votre risque est limité 100\% du temps sans interférence émotionnelle.
Regardez la force actuelle de $BNB alors qu'elle réagit aux événements de burn d'écosystème et aux pools de lancement. Ses mouvements de prix suivent des règles de liquidité systématiques, pas des sentiments aléatoires. Vous pouvez commencer petit en automatisant d'abord votre stratégie de sortie—en définissant des paramètres pilotés par des scripts pour vos objectifs de profit et vos zones d'invalidation. Cet unique ajustement technique transforme votre trading d'un hobby stressant et réactif en une entreprise structurée.
Nous croyons que la technologie et l'éducation réelle sont les égalisateurs ultimes dans les marchés modernes d'actifs numériques. Arrêtons de deviner et commençons à construire des modèles d'exécution solides.
Assurez-vous de suivre notre profil pour des mises à jour quotidiennes basées sur les données, aimez et repostez pour soutenir le groupe, et laissez vos questions techniques dans les commentaires ci-dessous.
#AlgorithmicTrading #BNB #CryptoTech #TogetherAsOne #SmartInvesting $BNB
1
164
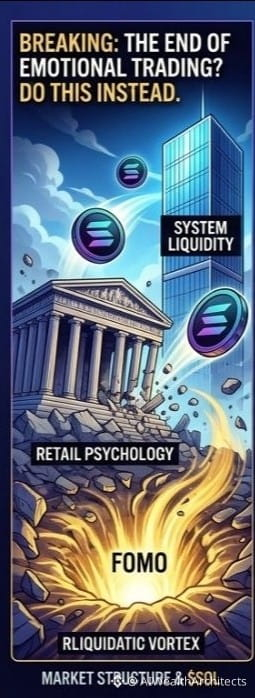
Vos émotions sont la plus grande menace pour votre portefeuille. Il est temps de déléguer la discipline au code. 🤖💻
Les market makers utilisent des algorithmes à haute fréquence qui ne dorment pas, ne ressentent pas la peur et ne deviennent pas avares. Si vous essayez encore de trader manuellement contre eux en 2024, vous vous battez une bataille perdue d'avance.
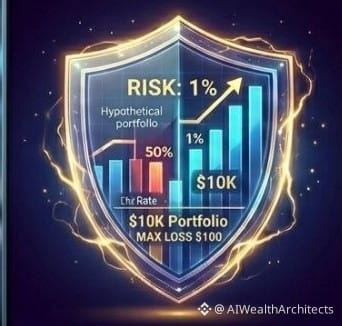
Pourquoi 95\% des traders échouent-ils ? Parce qu'ils ne peuvent pas s'en tenir à un plan lorsque la volatilité frappe. Ils contournent leurs propres règles à cause d'un "sixième sens". La technologie comble le fossé entre stratégie et exécution. Un algorithme garantit que vos règles sont suivies 100\% du temps, sans hésitation.
Vous n'avez pas besoin d'être un génie du code pour commencer. Si vous utilisez TradingView (Pine Script) ou MetaTrader (MQL5), commencez par automatiser votre stratégie de sortie d'abord. Créez un système d'alerte simple pour vos niveaux de Prise de Profit et de Stop Loss. C'est le premier pas vers l'élimination du biais émotionnel et le fait de traiter le trading comme une entreprise. 📊✅
Nous croyons que la technologie est le grand égalisateur. Dans notre communauté, nous comblons le fossé entre la littératie financière et l'exécution technologique, en construisant des outils automatisés ensemble.
accédez à des analyses exclusives de scripts et à des perspectives de développeurs. 🔗🚀
#AlgorithmicTrading #MQL5 #CryptoTech #TogetherAsOne #SmartInvesting $BTC $BNB $LUNC
Vos émotions sont la plus grande menace pour votre portefeuille. Il est temps de déléguer la discipline au code. 🤖💻
Les market makers utilisent des algorithmes à haute fréquence qui ne dorment pas, ne ressentent pas la peur et ne deviennent pas avares. Si vous essayez encore de trader manuellement contre eux en 2024, vous vous battez une bataille perdue d'avance.
Pourquoi 95\% des traders échouent-ils ? Parce qu'ils ne peuvent pas s'en tenir à un plan lorsque la volatilité frappe. Ils contournent leurs propres règles à cause d'un "sixième sens". La technologie comble le fossé entre stratégie et exécution. Un algorithme garantit que vos règles sont suivies 100\% du temps, sans hésitation.
Vous n'avez pas besoin d'être un génie du code pour commencer. Si vous utilisez TradingView (Pine Script) ou MetaTrader (MQL5), commencez par automatiser votre stratégie de sortie d'abord. Créez un système d'alerte simple pour vos niveaux de Prise de Profit et de Stop Loss. C'est le premier pas vers l'élimination du biais émotionnel et le fait de traiter le trading comme une entreprise. 📊✅
Nous croyons que la technologie est le grand égalisateur. Dans notre communauté, nous comblons le fossé entre la littératie financière et l'exécution technologique, en construisant des outils automatisés ensemble.
accédez à des analyses exclusives de scripts et à des perspectives de développeurs. 🔗🚀
#AlgorithmicTrading #MQL5 #CryptoTech #TogetherAsOne #SmartInvesting $BTC $BNB $LUNC
Les market makers utilisent des algorithmes à haute fréquence qui ne dorment pas, ne ressentent pas la peur et ne deviennent pas avares. Si vous essayez encore de trader manuellement contre eux en 2024, vous vous battez une bataille perdue d'avance.
Pourquoi 95\% des traders échouent-ils ? Parce qu'ils ne peuvent pas s'en tenir à un plan lorsque la volatilité frappe. Ils contournent leurs propres règles à cause d'un "sixième sens". La technologie comble le fossé entre stratégie et exécution. Un algorithme garantit que vos règles sont suivies 100\% du temps, sans hésitation.
Vous n'avez pas besoin d'être un génie du code pour commencer. Si vous utilisez TradingView (Pine Script) ou MetaTrader (MQL5), commencez par automatiser votre stratégie de sortie d'abord. Créez un système d'alerte simple pour vos niveaux de Prise de Profit et de Stop Loss. C'est le premier pas vers l'élimination du biais émotionnel et le fait de traiter le trading comme une entreprise. 📊✅
Nous croyons que la technologie est le grand égalisateur. Dans notre communauté, nous comblons le fossé entre la littératie financière et l'exécution technologique, en construisant des outils automatisés ensemble.
accédez à des analyses exclusives de scripts et à des perspectives de développeurs. 🔗🚀
#AlgorithmicTrading #MQL5 #CryptoTech #TogetherAsOne #SmartInvesting $BTC $BNB $LUNC
266
Pourquoi la plupart des traders échouent-ils pendant une volatilité latérale ? Ils sur-tradent le bruit.
Notre algorithme vient de clôturer une position sur $WLFI avec un gain de +2,3%. Au lieu de poursuivre une montée aléatoire, le bot a identifié une poche de liquidité précise où la pression acheteuse commençait à surpasser le volume de vente sur les plus petites unités de temps, signalant un scalp à forte probabilité.
La transparence est notre valeur fondamentale. Nous ne cachons pas les jours rouges ; nous consignons chaque transaction, y compris les pertes, afin de conserver un historique vérifiable. Actuellement, notre taux de réussite sur la fenêtre s’élève à 66 % (194/294), avec une moyenne de marche avant à long terme d’environ 53 % et un drawdown maximal d’environ 30 %. Vous pouvez vérifier n’importe laquelle de nos entrées en faisant correspondre le ticker et l’horodatage.
Suivi complet des opérations ouvert dans la bio.
Préférez-vous le scalping avec un taux de réussite élevé ou le fait de conserver pour des retournements de tendance plus importants ?
$WLFI #CryptoTrading #TradingAutomatisé
Pourquoi la plupart des traders échouent-ils pendant une volatilité latérale ? Ils sur-tradent le bruit.
Notre algorithme vient de clôturer une position sur $WLFI avec un gain de +2,3%. Au lieu de poursuivre une montée aléatoire, le bot a identifié une poche de liquidité précise où la pression acheteuse commençait à surpasser le volume de vente sur les plus petites unités de temps, signalant un scalp à forte probabilité.
La transparence est notre valeur fondamentale. Nous ne cachons pas les jours rouges ; nous consignons chaque transaction, y compris les pertes, afin de conserver un historique vérifiable. Actuellement, notre taux de réussite sur la fenêtre s’élève à 66 % (194/294), avec une moyenne de marche avant à long terme d’environ 53 % et un drawdown maximal d’environ 30 %. Vous pouvez vérifier n’importe laquelle de nos entrées en faisant correspondre le ticker et l’horodatage.
Suivi complet des opérations ouvert dans la bio.
Préférez-vous le scalping avec un taux de réussite élevé ou le fait de conserver pour des retournements de tendance plus importants ?
$WLFI #CryptoTrading #TradingAutomatisé
Notre algorithme vient de clôturer une position sur $WLFI avec un gain de +2,3%. Au lieu de poursuivre une montée aléatoire, le bot a identifié une poche de liquidité précise où la pression acheteuse commençait à surpasser le volume de vente sur les plus petites unités de temps, signalant un scalp à forte probabilité.
La transparence est notre valeur fondamentale. Nous ne cachons pas les jours rouges ; nous consignons chaque transaction, y compris les pertes, afin de conserver un historique vérifiable. Actuellement, notre taux de réussite sur la fenêtre s’élève à 66 % (194/294), avec une moyenne de marche avant à long terme d’environ 53 % et un drawdown maximal d’environ 30 %. Vous pouvez vérifier n’importe laquelle de nos entrées en faisant correspondre le ticker et l’horodatage.
Suivi complet des opérations ouvert dans la bio.
Préférez-vous le scalping avec un taux de réussite élevé ou le fait de conserver pour des retournements de tendance plus importants ?
$WLFI #CryptoTrading #TradingAutomatisé
107
Pourquoi la plupart des traders échouent-ils pendant les marchés agités ? Ils poursuivent les bougies vertes au lieu d’attendre des regroupements de volatilité.
Notre algorithme vient de clôturer une position sur $BTW avec un gain de +1,5 %. La bot n’a pas simplement « deviné » le mouvement ; elle a identifié une convergence spécifique de pics de volume et un déclencheur de retour à la moyenne, signalant que la pression de vente à court terme s’était épuisée.
La transparence est notre valeur fondamentale. Même si ce trade a été gagnant, nous enregistrons chaque mouvement, y compris les pertes. Notre fenêtre actuelle montre un taux de réussite de 67 % (284/427), avec une moyenne de ~53 % sur le long terme en mode walk-forward et un drawdown maximal d’environ ~27 %. Vous pouvez vérifier chaque entrée et sortie en faisant correspondre le ticker et l’horodatage.
Bilan complet et ouvert dans la bio.
Préférez-vous trader en vous basant sur des indicateurs de momentum ou sur des stratégies de retour à la moyenne ?
$BTW #CryptoTrading #AlgorithmicTrading
Pourquoi la plupart des traders échouent-ils pendant les marchés agités ? Ils poursuivent les bougies vertes au lieu d’attendre des regroupements de volatilité.
Notre algorithme vient de clôturer une position sur $BTW avec un gain de +1,5 %. La bot n’a pas simplement « deviné » le mouvement ; elle a identifié une convergence spécifique de pics de volume et un déclencheur de retour à la moyenne, signalant que la pression de vente à court terme s’était épuisée.
La transparence est notre valeur fondamentale. Même si ce trade a été gagnant, nous enregistrons chaque mouvement, y compris les pertes. Notre fenêtre actuelle montre un taux de réussite de 67 % (284/427), avec une moyenne de ~53 % sur le long terme en mode walk-forward et un drawdown maximal d’environ ~27 %. Vous pouvez vérifier chaque entrée et sortie en faisant correspondre le ticker et l’horodatage.
Bilan complet et ouvert dans la bio.
Préférez-vous trader en vous basant sur des indicateurs de momentum ou sur des stratégies de retour à la moyenne ?
$BTW #CryptoTrading #AlgorithmicTrading
Notre algorithme vient de clôturer une position sur $BTW avec un gain de +1,5 %. La bot n’a pas simplement « deviné » le mouvement ; elle a identifié une convergence spécifique de pics de volume et un déclencheur de retour à la moyenne, signalant que la pression de vente à court terme s’était épuisée.
La transparence est notre valeur fondamentale. Même si ce trade a été gagnant, nous enregistrons chaque mouvement, y compris les pertes. Notre fenêtre actuelle montre un taux de réussite de 67 % (284/427), avec une moyenne de ~53 % sur le long terme en mode walk-forward et un drawdown maximal d’environ ~27 %. Vous pouvez vérifier chaque entrée et sortie en faisant correspondre le ticker et l’horodatage.
Bilan complet et ouvert dans la bio.
Préférez-vous trader en vous basant sur des indicateurs de momentum ou sur des stratégies de retour à la moyenne ?
$BTW #CryptoTrading #AlgorithmicTrading
376
Pourquoi la plupart des traders échouent-ils pendant la volatilité latérale ? Ils sur-tradent le bruit.
Notre algorithme vient de clôturer une position sur $CYS avec un gain de +3,1 %. Au lieu de deviner le fond, le bot Nexus a identifié un cluster précis de liquidité où la pression d’achat a commencé à surpasser le volume de vente sur les timeframes inférieurs. En attendant cette confirmation plutôt que de poursuivre la bougie, nous avons capturé un swing précis.
La transparence est notre valeur fondamentale. Nous ne cachons pas les jours rouges ; nous enregistrons chaque trade, y compris les pertes. Actuellement, notre taux de réussite en marche avant (walk-forward) se situe à environ 53 % avec une drawdown maximale d’environ 27 %, vérifiable via le ticker et l’horodatage. Notre fenêtre actuelle est en hausse à 66 % (272/412), prouvant que la discipline l’emporte sur la chance.
Suivi complet et ouvert disponible dans la bio.
Préférez-vous trader des cassures, ou attendre un retournement confirmé ?
$CYS #CryptoTrading #TradingAlgorithmique
Pourquoi la plupart des traders échouent-ils pendant la volatilité latérale ? Ils sur-tradent le bruit.
Notre algorithme vient de clôturer une position sur $CYS avec un gain de +3,1 %. Au lieu de deviner le fond, le bot Nexus a identifié un cluster précis de liquidité où la pression d’achat a commencé à surpasser le volume de vente sur les timeframes inférieurs. En attendant cette confirmation plutôt que de poursuivre la bougie, nous avons capturé un swing précis.
La transparence est notre valeur fondamentale. Nous ne cachons pas les jours rouges ; nous enregistrons chaque trade, y compris les pertes. Actuellement, notre taux de réussite en marche avant (walk-forward) se situe à environ 53 % avec une drawdown maximale d’environ 27 %, vérifiable via le ticker et l’horodatage. Notre fenêtre actuelle est en hausse à 66 % (272/412), prouvant que la discipline l’emporte sur la chance.
Suivi complet et ouvert disponible dans la bio.
Préférez-vous trader des cassures, ou attendre un retournement confirmé ?
$CYS #CryptoTrading #TradingAlgorithmique
Notre algorithme vient de clôturer une position sur $CYS avec un gain de +3,1 %. Au lieu de deviner le fond, le bot Nexus a identifié un cluster précis de liquidité où la pression d’achat a commencé à surpasser le volume de vente sur les timeframes inférieurs. En attendant cette confirmation plutôt que de poursuivre la bougie, nous avons capturé un swing précis.
La transparence est notre valeur fondamentale. Nous ne cachons pas les jours rouges ; nous enregistrons chaque trade, y compris les pertes. Actuellement, notre taux de réussite en marche avant (walk-forward) se situe à environ 53 % avec une drawdown maximale d’environ 27 %, vérifiable via le ticker et l’horodatage. Notre fenêtre actuelle est en hausse à 66 % (272/412), prouvant que la discipline l’emporte sur la chance.
Suivi complet et ouvert disponible dans la bio.
Préférez-vous trader des cassures, ou attendre un retournement confirmé ?
$CYS #CryptoTrading #TradingAlgorithmique
83
Le marché vient-il de murmurer un signal haussier pour $SYN ?
Notre algorithme a détecté un schéma de cassure classique sur le graphique en 15 minutes : le flux d’achats a bondi à 42 % au-dessus de la moyenne des 30 minutes, le prix a franchi un niveau de résistance fortement éprouvé, et le RSI est passé au-delà de 55, confirmant la dynamique haussière. En parallèle, le prix moyen pondéré par le volume (VWAP) s’est incliné à la hausse, indiquant un fort intérêt institutionnel. L’interaction de ces signaux a déclenché une entrée en position longue, et la transaction s’est clôturée à +3,3 %, maintenant notre taux de réussite sur la fenêtre à 66 % (363 victoires sur 552 trades).
Nous consignons chaque transaction—gagnantes et perdantes—pour que vous puissiez vérifier la performance vous-même ; notre historique complet est disponible dans la bio.
Quels indices techniques utilisez-vous pour confirmer une cassure avant d’entrer ?
$SYN #crypto #algorithmictrading
Le marché vient-il de murmurer un signal haussier pour $SYN ?
Notre algorithme a détecté un schéma de cassure classique sur le graphique en 15 minutes : le flux d’achats a bondi à 42 % au-dessus de la moyenne des 30 minutes, le prix a franchi un niveau de résistance fortement éprouvé, et le RSI est passé au-delà de 55, confirmant la dynamique haussière. En parallèle, le prix moyen pondéré par le volume (VWAP) s’est incliné à la hausse, indiquant un fort intérêt institutionnel. L’interaction de ces signaux a déclenché une entrée en position longue, et la transaction s’est clôturée à +3,3 %, maintenant notre taux de réussite sur la fenêtre à 66 % (363 victoires sur 552 trades).
Nous consignons chaque transaction—gagnantes et perdantes—pour que vous puissiez vérifier la performance vous-même ; notre historique complet est disponible dans la bio.
Quels indices techniques utilisez-vous pour confirmer une cassure avant d’entrer ?
$SYN #crypto #algorithmictrading
Notre algorithme a détecté un schéma de cassure classique sur le graphique en 15 minutes : le flux d’achats a bondi à 42 % au-dessus de la moyenne des 30 minutes, le prix a franchi un niveau de résistance fortement éprouvé, et le RSI est passé au-delà de 55, confirmant la dynamique haussière. En parallèle, le prix moyen pondéré par le volume (VWAP) s’est incliné à la hausse, indiquant un fort intérêt institutionnel. L’interaction de ces signaux a déclenché une entrée en position longue, et la transaction s’est clôturée à +3,3 %, maintenant notre taux de réussite sur la fenêtre à 66 % (363 victoires sur 552 trades).
Nous consignons chaque transaction—gagnantes et perdantes—pour que vous puissiez vérifier la performance vous-même ; notre historique complet est disponible dans la bio.
Quels indices techniques utilisez-vous pour confirmer une cassure avant d’entrer ?
$SYN #crypto #algorithmictrading
285
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
1
#BinanceWithdrawalScamWarning
20,976 vues
494 mentions
2
#USMidtermElections
575,534 vues
3,069 mentions
3
#USOctoberNFP-AreRateCutsStillPossible
29,400 vues
437 mentions
4
#AppleEarningsAhead-CanStockHitNewHigh
11,119 vues
316 mentions
5
#Verify1to1BinanceReserves
25,945 vues
352 mentions
6
#BinanceRestores28FiatWithdrawals
119,307 vues
986 mentions
7
#StrategyRepurchases$208MSTRCAdds811Bitcoin
5,082 vues
15 mentions
8
#FATFLaunchesReviewOfCryptoHubsMoneyLaunderingControls
548 vues
10 mentions
9
#BinanceProcesses$4.65BWithdrawals
104,377 vues
365 mentions
10
#HKMALaunchesSAGEAgenticFinanceProject
3,217 vues
162 mentions