
Alpha Batcher
609 Beiträge
Alpha Batcher
 Square Verified
Melden
Nutzer blockieren
Writing about AI & building agents | X App: alphabatcher | Follow for alpha
36 Following
46.4K+ Follower
13.8K+ Like gegeben
Beiträge
Alle
Zitierungen
Videos
2/2
"Erhöhe mein Codex-Kontextfenster auf das Maximum, das von meinem aktuell ausgewählten Modell, Konto und Client unterstützt wird.
Prüfe die aktive Benutzerkonfiguration und berücksichtige dabei CODEX_HOME sowie alle wirksamen Profil- oder Projektüberschreibungen.
Ermittle das ausgewählte Modell und überprüfe dessen client-spezifisches Maximum anhand aktueller, maßgeblicher Modelldaten.
Unterscheide zwischen context_window als Standardwert und max_context_window.
Gehe nicht von 1M aus und verwende 872000 nicht als fest kodierten Wert.
Wenn sich das Maximum nicht verifizieren lässt, ändere die Einstellung nicht und erkläre dies.
Erstelle von jeder Datei, die du bearbeitest, eine Sicherungskopie.
Bewahre alle nicht betroffenen Einstellungen, Zugangsdaten, den Anbieter, das Modell, die Geschwindigkeit, den Reasoning-Aufwand, die Sichtbarkeit von Ultra und die Berechtigungsrichtlinien.
Gib niemals Geheimnisse aus.
Setze model_context_window auf das verifizierte Maximum im passenden Konfigurationsbereich.
In der Benutzerkonfiguration muss es ein Schlüssel der obersten Ebene vor dem ersten Abschnitt sein.
Aktualisiere einen vorhandenen Schlüssel, statt ihn zu duplizieren.
Prüfe auf Überschreibungen mit höherer Priorität und beachte verwaltete Richtlinien.
Lasse die automatische Komprimierung aktiviert.
Melde einen bereits vorhandenen expliziten Komprimierungsschwellenwert separat, statt einen neuen zu erfinden.
Ändere keine Modellkataloge und umgehe keine Beschränkungen.
Validiere die Konfiguration und überprüfe, dass nur die vorgesehenen Einstellungen geändert wurden.
Starte die App nicht neu und unterbrich keine laufenden Aufgaben.
Melde den Speicherort der Sicherungskopie, die genauen Änderungen und das voraussichtlich nutzbare Kontextfenster.
Verwende effective_context_window_percent, sofern die Metadaten diesen Wert enthalten.
Gib Anweisungen zum Neustart und zur Überprüfung.
Unterscheide zwischen der gespeicherten Einstellung und dem tatsächlichen Limit, das ein laufender Chat meldet."
---------------------------
Wenn deine aktiven Aufgaben abgeschlossen sind, beende die App vollständig und öffne sie erneut. Überprüfe anschließend die Kontextanzeige.
Falls ein bestehender Chat weiterhin sein altes Limit anzeigt, überprüfe einen neuen Chat.
Teil 1: https://www.binance.com/square/post/384311051937037
2/2
"Erhöhe mein Codex-Kontextfenster auf das Maximum, das von meinem aktuell ausgewählten Modell, Konto und Client unterstützt wird.
Prüfe die aktive Benutzerkonfiguration und berücksichtige dabei CODEX_HOME sowie alle wirksamen Profil- oder Projektüberschreibungen.
Ermittle das ausgewählte Modell und überprüfe dessen client-spezifisches Maximum anhand aktueller, maßgeblicher Modelldaten.
Unterscheide zwischen context_window als Standardwert und max_context_window.
Gehe nicht von 1M aus und verwende 872000 nicht als fest kodierten Wert.
Wenn sich das Maximum nicht verifizieren lässt, ändere die Einstellung nicht und erkläre dies.
Erstelle von jeder Datei, die du bearbeitest, eine Sicherungskopie.
Bewahre alle nicht betroffenen Einstellungen, Zugangsdaten, den Anbieter, das Modell, die Geschwindigkeit, den Reasoning-Aufwand, die Sichtbarkeit von Ultra und die Berechtigungsrichtlinien.
Gib niemals Geheimnisse aus.
Setze model_context_window auf das verifizierte Maximum im passenden Konfigurationsbereich.
In der Benutzerkonfiguration muss es ein Schlüssel der obersten Ebene vor dem ersten Abschnitt sein.
Aktualisiere einen vorhandenen Schlüssel, statt ihn zu duplizieren.
Prüfe auf Überschreibungen mit höherer Priorität und beachte verwaltete Richtlinien.
Lasse die automatische Komprimierung aktiviert.
Melde einen bereits vorhandenen expliziten Komprimierungsschwellenwert separat, statt einen neuen zu erfinden.
Ändere keine Modellkataloge und umgehe keine Beschränkungen.
Validiere die Konfiguration und überprüfe, dass nur die vorgesehenen Einstellungen geändert wurden.
Starte die App nicht neu und unterbrich keine laufenden Aufgaben.
Melde den Speicherort der Sicherungskopie, die genauen Änderungen und das voraussichtlich nutzbare Kontextfenster.
Verwende effective_context_window_percent, sofern die Metadaten diesen Wert enthalten.
Gib Anweisungen zum Neustart und zur Überprüfung.
Unterscheide zwischen der gespeicherten Einstellung und dem tatsächlichen Limit, das ein laufender Chat meldet."
---------------------------
Wenn deine aktiven Aufgaben abgeschlossen sind, beende die App vollständig und öffne sie erneut. Überprüfe anschließend die Kontextanzeige.
Falls ein bestehender Chat weiterhin sein altes Limit anzeigt, überprüfe einen neuen Chat.
Teil 1: https://www.binance.com/square/post/384311051937037
"Erhöhe mein Codex-Kontextfenster auf das Maximum, das von meinem aktuell ausgewählten Modell, Konto und Client unterstützt wird.
Prüfe die aktive Benutzerkonfiguration und berücksichtige dabei CODEX_HOME sowie alle wirksamen Profil- oder Projektüberschreibungen.
Ermittle das ausgewählte Modell und überprüfe dessen client-spezifisches Maximum anhand aktueller, maßgeblicher Modelldaten.
Unterscheide zwischen context_window als Standardwert und max_context_window.
Gehe nicht von 1M aus und verwende 872000 nicht als fest kodierten Wert.
Wenn sich das Maximum nicht verifizieren lässt, ändere die Einstellung nicht und erkläre dies.
Erstelle von jeder Datei, die du bearbeitest, eine Sicherungskopie.
Bewahre alle nicht betroffenen Einstellungen, Zugangsdaten, den Anbieter, das Modell, die Geschwindigkeit, den Reasoning-Aufwand, die Sichtbarkeit von Ultra und die Berechtigungsrichtlinien.
Gib niemals Geheimnisse aus.
Setze model_context_window auf das verifizierte Maximum im passenden Konfigurationsbereich.
In der Benutzerkonfiguration muss es ein Schlüssel der obersten Ebene vor dem ersten Abschnitt sein.
Aktualisiere einen vorhandenen Schlüssel, statt ihn zu duplizieren.
Prüfe auf Überschreibungen mit höherer Priorität und beachte verwaltete Richtlinien.
Lasse die automatische Komprimierung aktiviert.
Melde einen bereits vorhandenen expliziten Komprimierungsschwellenwert separat, statt einen neuen zu erfinden.
Ändere keine Modellkataloge und umgehe keine Beschränkungen.
Validiere die Konfiguration und überprüfe, dass nur die vorgesehenen Einstellungen geändert wurden.
Starte die App nicht neu und unterbrich keine laufenden Aufgaben.
Melde den Speicherort der Sicherungskopie, die genauen Änderungen und das voraussichtlich nutzbare Kontextfenster.
Verwende effective_context_window_percent, sofern die Metadaten diesen Wert enthalten.
Gib Anweisungen zum Neustart und zur Überprüfung.
Unterscheide zwischen der gespeicherten Einstellung und dem tatsächlichen Limit, das ein laufender Chat meldet."
---------------------------
Wenn deine aktiven Aufgaben abgeschlossen sind, beende die App vollständig und öffne sie erneut. Überprüfe anschließend die Kontextanzeige.
Falls ein bestehender Chat weiterhin sein altes Limit anzeigt, überprüfe einen neuen Chat.
Teil 1: https://www.binance.com/square/post/384311051937037
1
165
1/2
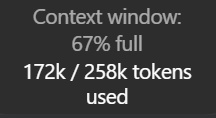
Ich dachte, ich hätte in Codex ein Kontextfenster von 1 Mio.
Dann fiel mir auf, dass in meinem Astra-Chat 172k von 258k als verwendet angezeigt wurden.
In Astras API-Spezifikation sind zwar 1,05 Mio. Tokens angegeben, aber Codex kann standardmäßig ein kleineres Kontextfenster verwenden.
In meiner Konfiguration waren standardmäßig 272.000 Tokens eingestellt.
Mit dem Faktor von 95 % für das nutzbare Kontextfenster des Clients erklärt das die in der App angezeigten 258k.
Das Maximum in meinem lokalen Modellkatalog lag bei 872.000 Tokens, was etwa 828k nutzbaren Tokens entspricht.
In deiner Konfiguration kann ein anderes Limit gelten. Daher lohnt es sich, Codex erst prüfen zu lassen, bevor du es änderst.
Ein Nachteil: Wenn mehr Verlauf im aktiven Kontext bleibt, kann das mehr von deinem Kontingent verbrauchen.
Allein durch das Anheben des Limits wird nicht jede Anfrage das gesamte Kontextfenster ausschöpfen.
Wenn du bei Codex über ChatGPT angemeldet bist, gibt es keinen separaten Multiplikator für lange Kontexte, aber die Verarbeitung von mehr Tokens wird trotzdem angerechnet.
Wenn du deinen eigenen API-Schlüssel verwendest, gelten die API-Preise.
Wenn du das größte von deiner Konfiguration unterstützte Kontextfenster möchtest, füge Folgendes in Codex ein:
---------------------------
1/2
Ich dachte, ich hätte in Codex ein Kontextfenster von 1 Mio.
Dann fiel mir auf, dass in meinem Astra-Chat 172k von 258k als verwendet angezeigt wurden.
In Astras API-Spezifikation sind zwar 1,05 Mio. Tokens angegeben, aber Codex kann standardmäßig ein kleineres Kontextfenster verwenden.
In meiner Konfiguration waren standardmäßig 272.000 Tokens eingestellt.
Mit dem Faktor von 95 % für das nutzbare Kontextfenster des Clients erklärt das die in der App angezeigten 258k.
Das Maximum in meinem lokalen Modellkatalog lag bei 872.000 Tokens, was etwa 828k nutzbaren Tokens entspricht.
In deiner Konfiguration kann ein anderes Limit gelten. Daher lohnt es sich, Codex erst prüfen zu lassen, bevor du es änderst.
Ein Nachteil: Wenn mehr Verlauf im aktiven Kontext bleibt, kann das mehr von deinem Kontingent verbrauchen.
Allein durch das Anheben des Limits wird nicht jede Anfrage das gesamte Kontextfenster ausschöpfen.
Wenn du bei Codex über ChatGPT angemeldet bist, gibt es keinen separaten Multiplikator für lange Kontexte, aber die Verarbeitung von mehr Tokens wird trotzdem angerechnet.
Wenn du deinen eigenen API-Schlüssel verwendest, gelten die API-Preise.
Wenn du das größte von deiner Konfiguration unterstützte Kontextfenster möchtest, füge Folgendes in Codex ein:
---------------------------
Ich dachte, ich hätte in Codex ein Kontextfenster von 1 Mio.
Dann fiel mir auf, dass in meinem Astra-Chat 172k von 258k als verwendet angezeigt wurden.
In Astras API-Spezifikation sind zwar 1,05 Mio. Tokens angegeben, aber Codex kann standardmäßig ein kleineres Kontextfenster verwenden.
In meiner Konfiguration waren standardmäßig 272.000 Tokens eingestellt.
Mit dem Faktor von 95 % für das nutzbare Kontextfenster des Clients erklärt das die in der App angezeigten 258k.
Das Maximum in meinem lokalen Modellkatalog lag bei 872.000 Tokens, was etwa 828k nutzbaren Tokens entspricht.
In deiner Konfiguration kann ein anderes Limit gelten. Daher lohnt es sich, Codex erst prüfen zu lassen, bevor du es änderst.
Ein Nachteil: Wenn mehr Verlauf im aktiven Kontext bleibt, kann das mehr von deinem Kontingent verbrauchen.
Allein durch das Anheben des Limits wird nicht jede Anfrage das gesamte Kontextfenster ausschöpfen.
Wenn du bei Codex über ChatGPT angemeldet bist, gibt es keinen separaten Multiplikator für lange Kontexte, aber die Verarbeitung von mehr Tokens wird trotzdem angerechnet.
Wenn du deinen eigenen API-Schlüssel verwendest, gelten die API-Preise.
Wenn du das größte von deiner Konfiguration unterstützte Kontextfenster möchtest, füge Folgendes in Codex ein:
---------------------------
245
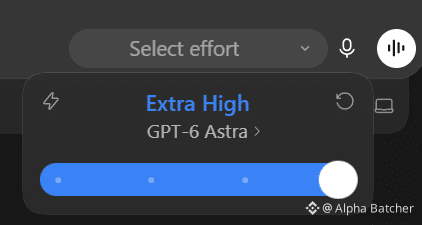
Ultra war plötzlich aus meiner Codex-Modellauswahl verschwunden. Zwei Konfigurationseinstellungen und ein Neustart haben es zurückgebracht.
Verwirrend war, dass Ultra in den Einstellungen bereits ausgewählt war, während der Schieberegler in meinem Chat bei Extra High endete.
Ich habe gesehen, dass andere unter Windows und macOS dasselbe berichteten.
Bei mir hat es funktioniert, Ultra in der config.toml zu aktivieren und die App dann vollständig zu beenden und erneut zu öffnen.
Wenn dir dasselbe passiert, füge Folgendes in Codex ein:
--------------------------------
"Stelle die Ultra-Option in der Modellauswahl meiner Codex-Desktop-App wieder her.
Ermittle mein derzeit ausgewähltes Modell und überprüfe, ob Ultra für mein Konto und meinen Client unterstützt wird.
Prüfe die aktive Benutzerkonfiguration und berücksichtige dabei CODEX_HOME sowie alle wirksamen Profil- oder Projektüberschreibungen.
Wenn sich die Unterstützung oder die relevanten Einstellungen nicht überprüfen lassen, ändere sie nicht und erkläre warum.
Erstelle von jeder bearbeiteten Datei eine Sicherungskopie.
Lass nicht zusammenhängende Einstellungen, Zugangsdaten, Anbieter, ausgewähltes Modell, Geschwindigkeit, standardmäßigen Reasoning-Aufwand, Kontextfenster und Berechtigungsrichtlinien unverändert.
Gib niemals Geheimnisse aus.
Setze im vorhandenen Abschnitt [desktop]:
show-ultra-in-model-picker-slider = true
Stelle sicher, dass enabled-reasoning-efforts die unterstützten Optionen ultra und max enthält und bewahre dabei alle vorhandenen gültigen Werte.
Falls der Schlüssel fehlt, füge beim Anlegen die üblichen unterstützten Optionen für den Reasoning-Aufwand hinzu.
Erstelle [desktop] nur, wenn der Abschnitt noch nicht existiert.
Vermeide doppelte Abschnitte und Schlüssel.
Beachte verwaltete Richtlinien.
Ändere keine Modellkataloge und aktiviere keine anderen experimentellen Funktionen.
Überprüfe die Konfiguration und stelle sicher, dass nur die vorgesehenen Einstellungen geändert wurden.
Starte die App nicht neu und unterbrich keine laufenden Aufgaben.
Melde den Speicherort der Sicherungskopie, die genauen Änderungen und alle ungelösten Einschränkungen.
Erkläre mir, wie ich die App vollständig beende und erneut öffne und anschließend Ultra im Chat auswähle.
Unterscheide zwischen gespeicherter Konfiguration und einem bestätigten Ergebnis in der Modellauswahl der laufenden App."
--------------------------------
Lass nach Abschluss durch Codex deine laufenden Aufgaben fertig werden, beende die App vollständig und öffne sie erneut.
Überprüfe dann die Modellauswahl in deinem Chat.
Erst dann war Ultra bei mir wieder da.
Ultra war plötzlich aus meiner Codex-Modellauswahl verschwunden. Zwei Konfigurationseinstellungen und ein Neustart haben es zurückgebracht.
Verwirrend war, dass Ultra in den Einstellungen bereits ausgewählt war, während der Schieberegler in meinem Chat bei Extra High endete.
Ich habe gesehen, dass andere unter Windows und macOS dasselbe berichteten.
Bei mir hat es funktioniert, Ultra in der config.toml zu aktivieren und die App dann vollständig zu beenden und erneut zu öffnen.
Wenn dir dasselbe passiert, füge Folgendes in Codex ein:
--------------------------------
"Stelle die Ultra-Option in der Modellauswahl meiner Codex-Desktop-App wieder her.
Ermittle mein derzeit ausgewähltes Modell und überprüfe, ob Ultra für mein Konto und meinen Client unterstützt wird.
Prüfe die aktive Benutzerkonfiguration und berücksichtige dabei CODEX_HOME sowie alle wirksamen Profil- oder Projektüberschreibungen.
Wenn sich die Unterstützung oder die relevanten Einstellungen nicht überprüfen lassen, ändere sie nicht und erkläre warum.
Erstelle von jeder bearbeiteten Datei eine Sicherungskopie.
Lass nicht zusammenhängende Einstellungen, Zugangsdaten, Anbieter, ausgewähltes Modell, Geschwindigkeit, standardmäßigen Reasoning-Aufwand, Kontextfenster und Berechtigungsrichtlinien unverändert.
Gib niemals Geheimnisse aus.
Setze im vorhandenen Abschnitt [desktop]:
show-ultra-in-model-picker-slider = true
Stelle sicher, dass enabled-reasoning-efforts die unterstützten Optionen ultra und max enthält und bewahre dabei alle vorhandenen gültigen Werte.
Falls der Schlüssel fehlt, füge beim Anlegen die üblichen unterstützten Optionen für den Reasoning-Aufwand hinzu.
Erstelle [desktop] nur, wenn der Abschnitt noch nicht existiert.
Vermeide doppelte Abschnitte und Schlüssel.
Beachte verwaltete Richtlinien.
Ändere keine Modellkataloge und aktiviere keine anderen experimentellen Funktionen.
Überprüfe die Konfiguration und stelle sicher, dass nur die vorgesehenen Einstellungen geändert wurden.
Starte die App nicht neu und unterbrich keine laufenden Aufgaben.
Melde den Speicherort der Sicherungskopie, die genauen Änderungen und alle ungelösten Einschränkungen.
Erkläre mir, wie ich die App vollständig beende und erneut öffne und anschließend Ultra im Chat auswähle.
Unterscheide zwischen gespeicherter Konfiguration und einem bestätigten Ergebnis in der Modellauswahl der laufenden App."
--------------------------------
Lass nach Abschluss durch Codex deine laufenden Aufgaben fertig werden, beende die App vollständig und öffne sie erneut.
Überprüfe dann die Modellauswahl in deinem Chat.
Erst dann war Ultra bei mir wieder da.
Verwirrend war, dass Ultra in den Einstellungen bereits ausgewählt war, während der Schieberegler in meinem Chat bei Extra High endete.
Ich habe gesehen, dass andere unter Windows und macOS dasselbe berichteten.
Bei mir hat es funktioniert, Ultra in der config.toml zu aktivieren und die App dann vollständig zu beenden und erneut zu öffnen.
Wenn dir dasselbe passiert, füge Folgendes in Codex ein:
--------------------------------
"Stelle die Ultra-Option in der Modellauswahl meiner Codex-Desktop-App wieder her.
Ermittle mein derzeit ausgewähltes Modell und überprüfe, ob Ultra für mein Konto und meinen Client unterstützt wird.
Prüfe die aktive Benutzerkonfiguration und berücksichtige dabei CODEX_HOME sowie alle wirksamen Profil- oder Projektüberschreibungen.
Wenn sich die Unterstützung oder die relevanten Einstellungen nicht überprüfen lassen, ändere sie nicht und erkläre warum.
Erstelle von jeder bearbeiteten Datei eine Sicherungskopie.
Lass nicht zusammenhängende Einstellungen, Zugangsdaten, Anbieter, ausgewähltes Modell, Geschwindigkeit, standardmäßigen Reasoning-Aufwand, Kontextfenster und Berechtigungsrichtlinien unverändert.
Gib niemals Geheimnisse aus.
Setze im vorhandenen Abschnitt [desktop]:
show-ultra-in-model-picker-slider = true
Stelle sicher, dass enabled-reasoning-efforts die unterstützten Optionen ultra und max enthält und bewahre dabei alle vorhandenen gültigen Werte.
Falls der Schlüssel fehlt, füge beim Anlegen die üblichen unterstützten Optionen für den Reasoning-Aufwand hinzu.
Erstelle [desktop] nur, wenn der Abschnitt noch nicht existiert.
Vermeide doppelte Abschnitte und Schlüssel.
Beachte verwaltete Richtlinien.
Ändere keine Modellkataloge und aktiviere keine anderen experimentellen Funktionen.
Überprüfe die Konfiguration und stelle sicher, dass nur die vorgesehenen Einstellungen geändert wurden.
Starte die App nicht neu und unterbrich keine laufenden Aufgaben.
Melde den Speicherort der Sicherungskopie, die genauen Änderungen und alle ungelösten Einschränkungen.
Erkläre mir, wie ich die App vollständig beende und erneut öffne und anschließend Ultra im Chat auswähle.
Unterscheide zwischen gespeicherter Konfiguration und einem bestätigten Ergebnis in der Modellauswahl der laufenden App."
--------------------------------
Lass nach Abschluss durch Codex deine laufenden Aufgaben fertig werden, beende die App vollständig und öffne sie erneut.
Überprüfe dann die Modellauswahl in deinem Chat.
Erst dann war Ultra bei mir wieder da.
1
389
Artikel
Warum dein KI-Agent ständig Tokens verbrauchtStell dir eine Fehlerbehebung vor, bei der 12 Zeilen geändert werden. Der Agent liest das Projekt, schreibt einen Plan, startet einen Helfer, führt Tests aus, liest die Fehler und versucht es erneut, bevor er diesen Patch erstellt.
Die Rechnung umfasst jede Anfrage, die zum Ergebnis geführt hat.
Dadurch kann eine kurze Aufgabe überraschend teuer werden. In einem langen Gespräch können alte Dateien in spätere Anfragen übernommen werden. Ein Tool kann seitenweise Daten zurückgeben, obwohl für die nächste Entscheidung ein einzelner Datensatz genügt. Mehrere Agents können dieselbe Untersuchung wiederholen.
Diese Kosten findest du im Ausführungsverlauf. Beginne mit einem Auftrag, erfasse alle dabei anfallenden Ausgaben und prüfe, ob das Ergebnis tatsächlich besteht. Ändere anschließend den Teil, der unnötige Arbeit verursacht.
Warum dein KI-Agent ständig Tokens verbraucht
Stell dir eine Fehlerbehebung vor, bei der 12 Zeilen geändert werden. Der Agent liest das Projekt, schreibt einen Plan, startet einen Helfer, führt Tests aus, liest die Fehler und versucht es erneut, bevor er diesen Patch erstellt.
Die Rechnung umfasst jede Anfrage, die zum Ergebnis geführt hat.
Dadurch kann eine kurze Aufgabe überraschend teuer werden. In einem langen Gespräch können alte Dateien in spätere Anfragen übernommen werden. Ein Tool kann seitenweise Daten zurückgeben, obwohl für die nächste Entscheidung ein einzelner Datensatz genügt. Mehrere Agents können dieselbe Untersuchung wiederholen.
Diese Kosten findest du im Ausführungsverlauf. Beginne mit einem Auftrag, erfasse alle dabei anfallenden Ausgaben und prüfe, ob das Ergebnis tatsächlich besteht. Ändere anschließend den Teil, der unnötige Arbeit verursacht.
Die Rechnung umfasst jede Anfrage, die zum Ergebnis geführt hat.
Dadurch kann eine kurze Aufgabe überraschend teuer werden. In einem langen Gespräch können alte Dateien in spätere Anfragen übernommen werden. Ein Tool kann seitenweise Daten zurückgeben, obwohl für die nächste Entscheidung ein einzelner Datensatz genügt. Mehrere Agents können dieselbe Untersuchung wiederholen.
Diese Kosten findest du im Ausführungsverlauf. Beginne mit einem Auftrag, erfasse alle dabei anfallenden Ausgaben und prüfe, ob das Ergebnis tatsächlich besteht. Ändere anschließend den Teil, der unnötige Arbeit verursacht.
757
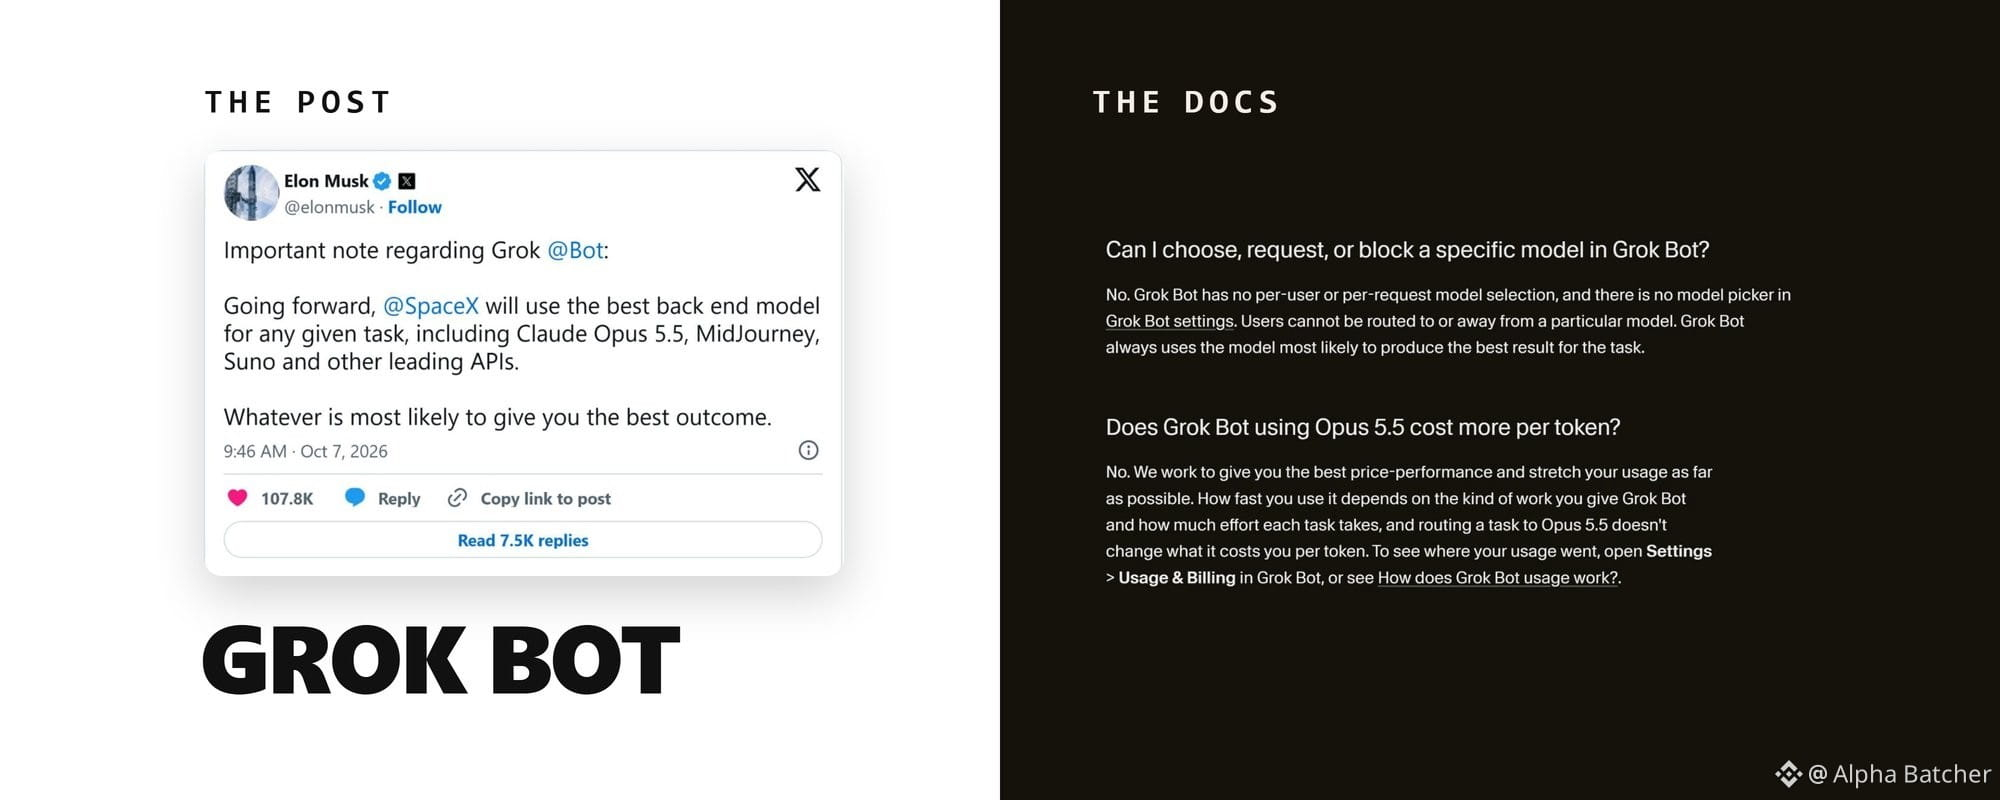
Artikel
Grok Bot bekam Claude und ein 30-Dollar-Abo. Was ist echt und was sollte man zuerst einrichten?Am 7. Oktober postete Elon Musk, dass Grok Bot „für jede Aufgabe das beste Backend-Modell verwenden wird, darunter Claude Opus 5.5“. 79 Millionen Aufrufe.
Eine Woche später postete NetworkChuck, der zuvor gesagt hatte, das Produkt sei ihm egal, dass er sich geirrt habe: Nach einer Woche, in der seine E-Mail, sein Kalender und seine eigenen Apps verknüpft waren, funktioniere es einfach.
Zwischen diesen beiden Posts bekam Grok Bot eine eigene E-Mail-Adresse, Lesezugriff auf ganz X, eine Shopify-Anbindung, X Money als Zahlungsmöglichkeit und einen Einstiegspreis von 30 $. Einiges davon steht in der Dokumentation. Anderes existiert nur in Musks Posts.
Grok Bot bekam Claude und ein 30-Dollar-Abo. Was ist echt und was sollte man zuerst einrichten?
Am 7. Oktober postete Elon Musk, dass Grok Bot „für jede Aufgabe das beste Backend-Modell verwenden wird, darunter Claude Opus 5.5“. 79 Millionen Aufrufe.
Eine Woche später postete NetworkChuck, der zuvor gesagt hatte, das Produkt sei ihm egal, dass er sich geirrt habe: Nach einer Woche, in der seine E-Mail, sein Kalender und seine eigenen Apps verknüpft waren, funktioniere es einfach.
Zwischen diesen beiden Posts bekam Grok Bot eine eigene E-Mail-Adresse, Lesezugriff auf ganz X, eine Shopify-Anbindung, X Money als Zahlungsmöglichkeit und einen Einstiegspreis von 30 $. Einiges davon steht in der Dokumentation. Anderes existiert nur in Musks Posts.
Eine Woche später postete NetworkChuck, der zuvor gesagt hatte, das Produkt sei ihm egal, dass er sich geirrt habe: Nach einer Woche, in der seine E-Mail, sein Kalender und seine eigenen Apps verknüpft waren, funktioniere es einfach.
Zwischen diesen beiden Posts bekam Grok Bot eine eigene E-Mail-Adresse, Lesezugriff auf ganz X, eine Shopify-Anbindung, X Money als Zahlungsmöglichkeit und einen Einstiegspreis von 30 $. Einiges davon steht in der Dokumentation. Anderes existiert nur in Musks Posts.
769
Seedance 2.0 Mini ist jetzt bei Topview verfügbar. Der Ultra-Jahresplan ist meiner Meinung nach am meisten sein Geld wert.
Zwei Möglichkeiten, es zu nutzen:
• Unbegrenzter Modus — unbegrenzte Generierungen für 365 Tage
• Credit-Modus — 0,05 $/Sek. für schnellere Verarbeitung
Gemacht für die tägliche Erstellung von KI-Videos. Nicht mehr, nicht weniger.
@TopviewAIhq
Seedance 2.0 Mini ist jetzt bei Topview verfügbar. Der Ultra-Jahresplan ist meiner Meinung nach am meisten sein Geld wert.
Zwei Möglichkeiten, es zu nutzen:
• Unbegrenzter Modus — unbegrenzte Generierungen für 365 Tage
• Credit-Modus — 0,05 $/Sek. für schnellere Verarbeitung
Gemacht für die tägliche Erstellung von KI-Videos. Nicht mehr, nicht weniger.
@TopviewAIhq
Zwei Möglichkeiten, es zu nutzen:
• Unbegrenzter Modus — unbegrenzte Generierungen für 365 Tage
• Credit-Modus — 0,05 $/Sek. für schnellere Verarbeitung
Gemacht für die tägliche Erstellung von KI-Videos. Nicht mehr, nicht weniger.
@TopviewAIhq
1
1.1k
OpenAI hat gerade GPT 5.5 released und es verändert komplett das Spiel des agentischen Codings
es ist ein vollautonomer Arbeiter, der deinen Computer und deine Apps übernimmt
> agiert autonom über Slack, GitHub und deinen Browser
> schlägt Claude Opus 4.7 und Gemini 3.1 Pro in agentischen Benchmarks
> erreicht die gleiche Latenz wie frühere Modelle, nutzt aber signifikant weniger Tokens
> ist jetzt sofort verfügbar für Plus- und Pro-Nutzer in ChatGPT und Codex
> fungiert als vollwertiger Forschungspartner, der tatsächlich seine eigene Arbeit überprüft
wir sind offiziell in der Ära angekommen, in der Modelle die Arbeit machen, anstatt nur Text zu generieren
OpenAI hat gerade GPT 5.5 released und es verändert komplett das Spiel des agentischen Codings
es ist ein vollautonomer Arbeiter, der deinen Computer und deine Apps übernimmt
> agiert autonom über Slack, GitHub und deinen Browser
> schlägt Claude Opus 4.7 und Gemini 3.1 Pro in agentischen Benchmarks
> erreicht die gleiche Latenz wie frühere Modelle, nutzt aber signifikant weniger Tokens
> ist jetzt sofort verfügbar für Plus- und Pro-Nutzer in ChatGPT und Codex
> fungiert als vollwertiger Forschungspartner, der tatsächlich seine eigene Arbeit überprüft
wir sind offiziell in der Ära angekommen, in der Modelle die Arbeit machen, anstatt nur Text zu generieren
es ist ein vollautonomer Arbeiter, der deinen Computer und deine Apps übernimmt
> agiert autonom über Slack, GitHub und deinen Browser
> schlägt Claude Opus 4.7 und Gemini 3.1 Pro in agentischen Benchmarks
> erreicht die gleiche Latenz wie frühere Modelle, nutzt aber signifikant weniger Tokens
> ist jetzt sofort verfügbar für Plus- und Pro-Nutzer in ChatGPT und Codex
> fungiert als vollwertiger Forschungspartner, der tatsächlich seine eigene Arbeit überprüft
wir sind offiziell in der Ära angekommen, in der Modelle die Arbeit machen, anstatt nur Text zu generieren
2
1.1k
> Finde das emotionale Ergebnis deines Produkts, anstatt nur Features zu verkaufen
> Nutze einen speziellen Agenten, um jede Skriptzeile hinsichtlich Neuheit und Intensität zu bewerten, bis beide 10 erreichen
> Mach deine Hater zur Waffe, indem du die Hauptkritik anerkennst, damit sie dich retweeten
> Zwing den Algorithmus, dich zu ranken, indem du massive Antwortketten in den ersten 48 Stunden erstellst
> Setze Influencer in gestaffelten Wellen ein, sobald die organische Geschwindigkeit zunimmt
> Finde das emotionale Ergebnis deines Produkts, anstatt nur Features zu verkaufen
> Nutze einen speziellen Agenten, um jede Skriptzeile hinsichtlich Neuheit und Intensität zu bewerten, bis beide 10 erreichen
> Mach deine Hater zur Waffe, indem du die Hauptkritik anerkennst, damit sie dich retweeten
> Zwing den Algorithmus, dich zu ranken, indem du massive Antwortketten in den ersten 48 Stunden erstellst
> Setze Influencer in gestaffelten Wellen ein, sobald die organische Geschwindigkeit zunimmt
> Nutze einen speziellen Agenten, um jede Skriptzeile hinsichtlich Neuheit und Intensität zu bewerten, bis beide 10 erreichen
> Mach deine Hater zur Waffe, indem du die Hauptkritik anerkennst, damit sie dich retweeten
> Zwing den Algorithmus, dich zu ranken, indem du massive Antwortketten in den ersten 48 Stunden erstellst
> Setze Influencer in gestaffelten Wellen ein, sobald die organische Geschwindigkeit zunimmt
1
551
Lazarus hat gerade $292 Millionen durch DeFi gewaschen und niemand konnte es stoppen
ᐳ frisch finanzierte Wallets mit Tornado Cash vorab gefüllt
ᐳ fälschte eine LayerZero-Nachricht, um 116k rsETH aus Kelp DAO abzuziehen
ᐳ pawnte die illiquiden Tokens auf Aave für $190 Millionen sauberes ETH, bevor Kelp pausierte
ᐳ löste dabei einen $8 Milliarden Bankrun auf Aave aus
ᐳ fragmentierte die Gelder über 100+ Wallets mit automatisierten Skripten
ᐳ wusch alles durch Thorchain, um ETH in nicht zurückverfolgbare BTC-Staub zu verwandeln
ᐳ bridgte zu Tron als USDT, wo OTC-Broker es über UnionPay ausgezahlt haben
50% der ausländischen Einnahmen Nordkoreas sind jetzt nur noch Krypto-Hacks
deFi funktioniert genau wie entworfen ...
Lazarus hat gerade $292 Millionen durch DeFi gewaschen und niemand konnte es stoppen
ᐳ frisch finanzierte Wallets mit Tornado Cash vorab gefüllt
ᐳ fälschte eine LayerZero-Nachricht, um 116k rsETH aus Kelp DAO abzuziehen
ᐳ pawnte die illiquiden Tokens auf Aave für $190 Millionen sauberes ETH, bevor Kelp pausierte
ᐳ löste dabei einen $8 Milliarden Bankrun auf Aave aus
ᐳ fragmentierte die Gelder über 100+ Wallets mit automatisierten Skripten
ᐳ wusch alles durch Thorchain, um ETH in nicht zurückverfolgbare BTC-Staub zu verwandeln
ᐳ bridgte zu Tron als USDT, wo OTC-Broker es über UnionPay ausgezahlt haben
50% der ausländischen Einnahmen Nordkoreas sind jetzt nur noch Krypto-Hacks
deFi funktioniert genau wie entworfen ...
ᐳ frisch finanzierte Wallets mit Tornado Cash vorab gefüllt
ᐳ fälschte eine LayerZero-Nachricht, um 116k rsETH aus Kelp DAO abzuziehen
ᐳ pawnte die illiquiden Tokens auf Aave für $190 Millionen sauberes ETH, bevor Kelp pausierte
ᐳ löste dabei einen $8 Milliarden Bankrun auf Aave aus
ᐳ fragmentierte die Gelder über 100+ Wallets mit automatisierten Skripten
ᐳ wusch alles durch Thorchain, um ETH in nicht zurückverfolgbare BTC-Staub zu verwandeln
ᐳ bridgte zu Tron als USDT, wo OTC-Broker es über UnionPay ausgezahlt haben
50% der ausländischen Einnahmen Nordkoreas sind jetzt nur noch Krypto-Hacks
deFi funktioniert genau wie entworfen ...
1
298
Die meisten Leute zahlen 200 $ für den Claude-Code und verwenden ihn wie ein glorifiziertes Autocomplete.
Hier ist das genaue 4-Schritte-System, um die 80 Prozent freizuschalten, die dir fehlen:
> Schreibe eine Markdown-Datei mit deinen Regeln, sobald und rufe sie nach Bedarf auf, anstatt die Eingabeaufforderungen jede Sitzung neu zu schreiben.
> Richte Post-Action-Hooks ein, um den Code automatisch zu formatieren oder destruktive Befehle zu blockieren, bevor sie ausgeführt werden.
> Erstelle ein Übergabe-Dokument mit dem, was morgen erledigt ist, und Versprechen, damit Claude genau weiß, wo du aufgehört hast.
> Isoliere Äste, damit mehrere Subagenten parallel arbeiten können, ohne dass sie sich gegenseitig überschreiben.
Hör auf, jeden Tag denselben Kontext zu tippen, und baue das System.
Die meisten Leute zahlen 200 $ für den Claude-Code und verwenden ihn wie ein glorifiziertes Autocomplete.
Hier ist das genaue 4-Schritte-System, um die 80 Prozent freizuschalten, die dir fehlen:
> Schreibe eine Markdown-Datei mit deinen Regeln, sobald und rufe sie nach Bedarf auf, anstatt die Eingabeaufforderungen jede Sitzung neu zu schreiben.
> Richte Post-Action-Hooks ein, um den Code automatisch zu formatieren oder destruktive Befehle zu blockieren, bevor sie ausgeführt werden.
> Erstelle ein Übergabe-Dokument mit dem, was morgen erledigt ist, und Versprechen, damit Claude genau weiß, wo du aufgehört hast.
> Isoliere Äste, damit mehrere Subagenten parallel arbeiten können, ohne dass sie sich gegenseitig überschreiben.
Hör auf, jeden Tag denselben Kontext zu tippen, und baue das System.
Hier ist das genaue 4-Schritte-System, um die 80 Prozent freizuschalten, die dir fehlen:
> Schreibe eine Markdown-Datei mit deinen Regeln, sobald und rufe sie nach Bedarf auf, anstatt die Eingabeaufforderungen jede Sitzung neu zu schreiben.
> Richte Post-Action-Hooks ein, um den Code automatisch zu formatieren oder destruktive Befehle zu blockieren, bevor sie ausgeführt werden.
> Erstelle ein Übergabe-Dokument mit dem, was morgen erledigt ist, und Versprechen, damit Claude genau weiß, wo du aufgehört hast.
> Isoliere Äste, damit mehrere Subagenten parallel arbeiten können, ohne dass sie sich gegenseitig überschreiben.
Hör auf, jeden Tag denselben Kontext zu tippen, und baue das System.
1
485
der genaue Stapel, um Ihre KI in einen rund um die Uhr verfügbaren Junior Analysten zu verwandeln
Stufe 1 Onchain- und Marktdaten
> Etherscan zieht Wallet-Historie und Token-Transfers sofort ab
> Dune Analytics führt SQL aus, um herauszufinden, wer tatsächlich $RIVER oder irgendein Solana-Mikrokapital hält
> CoinGecko und TradingView lesen Live-Charts und Funding-Raten
Stufe 2 Sentiment und Logik
> Polymarket überprüft die Smart-Money-Quoten, bevor Nachrichten veröffentlicht werden
> X und Firecrawl durchsuchen Governance-Foren und Zeitlinien-Stimmungen
> Gedächtnis und sequenzielles Denken zwingen Claude, Ihre Thesen zu erinnern und das Halluzinieren zu stoppen
das Ziel ist es, Ihre Morgenroutine zu automatisieren
richten Sie einen Prompt ein, der Quotenverschiebungen, Walbewegungen und Sentiment-Deltas abruft, während Sie Kaffee machen
hören Sie auf, manuelle Recherchen durchzuführen, und bauen Sie das System auf
der genaue Stapel, um Ihre KI in einen rund um die Uhr verfügbaren Junior Analysten zu verwandeln
Stufe 1 Onchain- und Marktdaten
> Etherscan zieht Wallet-Historie und Token-Transfers sofort ab
> Dune Analytics führt SQL aus, um herauszufinden, wer tatsächlich $RIVER oder irgendein Solana-Mikrokapital hält
> CoinGecko und TradingView lesen Live-Charts und Funding-Raten
Stufe 2 Sentiment und Logik
> Polymarket überprüft die Smart-Money-Quoten, bevor Nachrichten veröffentlicht werden
> X und Firecrawl durchsuchen Governance-Foren und Zeitlinien-Stimmungen
> Gedächtnis und sequenzielles Denken zwingen Claude, Ihre Thesen zu erinnern und das Halluzinieren zu stoppen
das Ziel ist es, Ihre Morgenroutine zu automatisieren
richten Sie einen Prompt ein, der Quotenverschiebungen, Walbewegungen und Sentiment-Deltas abruft, während Sie Kaffee machen
hören Sie auf, manuelle Recherchen durchzuführen, und bauen Sie das System auf
Stufe 1 Onchain- und Marktdaten
> Etherscan zieht Wallet-Historie und Token-Transfers sofort ab
> Dune Analytics führt SQL aus, um herauszufinden, wer tatsächlich $RIVER oder irgendein Solana-Mikrokapital hält
> CoinGecko und TradingView lesen Live-Charts und Funding-Raten
Stufe 2 Sentiment und Logik
> Polymarket überprüft die Smart-Money-Quoten, bevor Nachrichten veröffentlicht werden
> X und Firecrawl durchsuchen Governance-Foren und Zeitlinien-Stimmungen
> Gedächtnis und sequenzielles Denken zwingen Claude, Ihre Thesen zu erinnern und das Halluzinieren zu stoppen
das Ziel ist es, Ihre Morgenroutine zu automatisieren
richten Sie einen Prompt ein, der Quotenverschiebungen, Walbewegungen und Sentiment-Deltas abruft, während Sie Kaffee machen
hören Sie auf, manuelle Recherchen durchzuführen, und bauen Sie das System auf
555
Wenn Sie tatsächlichen Einfluss haben möchten, müssen Sie Claude wie eine Infrastruktur behandeln.
> Richten Sie eine CLAUDE md-Datei ein, damit das Modell sofort Ihre Formatierungs- und Architekturregeln kennt.
> Verwenden Sie Subagenten für parallele Aufgaben, anstatt einen Thread zu zwingen, alles zu erledigen.
> Verlassen Sie sich auf die Cowork-Dispatch, um Aufgaben auszuführen, während Sie buchstäblich von der Tastatur weg sind.
Die Modelle sind in Ordnung, Sie müssen nur aufhören, Aufforderungen zu geben, und anfangen, tatsächliche agentische Systeme aufzubauen.
Wenn Sie tatsächlichen Einfluss haben möchten, müssen Sie Claude wie eine Infrastruktur behandeln.
> Richten Sie eine CLAUDE md-Datei ein, damit das Modell sofort Ihre Formatierungs- und Architekturregeln kennt.
> Verwenden Sie Subagenten für parallele Aufgaben, anstatt einen Thread zu zwingen, alles zu erledigen.
> Verlassen Sie sich auf die Cowork-Dispatch, um Aufgaben auszuführen, während Sie buchstäblich von der Tastatur weg sind.
Die Modelle sind in Ordnung, Sie müssen nur aufhören, Aufforderungen zu geben, und anfangen, tatsächliche agentische Systeme aufzubauen.
> Richten Sie eine CLAUDE md-Datei ein, damit das Modell sofort Ihre Formatierungs- und Architekturregeln kennt.
> Verwenden Sie Subagenten für parallele Aufgaben, anstatt einen Thread zu zwingen, alles zu erledigen.
> Verlassen Sie sich auf die Cowork-Dispatch, um Aufgaben auszuführen, während Sie buchstäblich von der Tastatur weg sind.
Die Modelle sind in Ordnung, Sie müssen nur aufhören, Aufforderungen zu geben, und anfangen, tatsächliche agentische Systeme aufzubauen.
1
349
Hören Sie auf, Claude wie eine glorifizierte Suchmaschine zu verwenden, und beginnen Sie, es als autonomen Mitarbeiter zu nutzen
Der Unterschied zwischen einem "Chatbot" und einem "System" ist das Model Context Protocol (MCP)
Es ermöglicht Claude, über einfaches Prompting hinauszugehen und tatsächlich mit Ihren realen Daten zu interagieren
ᐳ GitHub MCP zur Verwaltung von PRs und Problemen direkt aus dem Chat
ᐳ PostgreSQL und Supabase zum Abfragen Ihrer Live-Datenbanken
ᐳ Slack und Gmail zur Handhabung Ihrer Teamkommunikation und Ihres Posteingangs
ᐳ Playwright für vollständige Browserautomatisierung und UI-Tests
ᐳ AWS und Cloudflare zur Verwaltung Ihrer gesamten Cloud-Infrastruktur
Sie geben Claude im Wesentlichen die Schlüssel zu Ihrem Büro, anstatt es nur um Rat zu fragen
Das $20-Abonnement bleibt gleich, aber der Output wird 1000-mal wertvoller
Hören Sie auf, Claude wie eine glorifizierte Suchmaschine zu verwenden, und beginnen Sie, es als autonomen Mitarbeiter zu nutzen
Der Unterschied zwischen einem "Chatbot" und einem "System" ist das Model Context Protocol (MCP)
Es ermöglicht Claude, über einfaches Prompting hinauszugehen und tatsächlich mit Ihren realen Daten zu interagieren
ᐳ GitHub MCP zur Verwaltung von PRs und Problemen direkt aus dem Chat
ᐳ PostgreSQL und Supabase zum Abfragen Ihrer Live-Datenbanken
ᐳ Slack und Gmail zur Handhabung Ihrer Teamkommunikation und Ihres Posteingangs
ᐳ Playwright für vollständige Browserautomatisierung und UI-Tests
ᐳ AWS und Cloudflare zur Verwaltung Ihrer gesamten Cloud-Infrastruktur
Sie geben Claude im Wesentlichen die Schlüssel zu Ihrem Büro, anstatt es nur um Rat zu fragen
Das $20-Abonnement bleibt gleich, aber der Output wird 1000-mal wertvoller
Der Unterschied zwischen einem "Chatbot" und einem "System" ist das Model Context Protocol (MCP)
Es ermöglicht Claude, über einfaches Prompting hinauszugehen und tatsächlich mit Ihren realen Daten zu interagieren
ᐳ GitHub MCP zur Verwaltung von PRs und Problemen direkt aus dem Chat
ᐳ PostgreSQL und Supabase zum Abfragen Ihrer Live-Datenbanken
ᐳ Slack und Gmail zur Handhabung Ihrer Teamkommunikation und Ihres Posteingangs
ᐳ Playwright für vollständige Browserautomatisierung und UI-Tests
ᐳ AWS und Cloudflare zur Verwaltung Ihrer gesamten Cloud-Infrastruktur
Sie geben Claude im Wesentlichen die Schlüssel zu Ihrem Büro, anstatt es nur um Rat zu fragen
Das $20-Abonnement bleibt gleich, aber der Output wird 1000-mal wertvoller
1
1
475
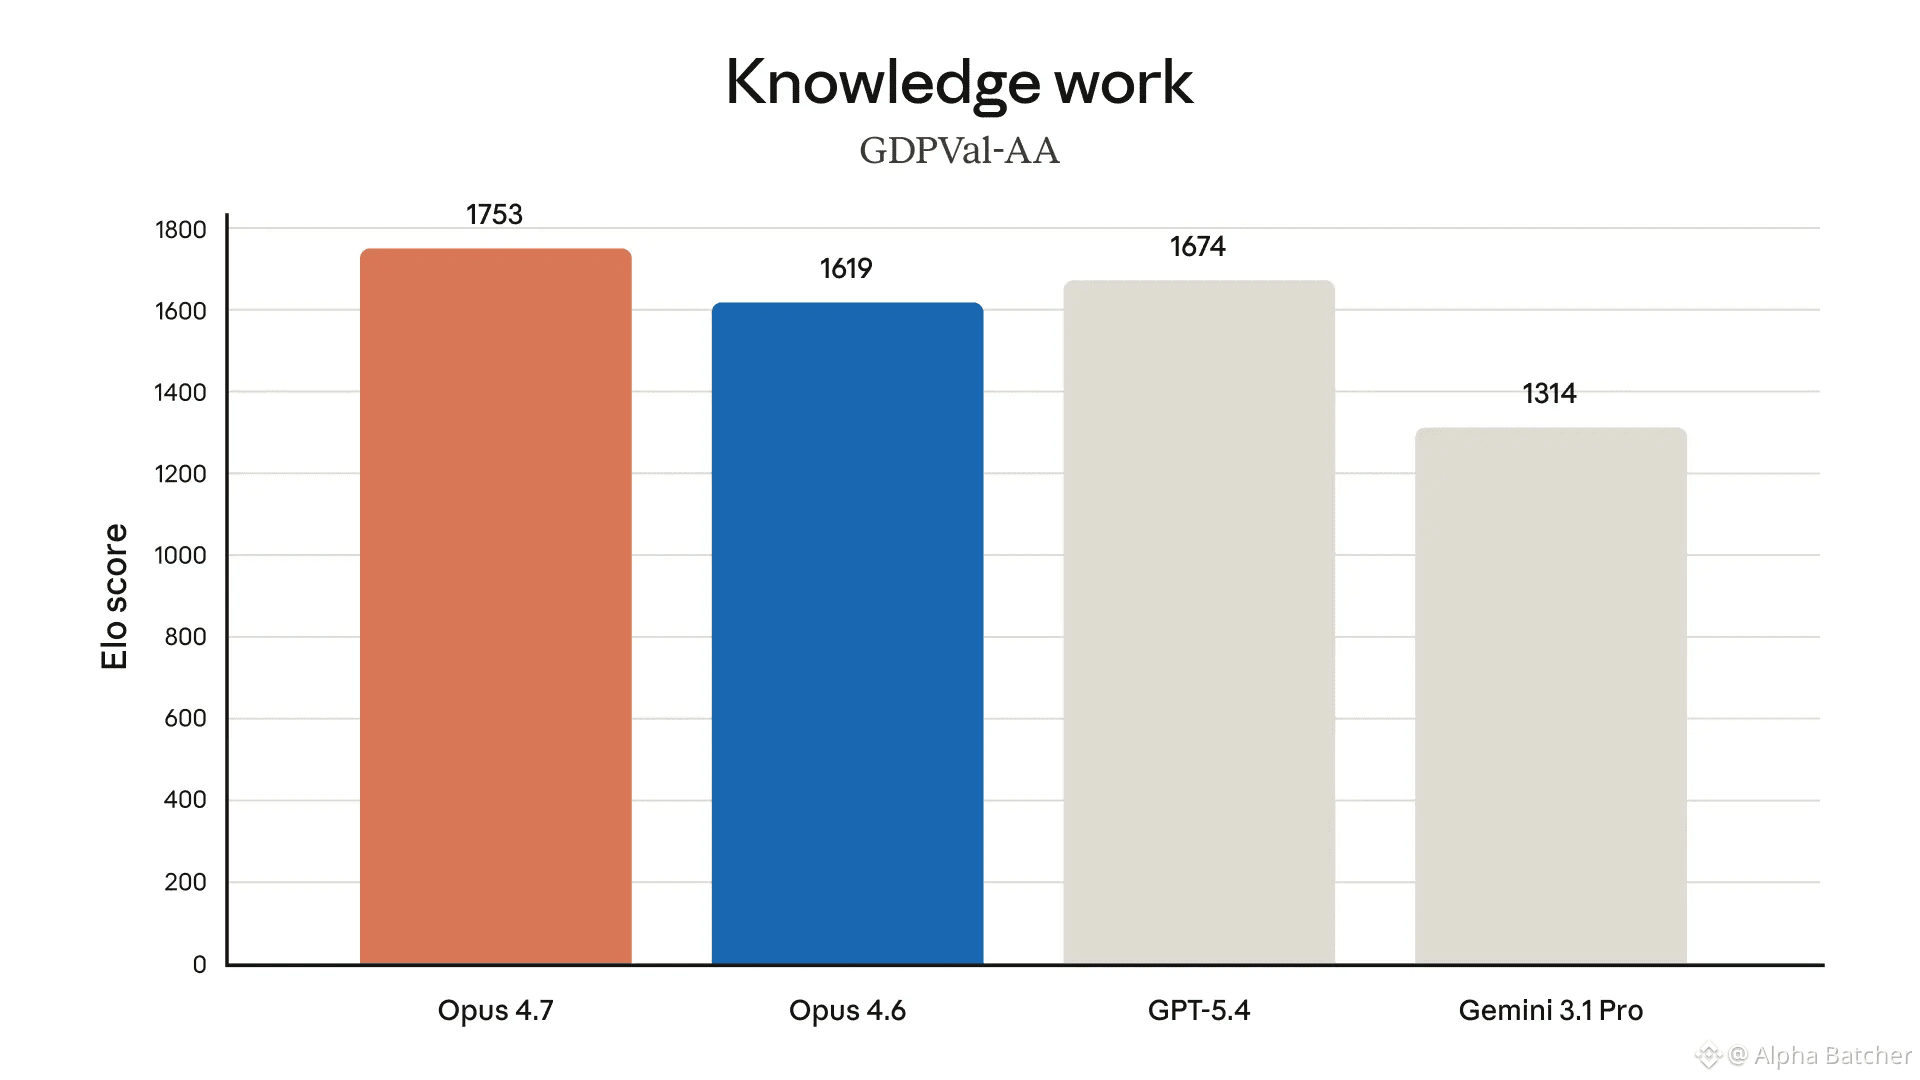
Claude Opus 4.7 ist gerade live gegangen und es ist eine vollständige Überarbeitung für autonome Softwareentwicklung
ᐳ Zerschmettert Opus 4.6 auf SWE-bench Pro mit einer Punktzahl von 64.3%
ᐳ Vision ist jetzt 3x schärfer mit Unterstützung für 3.75MP hochauflösende Bilder
ᐳ Neues "xhigh" Aufwandniveau für Ihre schwierigsten architektonischen Aufgaben
ᐳ Selbstverifizierende Logik, bei der sie ihren eigenen Code prüft, bevor sie zurückmeldet
Die Preise sind auf 5 $ pro 1M Eingabetokens festgelegt, aber die Zuverlässigkeit ist auf einem anderen Planeten
Während Mythos Preview der "Intelligenz-König" bleibt, ist Opus 4.7 offiziell der neue Produktionsstandard für alle, die 2026 Agenten entwickeln.
Claude Opus 4.7 ist gerade live gegangen und es ist eine vollständige Überarbeitung für autonome Softwareentwicklung
ᐳ Zerschmettert Opus 4.6 auf SWE-bench Pro mit einer Punktzahl von 64.3%
ᐳ Vision ist jetzt 3x schärfer mit Unterstützung für 3.75MP hochauflösende Bilder
ᐳ Neues "xhigh" Aufwandniveau für Ihre schwierigsten architektonischen Aufgaben
ᐳ Selbstverifizierende Logik, bei der sie ihren eigenen Code prüft, bevor sie zurückmeldet
Die Preise sind auf 5 $ pro 1M Eingabetokens festgelegt, aber die Zuverlässigkeit ist auf einem anderen Planeten
Während Mythos Preview der "Intelligenz-König" bleibt, ist Opus 4.7 offiziell der neue Produktionsstandard für alle, die 2026 Agenten entwickeln.
ᐳ Zerschmettert Opus 4.6 auf SWE-bench Pro mit einer Punktzahl von 64.3%
ᐳ Vision ist jetzt 3x schärfer mit Unterstützung für 3.75MP hochauflösende Bilder
ᐳ Neues "xhigh" Aufwandniveau für Ihre schwierigsten architektonischen Aufgaben
ᐳ Selbstverifizierende Logik, bei der sie ihren eigenen Code prüft, bevor sie zurückmeldet
Die Preise sind auf 5 $ pro 1M Eingabetokens festgelegt, aber die Zuverlässigkeit ist auf einem anderen Planeten
Während Mythos Preview der "Intelligenz-König" bleibt, ist Opus 4.7 offiziell der neue Produktionsstandard für alle, die 2026 Agenten entwickeln.
1
361
Entwickler sparen täglich 5-6 Stunden mit Claude Code:
eine Datei und drei Befehle ändern alles:
1. CLAUDE.md - sagt Claude einmal Ihre Regeln, und er folgt ihnen für immer. Die Verstöße sinken von 40 % auf 3 %
2. everything-claude-code - 30+ Agenten ersetzen Ihren gesamten Planungs-, Prüfungs- und Sicherheitsworkflow sofort
3. version 2.1.98 - die aktuelle Version berechnet stillschweigend 20.000 zusätzliche Tokens pro Sitzung. Ein Downgrade gibt 40 % Ihrer Grenzen zurück
das Ergebnis:
8 Stunden Programmierung pro Tag werden nur zu 2-3 Stunden Überprüfung
Einrichtungszeit: 15 Minuten
das genaue System ist im folgenden Artikel👇
https://x.com/alphabatcher/status/2044058486221271375
Entwickler sparen täglich 5-6 Stunden mit Claude Code:
eine Datei und drei Befehle ändern alles:
1. CLAUDE.md - sagt Claude einmal Ihre Regeln, und er folgt ihnen für immer. Die Verstöße sinken von 40 % auf 3 %
2. everything-claude-code - 30+ Agenten ersetzen Ihren gesamten Planungs-, Prüfungs- und Sicherheitsworkflow sofort
3. version 2.1.98 - die aktuelle Version berechnet stillschweigend 20.000 zusätzliche Tokens pro Sitzung. Ein Downgrade gibt 40 % Ihrer Grenzen zurück
das Ergebnis:
8 Stunden Programmierung pro Tag werden nur zu 2-3 Stunden Überprüfung
Einrichtungszeit: 15 Minuten
das genaue System ist im folgenden Artikel👇
https://x.com/alphabatcher/status/2044058486221271375
eine Datei und drei Befehle ändern alles:
1. CLAUDE.md - sagt Claude einmal Ihre Regeln, und er folgt ihnen für immer. Die Verstöße sinken von 40 % auf 3 %
2. everything-claude-code - 30+ Agenten ersetzen Ihren gesamten Planungs-, Prüfungs- und Sicherheitsworkflow sofort
3. version 2.1.98 - die aktuelle Version berechnet stillschweigend 20.000 zusätzliche Tokens pro Sitzung. Ein Downgrade gibt 40 % Ihrer Grenzen zurück
das Ergebnis:
8 Stunden Programmierung pro Tag werden nur zu 2-3 Stunden Überprüfung
Einrichtungszeit: 15 Minuten
das genaue System ist im folgenden Artikel👇
https://x.com/alphabatcher/status/2044058486221271375
383
30 Minuten und Ihr Claude wird zu einem wirklich geschulten Spezialisten
was tatsächlich seine Leistung beeinflusst:
1. Richten Sie Ihren Arbeitsplatz so ein, dass neue Chats nicht außerhalb eines Projekts erstellt werden
2. Große, zuverlässige Datenquellen für die Wissensdatenbank
3. Eine klare "Nicht"-Liste funktioniert oft besser als nur positive Anweisungen
4. Kombinieren Sie MCP, Fähigkeiten und Projekte in einem System
5. Getrennte Speicher für jedes Projekt mit drei Zugriffsebenen
die Menschen, die dies richtig einrichten, erhalten Ergebnisse, die so aussehen, als hätte es ein geschulter Spezialist geliefert
30 Minuten und Ihr Claude wird zu einem wirklich geschulten Spezialisten
was tatsächlich seine Leistung beeinflusst:
1. Richten Sie Ihren Arbeitsplatz so ein, dass neue Chats nicht außerhalb eines Projekts erstellt werden
2. Große, zuverlässige Datenquellen für die Wissensdatenbank
3. Eine klare "Nicht"-Liste funktioniert oft besser als nur positive Anweisungen
4. Kombinieren Sie MCP, Fähigkeiten und Projekte in einem System
5. Getrennte Speicher für jedes Projekt mit drei Zugriffsebenen
die Menschen, die dies richtig einrichten, erhalten Ergebnisse, die so aussehen, als hätte es ein geschulter Spezialist geliefert
was tatsächlich seine Leistung beeinflusst:
1. Richten Sie Ihren Arbeitsplatz so ein, dass neue Chats nicht außerhalb eines Projekts erstellt werden
2. Große, zuverlässige Datenquellen für die Wissensdatenbank
3. Eine klare "Nicht"-Liste funktioniert oft besser als nur positive Anweisungen
4. Kombinieren Sie MCP, Fähigkeiten und Projekte in einem System
5. Getrennte Speicher für jedes Projekt mit drei Zugriffsebenen
die Menschen, die dies richtig einrichten, erhalten Ergebnisse, die so aussehen, als hätte es ein geschulter Spezialist geliefert
2
211
Regeln, die Sie tatsächlich einstellen:
- Bewerben Sie sich auf Rollen, für die Sie zu 70 % oder mehr qualifiziert sind
- Passen Sie jede Bewerbung an die Stellenbeschreibung an, allgemeine Lebensläufe werden ignoriert, bevor ein Mensch sie liest
- Ihre Lebenslaufpunkte sollten Ergebnisse zeigen
- Schlüsselwörter sind wichtig, ATS filtert Sie heraus, bevor ein Recruiter Ihren Namen jemals sieht
- Recherchieren Sie das Unternehmen vor jedem Interview
- Bereiten Sie 5-8 STAR-Geschichten vor, die Führung, Misserfolg, Konflikt und Erfolg abdecken
- Das Anschreiben ist der Grund, warum Sie diese spezifische Rolle speziell wollen
- Folgen Sie innerhalb von 24 Stunden nach jedem Interview nach
- Die Frage "Haben Sie Fragen an uns?" ist nicht optional, es ist ein Test
- Ihr LinkedIn-Profil muss mit Ihrem Lebenslauf übereinstimmen
Der Unterschied zwischen Kandidaten, die eingestellt werden, und denen, die es nicht werden, ist selten Talent
Regeln, die Sie tatsächlich einstellen:
- Bewerben Sie sich auf Rollen, für die Sie zu 70 % oder mehr qualifiziert sind
- Passen Sie jede Bewerbung an die Stellenbeschreibung an, allgemeine Lebensläufe werden ignoriert, bevor ein Mensch sie liest
- Ihre Lebenslaufpunkte sollten Ergebnisse zeigen
- Schlüsselwörter sind wichtig, ATS filtert Sie heraus, bevor ein Recruiter Ihren Namen jemals sieht
- Recherchieren Sie das Unternehmen vor jedem Interview
- Bereiten Sie 5-8 STAR-Geschichten vor, die Führung, Misserfolg, Konflikt und Erfolg abdecken
- Das Anschreiben ist der Grund, warum Sie diese spezifische Rolle speziell wollen
- Folgen Sie innerhalb von 24 Stunden nach jedem Interview nach
- Die Frage "Haben Sie Fragen an uns?" ist nicht optional, es ist ein Test
- Ihr LinkedIn-Profil muss mit Ihrem Lebenslauf übereinstimmen
Der Unterschied zwischen Kandidaten, die eingestellt werden, und denen, die es nicht werden, ist selten Talent
- Bewerben Sie sich auf Rollen, für die Sie zu 70 % oder mehr qualifiziert sind
- Passen Sie jede Bewerbung an die Stellenbeschreibung an, allgemeine Lebensläufe werden ignoriert, bevor ein Mensch sie liest
- Ihre Lebenslaufpunkte sollten Ergebnisse zeigen
- Schlüsselwörter sind wichtig, ATS filtert Sie heraus, bevor ein Recruiter Ihren Namen jemals sieht
- Recherchieren Sie das Unternehmen vor jedem Interview
- Bereiten Sie 5-8 STAR-Geschichten vor, die Führung, Misserfolg, Konflikt und Erfolg abdecken
- Das Anschreiben ist der Grund, warum Sie diese spezifische Rolle speziell wollen
- Folgen Sie innerhalb von 24 Stunden nach jedem Interview nach
- Die Frage "Haben Sie Fragen an uns?" ist nicht optional, es ist ein Test
- Ihr LinkedIn-Profil muss mit Ihrem Lebenslauf übereinstimmen
Der Unterschied zwischen Kandidaten, die eingestellt werden, und denen, die es nicht werden, ist selten Talent
223
So viel kostete die Videoproduktion vor 5 Jahren im Vergleich zu heute:
30-Sekunden-Werbespot - vor KI:
- professionelles Team: $3.000-$8.000 pro Drehtag
- Pre-Produktion: $1.000-$5.000
- Post-Produktion: $1.000-$6.000
- Werbeverteilungsbudget: optional, oft separat
- insgesamt für einen Spot: $5.000-$20.000
30-Sekunden-Werbespot - mit KI heute:
- 8 Aufnahmen zu je $4,50 = $36
- Schnitt in CapCut = kostenlos
- Sprachaufnahme über ElevenLabs = $5
- insgesamt: unter $50
Ein 35-Sekunden-Kurzfilm erforderte früher ein Team, ein Studio, einen Regisseur, Wochen der Pre-Produktion
Zwei Brüder in El Salvador haben einen in 40 Minuten für $7,55 gemacht
Werkzeuge wurden buchstäblich über Nacht hundertfach günstiger.
So viel kostete die Videoproduktion vor 5 Jahren im Vergleich zu heute:
30-Sekunden-Werbespot - vor KI:
- professionelles Team: $3.000-$8.000 pro Drehtag
- Pre-Produktion: $1.000-$5.000
- Post-Produktion: $1.000-$6.000
- Werbeverteilungsbudget: optional, oft separat
- insgesamt für einen Spot: $5.000-$20.000
30-Sekunden-Werbespot - mit KI heute:
- 8 Aufnahmen zu je $4,50 = $36
- Schnitt in CapCut = kostenlos
- Sprachaufnahme über ElevenLabs = $5
- insgesamt: unter $50
Ein 35-Sekunden-Kurzfilm erforderte früher ein Team, ein Studio, einen Regisseur, Wochen der Pre-Produktion
Zwei Brüder in El Salvador haben einen in 40 Minuten für $7,55 gemacht
Werkzeuge wurden buchstäblich über Nacht hundertfach günstiger.
30-Sekunden-Werbespot - vor KI:
- professionelles Team: $3.000-$8.000 pro Drehtag
- Pre-Produktion: $1.000-$5.000
- Post-Produktion: $1.000-$6.000
- Werbeverteilungsbudget: optional, oft separat
- insgesamt für einen Spot: $5.000-$20.000
30-Sekunden-Werbespot - mit KI heute:
- 8 Aufnahmen zu je $4,50 = $36
- Schnitt in CapCut = kostenlos
- Sprachaufnahme über ElevenLabs = $5
- insgesamt: unter $50
Ein 35-Sekunden-Kurzfilm erforderte früher ein Team, ein Studio, einen Regisseur, Wochen der Pre-Produktion
Zwei Brüder in El Salvador haben einen in 40 Minuten für $7,55 gemacht
Werkzeuge wurden buchstäblich über Nacht hundertfach günstiger.
1
568
Verwandeln Sie Ihr 2-minütiges wiederholendes Eingabeaufforderung in einen 1-Sekunden-Slash-Befehl
- dieselbe Eingabeaufforderung jedes Mal
- versionskontrolliert über Git, das gesamte Team führt identische Befehle aus
- ein Befehl ersetzt 10-15 Zeilen, die Sie aus dem Gedächtnis neu eingetippt haben
- dynamischer Kontext wird automatisch vor jedem Lauf eingefügt
- Genehmigungswerkzeuge im Voraus genehmigen, damit Claude aufhört, um Erlaubnis zu fragen
- Befehle werden projektübergreifend oder auf ein Repository beschränkt geteilt
- einmal iterieren, für alle beim nächsten Pull verbessern
- verwandelt wiederholende Workflows in Ein-Wort-Aufrufe
- fängt Bugs, die Linter bei jedem einzelnen Lauf übersehen
- die Eingabeaufforderung wird im Laufe der Zeit besser, nicht schlechter
Sie richten es einmal ein und verwenden es für alles
Verwandeln Sie Ihr 2-minütiges wiederholendes Eingabeaufforderung in einen 1-Sekunden-Slash-Befehl
- dieselbe Eingabeaufforderung jedes Mal
- versionskontrolliert über Git, das gesamte Team führt identische Befehle aus
- ein Befehl ersetzt 10-15 Zeilen, die Sie aus dem Gedächtnis neu eingetippt haben
- dynamischer Kontext wird automatisch vor jedem Lauf eingefügt
- Genehmigungswerkzeuge im Voraus genehmigen, damit Claude aufhört, um Erlaubnis zu fragen
- Befehle werden projektübergreifend oder auf ein Repository beschränkt geteilt
- einmal iterieren, für alle beim nächsten Pull verbessern
- verwandelt wiederholende Workflows in Ein-Wort-Aufrufe
- fängt Bugs, die Linter bei jedem einzelnen Lauf übersehen
- die Eingabeaufforderung wird im Laufe der Zeit besser, nicht schlechter
Sie richten es einmal ein und verwenden es für alles
- dieselbe Eingabeaufforderung jedes Mal
- versionskontrolliert über Git, das gesamte Team führt identische Befehle aus
- ein Befehl ersetzt 10-15 Zeilen, die Sie aus dem Gedächtnis neu eingetippt haben
- dynamischer Kontext wird automatisch vor jedem Lauf eingefügt
- Genehmigungswerkzeuge im Voraus genehmigen, damit Claude aufhört, um Erlaubnis zu fragen
- Befehle werden projektübergreifend oder auf ein Repository beschränkt geteilt
- einmal iterieren, für alle beim nächsten Pull verbessern
- verwandelt wiederholende Workflows in Ein-Wort-Aufrufe
- fängt Bugs, die Linter bei jedem einzelnen Lauf übersehen
- die Eingabeaufforderung wird im Laufe der Zeit besser, nicht schlechter
Sie richten es einmal ein und verwenden es für alles
299
Wenn Sie nicht das Gedächtnis besitzen, besitzen Sie nicht den Agenten:
- Gedächtnis ist das, was Ihren Agenten im Laufe der Zeit schlauer macht
- ohne es kann jeder mit den gleichen Werkzeugen Ihren Agenten über Nacht kopieren
- mit ihm bauen Sie einen Datensatz auf, den kein Konkurrent replizieren kann
- geschlossenes Gedächtnis = Ihre Daten auf den Servern eines anderen
- Modelle wechseln, alles verlieren, was Ihr Agent gelernt hat
- Modellanbieter sind motiviert, Sie über das Gedächtnis zu binden
- das Modell ist leicht zu ersetzen, Gedächtnis ist es nicht
- wenn Sie nicht das Geschirr besitzen, besitzen Sie nicht das Gedächtnis
- wenn Sie nicht das Gedächtnis besitzen, besitzen Sie nicht den Agenten
Wenn Sie nicht das Gedächtnis besitzen, besitzen Sie nicht den Agenten:
- Gedächtnis ist das, was Ihren Agenten im Laufe der Zeit schlauer macht
- ohne es kann jeder mit den gleichen Werkzeugen Ihren Agenten über Nacht kopieren
- mit ihm bauen Sie einen Datensatz auf, den kein Konkurrent replizieren kann
- geschlossenes Gedächtnis = Ihre Daten auf den Servern eines anderen
- Modelle wechseln, alles verlieren, was Ihr Agent gelernt hat
- Modellanbieter sind motiviert, Sie über das Gedächtnis zu binden
- das Modell ist leicht zu ersetzen, Gedächtnis ist es nicht
- wenn Sie nicht das Geschirr besitzen, besitzen Sie nicht das Gedächtnis
- wenn Sie nicht das Gedächtnis besitzen, besitzen Sie nicht den Agenten
- Gedächtnis ist das, was Ihren Agenten im Laufe der Zeit schlauer macht
- ohne es kann jeder mit den gleichen Werkzeugen Ihren Agenten über Nacht kopieren
- mit ihm bauen Sie einen Datensatz auf, den kein Konkurrent replizieren kann
- geschlossenes Gedächtnis = Ihre Daten auf den Servern eines anderen
- Modelle wechseln, alles verlieren, was Ihr Agent gelernt hat
- Modellanbieter sind motiviert, Sie über das Gedächtnis zu binden
- das Modell ist leicht zu ersetzen, Gedächtnis ist es nicht
- wenn Sie nicht das Geschirr besitzen, besitzen Sie nicht das Gedächtnis
- wenn Sie nicht das Gedächtnis besitzen, besitzen Sie nicht den Agenten
176
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
BinanceReopensWithdrawalsForMoreAssets
611,472 Aufrufe
2,927 Kommentare
Sicherheitsvorfall | Update zur Wiederherstellung Nr. 8: Auszahlungen für weitere Assets werden wieder aufgenommen (05.11.2026)
Binance Announcement
·146 Likes
·424.2k Aufrufe
BTCRebounds80K
129,830 Aufrufe
1,254 Kommentare
Binance98PercentReplenished
66,847 Aufrufe
868 Kommentare