
The MeeCrypt
100 منشورات
The MeeCrypt
إبلاغ
حظر المُستخدم
Early on crypto trends | Talking DePIN, AI & blockchain
9 تتابع
45 المتابعون
128 إعجاب
منشورات
الكل
اقتباسات
·
--
من يدعم الذكاء الاصطناعي من وراء الكواليس؟ @fluence
أمرٌ واحد أراه مثيرًا للاهتمام حول وكلاء الذكاء الاصطناعي هو أن التأخير لا يكون دائمًا سببه النموذج نفسه.
يمكن للوكيل إجراء عدة استدعاءات لأدوات، واسترجاع الحالة، وتشغيل عمليات التحقق، وتحديث الذاكرة، ثم تكرار الحلقة عدة مرات. قد تبدو عدة أجزاء من الملي ثانية من تأخير المعالج في كل خطوة غير مهمة بحد ذاتها، لكن مع مرورها عبر سير العمل كاملًا، يمكن أن تتراكم تلك التأخيرات وتدفع الطلب إلى ما بعد موعده النهائي.
هنا تصبح البنية التحتية أكثر أهمية مما قد يبدو في البداية.
بالنسبة لأحمال عمل الذكاء الاصطناعي، فإن متوسط الأداء ليس دائمًا كافيًا. قد يظهر التحدي الحقيقي عندما يتسبب التنافس على وحدة المعالجة المركزية في تأخيرات صغيرة عبر مراحل كثيرة.
وهذا يجعل تخصيص موارد حسابية مخصصة خيارًا مثيرًا للاهتمام للأحمال التي تهمها إمكانية الحصول على أداء يمكن التنبؤ به.
تعمل Fluence على معالجة هذا من جانب الحوسبة اللامركزية، ما يتيح للمطورين الوصول إلى موارد CPU مخصصة للأحمال التي تحتاج إلى سعة أكثر اتساقًا.
أعتقد أن هذا سيصبح أكثر أهمية مع انتقال وكلاء الذكاء الاصطناعي من التجارب البسيطة إلى بيئات الإنتاج. عندما يتولى الوكيل عشرات الخطوات، فإن تقليل التباين في كل مرحلة يمكن أن يحدث أثرًا أكبر بكثير على تجربة المستخدم النهائية.
السؤال الذي أراقبه بسيط: مع تعقُّد أحمال عمل الوكلاء، هل ستصبح الحوسبة القابلة للتنبؤ بنفس أهمية القدرة الخام على الحوسبة؟
https://fluence.ai/
#Fluence #AI #DePIN
من يدعم الذكاء الاصطناعي من وراء الكواليس؟ @Fluence
أمرٌ واحد أراه مثيرًا للاهتمام حول وكلاء الذكاء الاصطناعي هو أن التأخير لا يكون دائمًا سببه النموذج نفسه.
يمكن للوكيل إجراء عدة استدعاءات لأدوات، واسترجاع الحالة، وتشغيل عمليات التحقق، وتحديث الذاكرة، ثم تكرار الحلقة عدة مرات. قد تبدو عدة أجزاء من الملي ثانية من تأخير المعالج في كل خطوة غير مهمة بحد ذاتها، لكن مع مرورها عبر سير العمل كاملًا، يمكن أن تتراكم تلك التأخيرات وتدفع الطلب إلى ما بعد موعده النهائي.
هنا تصبح البنية التحتية أكثر أهمية مما قد يبدو في البداية.
بالنسبة لأحمال عمل الذكاء الاصطناعي، فإن متوسط الأداء ليس دائمًا كافيًا. قد يظهر التحدي الحقيقي عندما يتسبب التنافس على وحدة المعالجة المركزية في تأخيرات صغيرة عبر مراحل كثيرة.
وهذا يجعل تخصيص موارد حسابية مخصصة خيارًا مثيرًا للاهتمام للأحمال التي تهمها إمكانية الحصول على أداء يمكن التنبؤ به.
تعمل Fluence على معالجة هذا من جانب الحوسبة اللامركزية، ما يتيح للمطورين الوصول إلى موارد CPU مخصصة للأحمال التي تحتاج إلى سعة أكثر اتساقًا.
أعتقد أن هذا سيصبح أكثر أهمية مع انتقال وكلاء الذكاء الاصطناعي من التجارب البسيطة إلى بيئات الإنتاج. عندما يتولى الوكيل عشرات الخطوات، فإن تقليل التباين في كل مرحلة يمكن أن يحدث أثرًا أكبر بكثير على تجربة المستخدم النهائية.
السؤال الذي أراقبه بسيط: مع تعقُّد أحمال عمل الوكلاء، هل ستصبح الحوسبة القابلة للتنبؤ بنفس أهمية القدرة الخام على الحوسبة؟
https://fluence.ai/
#Fluence #AI #DePIN
أمرٌ واحد أراه مثيرًا للاهتمام حول وكلاء الذكاء الاصطناعي هو أن التأخير لا يكون دائمًا سببه النموذج نفسه.
يمكن للوكيل إجراء عدة استدعاءات لأدوات، واسترجاع الحالة، وتشغيل عمليات التحقق، وتحديث الذاكرة، ثم تكرار الحلقة عدة مرات. قد تبدو عدة أجزاء من الملي ثانية من تأخير المعالج في كل خطوة غير مهمة بحد ذاتها، لكن مع مرورها عبر سير العمل كاملًا، يمكن أن تتراكم تلك التأخيرات وتدفع الطلب إلى ما بعد موعده النهائي.
هنا تصبح البنية التحتية أكثر أهمية مما قد يبدو في البداية.
بالنسبة لأحمال عمل الذكاء الاصطناعي، فإن متوسط الأداء ليس دائمًا كافيًا. قد يظهر التحدي الحقيقي عندما يتسبب التنافس على وحدة المعالجة المركزية في تأخيرات صغيرة عبر مراحل كثيرة.
وهذا يجعل تخصيص موارد حسابية مخصصة خيارًا مثيرًا للاهتمام للأحمال التي تهمها إمكانية الحصول على أداء يمكن التنبؤ به.
تعمل Fluence على معالجة هذا من جانب الحوسبة اللامركزية، ما يتيح للمطورين الوصول إلى موارد CPU مخصصة للأحمال التي تحتاج إلى سعة أكثر اتساقًا.
أعتقد أن هذا سيصبح أكثر أهمية مع انتقال وكلاء الذكاء الاصطناعي من التجارب البسيطة إلى بيئات الإنتاج. عندما يتولى الوكيل عشرات الخطوات، فإن تقليل التباين في كل مرحلة يمكن أن يحدث أثرًا أكبر بكثير على تجربة المستخدم النهائية.
السؤال الذي أراقبه بسيط: مع تعقُّد أحمال عمل الوكلاء، هل ستصبح الحوسبة القابلة للتنبؤ بنفس أهمية القدرة الخام على الحوسبة؟
https://fluence.ai/
#Fluence #AI #DePIN
33
·
--
@fluence VPC سيعني الإطلاق المباشر خطوة مهمة في نظام Fluence البيئي.
https://fluence.ai/
تتيح بنية VPC الجديدة للمطوّرين تشغيل عدة أجهزة افتراضية (VMs) مع شبكة خاصة ومجموعات أمان وتحكّم في الخروج (egress) وعناوين IP عامة اختيارية وcloud-init. وبعبارة بسيطة، تجعل Fluence أكثر ملاءمة لتشغيل تطبيقات حقيقية مع عمل خدمات مختلفة معًا بشكل آمن.
ومن منظور $FLT، أرى أن الأمور تصبح مثيرة للاهتمام هنا.
ميزة بنية تحتية جديدة لا تعني تلقائيًا أن سعر FLT سيرتفع. السؤال الأكبر هو ما إذا كانت VPC ستساعد Fluence على جذب المزيد من المطوّرين والأحمال (workloads) والشركات.
إذا زاد التبنّي، فقد يتم نشر المزيد من الحوسبة عبر الشبكة، ما يخلق طلبًا أساسيًا أقوى وربما يحسّن الأساسيات التي تدعم FLT.
لذا أنا أراقب الاستخدام أكثر من الإعلان نفسه. إذا استمرت Fluence في إضافة بنية تحتية عملية وتحولت هذه الميزات إلى نشاط شبكي فعلي، فأعتقد أن ذلك قد يصبح محفزًا إيجابيًا لـ FLT مع مرور الوقت.
بالنسبة لي، الفرضية بسيطة: بنية تحتية أفضل → مزيد من حالات الاستخدام → مزيد من نشاط الشبكة → وربما أساسيات أقوى لـ FLT.
#DePIN #AI #Web3
@Fluence VPC سيعني الإطلاق المباشر خطوة مهمة في نظام Fluence البيئي.
https://fluence.ai/
تتيح بنية VPC الجديدة للمطوّرين تشغيل عدة أجهزة افتراضية (VMs) مع شبكة خاصة ومجموعات أمان وتحكّم في الخروج (egress) وعناوين IP عامة اختيارية وcloud-init. وبعبارة بسيطة، تجعل Fluence أكثر ملاءمة لتشغيل تطبيقات حقيقية مع عمل خدمات مختلفة معًا بشكل آمن.
ومن منظور $FLT، أرى أن الأمور تصبح مثيرة للاهتمام هنا.
ميزة بنية تحتية جديدة لا تعني تلقائيًا أن سعر FLT سيرتفع. السؤال الأكبر هو ما إذا كانت VPC ستساعد Fluence على جذب المزيد من المطوّرين والأحمال (workloads) والشركات.
إذا زاد التبنّي، فقد يتم نشر المزيد من الحوسبة عبر الشبكة، ما يخلق طلبًا أساسيًا أقوى وربما يحسّن الأساسيات التي تدعم FLT.
لذا أنا أراقب الاستخدام أكثر من الإعلان نفسه. إذا استمرت Fluence في إضافة بنية تحتية عملية وتحولت هذه الميزات إلى نشاط شبكي فعلي، فأعتقد أن ذلك قد يصبح محفزًا إيجابيًا لـ FLT مع مرور الوقت.
بالنسبة لي، الفرضية بسيطة: بنية تحتية أفضل → مزيد من حالات الاستخدام → مزيد من نشاط الشبكة → وربما أساسيات أقوى لـ FLT.
#DePIN #AI #Web3
https://fluence.ai/
تتيح بنية VPC الجديدة للمطوّرين تشغيل عدة أجهزة افتراضية (VMs) مع شبكة خاصة ومجموعات أمان وتحكّم في الخروج (egress) وعناوين IP عامة اختيارية وcloud-init. وبعبارة بسيطة، تجعل Fluence أكثر ملاءمة لتشغيل تطبيقات حقيقية مع عمل خدمات مختلفة معًا بشكل آمن.
ومن منظور $FLT، أرى أن الأمور تصبح مثيرة للاهتمام هنا.
ميزة بنية تحتية جديدة لا تعني تلقائيًا أن سعر FLT سيرتفع. السؤال الأكبر هو ما إذا كانت VPC ستساعد Fluence على جذب المزيد من المطوّرين والأحمال (workloads) والشركات.
إذا زاد التبنّي، فقد يتم نشر المزيد من الحوسبة عبر الشبكة، ما يخلق طلبًا أساسيًا أقوى وربما يحسّن الأساسيات التي تدعم FLT.
لذا أنا أراقب الاستخدام أكثر من الإعلان نفسه. إذا استمرت Fluence في إضافة بنية تحتية عملية وتحولت هذه الميزات إلى نشاط شبكي فعلي، فأعتقد أن ذلك قد يصبح محفزًا إيجابيًا لـ FLT مع مرور الوقت.
بالنسبة لي، الفرضية بسيطة: بنية تحتية أفضل → مزيد من حالات الاستخدام → مزيد من نشاط الشبكة → وربما أساسيات أقوى لـ FLT.
#DePIN #AI #Web3
67
·
--
صفقة حوسبة أخرى بقيمة 5.5 مليون دولار مقابل @fluence
حصلت شركة Fluence على صفقة حوسبة بقيمة 5.5 مليون دولار مع عميل يبني ذكاءً اصطناعيًا عامًا (AGI) يركز على إيجاد مسارات أسرع من علم الأحياء إلى الأدوية.
ما يلفت نظري ليس فقط حجم الصفقة.
بل المشكلة التي يجري حلها: ضمان ألا تصبح الحوسبة عنق الزجاجة.
تتزايد كثافة تطوير الذكاء الاصطناعي للحوسبة، لكن امتلاك المزيد من وحدات GPU ليس القصة كاملة. التحدي الأكبر هو إتاحة الحوسبة حيثما وحينما تكون هناك حاجة إليها.
وهنا تصبح أسواق وحدات GPU اللامركزية أمراً مثيراً للاهتمام.
تقوم Fluence ببناء سوق يمكن لموردي وحدات GPU فيه التنافس على الأحمال (workloads)، ما قد يخلق طريقة أكثر مرونة للفرق للوصول إلى الحوسبة التي تحتاجها.
أظن أننا سنسمع المزيد عن طبقة الحوسبة الداعمة للذكاء الاصطناعي، لا عن النماذج وحدها.
إن مبلغ 5.5 مليون دولار هو صفقة واحدة، لكنه يُظهر كذلك مدى قيمة الوصول الموثوق إلى حوسبة وحدات GPU الذي بات يتزايد.
جدير بالمتابعة ما الذي ستفعله Fluence بعد ذلك.
$FLT #DePIN #AI #Web3
صفقة حوسبة أخرى بقيمة 5.5 مليون دولار مقابل @Fluence
حصلت شركة Fluence على صفقة حوسبة بقيمة 5.5 مليون دولار مع عميل يبني ذكاءً اصطناعيًا عامًا (AGI) يركز على إيجاد مسارات أسرع من علم الأحياء إلى الأدوية.
ما يلفت نظري ليس فقط حجم الصفقة.
بل المشكلة التي يجري حلها: ضمان ألا تصبح الحوسبة عنق الزجاجة.
تتزايد كثافة تطوير الذكاء الاصطناعي للحوسبة، لكن امتلاك المزيد من وحدات GPU ليس القصة كاملة. التحدي الأكبر هو إتاحة الحوسبة حيثما وحينما تكون هناك حاجة إليها.
وهنا تصبح أسواق وحدات GPU اللامركزية أمراً مثيراً للاهتمام.
تقوم Fluence ببناء سوق يمكن لموردي وحدات GPU فيه التنافس على الأحمال (workloads)، ما قد يخلق طريقة أكثر مرونة للفرق للوصول إلى الحوسبة التي تحتاجها.
أظن أننا سنسمع المزيد عن طبقة الحوسبة الداعمة للذكاء الاصطناعي، لا عن النماذج وحدها.
إن مبلغ 5.5 مليون دولار هو صفقة واحدة، لكنه يُظهر كذلك مدى قيمة الوصول الموثوق إلى حوسبة وحدات GPU الذي بات يتزايد.
جدير بالمتابعة ما الذي ستفعله Fluence بعد ذلك.
$FLT #DePIN #AI #Web3
حصلت شركة Fluence على صفقة حوسبة بقيمة 5.5 مليون دولار مع عميل يبني ذكاءً اصطناعيًا عامًا (AGI) يركز على إيجاد مسارات أسرع من علم الأحياء إلى الأدوية.
ما يلفت نظري ليس فقط حجم الصفقة.
بل المشكلة التي يجري حلها: ضمان ألا تصبح الحوسبة عنق الزجاجة.
تتزايد كثافة تطوير الذكاء الاصطناعي للحوسبة، لكن امتلاك المزيد من وحدات GPU ليس القصة كاملة. التحدي الأكبر هو إتاحة الحوسبة حيثما وحينما تكون هناك حاجة إليها.
وهنا تصبح أسواق وحدات GPU اللامركزية أمراً مثيراً للاهتمام.
تقوم Fluence ببناء سوق يمكن لموردي وحدات GPU فيه التنافس على الأحمال (workloads)، ما قد يخلق طريقة أكثر مرونة للفرق للوصول إلى الحوسبة التي تحتاجها.
أظن أننا سنسمع المزيد عن طبقة الحوسبة الداعمة للذكاء الاصطناعي، لا عن النماذج وحدها.
إن مبلغ 5.5 مليون دولار هو صفقة واحدة، لكنه يُظهر كذلك مدى قيمة الوصول الموثوق إلى حوسبة وحدات GPU الذي بات يتزايد.
جدير بالمتابعة ما الذي ستفعله Fluence بعد ذلك.
$FLT #DePIN #AI #Web3
58
·
--
@fluence : سوق الـ GPU الخفي
أعباء عمل الذكاء الاصطناعي تتوسع، ومراكز البيانات تكبر، والشركات تنفق بكثافة على الحوسبة.
لكن هناك جانبًا آخر من قصة الـ GPU أعتقد أنه يستحق المتابعة:
بعض العتاد يبقى خاملاً بين أعباء العمل. وبعضه يُستخدم بشكل غير كافٍ. وبعض موارد الحوسبة يصعب على الآخرين الوصول إليها ببساطة.
وهذا يجعل مستقبل الحوسبة أقل تعلقًا بمجرد إضافة المزيد من وحدات GPU، وأكثر تعلقًا بمدى الكفاءة التي نستطيع بها استخدام وحدات GPU الموجودة بالفعل.
@fluence الفكرة بسيطة لكنها مثيرة للاهتمام: إنشاء بنية تحتية يمكنها ربط الحوسبة المتاحة بالأشخاص وأعباء العمل التي تحتاجها.
إذا استمر الطلب على الذكاء الاصطناعي في التسارع، أعتقد أن النقاش سيتحول تدريجيًا من:
"من لديه أكبر عدد من وحدات GPU؟"
aلى:
"من يستطيع إتاحة أكبر قدر من الحوسبة، مع المرونة، والاستخدام الأكثر كفاءة؟"
قد لا يقتصر اقتصاد الـ GPU على العتاد بعد الآن.
بل قد يتعلق أيضًا ببناء أسواق أفضل حول الحوسبة الموجودة بالفعل.
#DePIN #AI #Web3
@Fluence : سوق الـ GPU الخفي
أعباء عمل الذكاء الاصطناعي تتوسع، ومراكز البيانات تكبر، والشركات تنفق بكثافة على الحوسبة.
لكن هناك جانبًا آخر من قصة الـ GPU أعتقد أنه يستحق المتابعة:
بعض العتاد يبقى خاملاً بين أعباء العمل. وبعضه يُستخدم بشكل غير كافٍ. وبعض موارد الحوسبة يصعب على الآخرين الوصول إليها ببساطة.
وهذا يجعل مستقبل الحوسبة أقل تعلقًا بمجرد إضافة المزيد من وحدات GPU، وأكثر تعلقًا بمدى الكفاءة التي نستطيع بها استخدام وحدات GPU الموجودة بالفعل.
@Fluence الفكرة بسيطة لكنها مثيرة للاهتمام: إنشاء بنية تحتية يمكنها ربط الحوسبة المتاحة بالأشخاص وأعباء العمل التي تحتاجها.
إذا استمر الطلب على الذكاء الاصطناعي في التسارع، أعتقد أن النقاش سيتحول تدريجيًا من:
"من لديه أكبر عدد من وحدات GPU؟"
aلى:
"من يستطيع إتاحة أكبر قدر من الحوسبة، مع المرونة، والاستخدام الأكثر كفاءة؟"
قد لا يقتصر اقتصاد الـ GPU على العتاد بعد الآن.
بل قد يتعلق أيضًا ببناء أسواق أفضل حول الحوسبة الموجودة بالفعل.
#DePIN #AI #Web3
أعباء عمل الذكاء الاصطناعي تتوسع، ومراكز البيانات تكبر، والشركات تنفق بكثافة على الحوسبة.
لكن هناك جانبًا آخر من قصة الـ GPU أعتقد أنه يستحق المتابعة:
بعض العتاد يبقى خاملاً بين أعباء العمل. وبعضه يُستخدم بشكل غير كافٍ. وبعض موارد الحوسبة يصعب على الآخرين الوصول إليها ببساطة.
وهذا يجعل مستقبل الحوسبة أقل تعلقًا بمجرد إضافة المزيد من وحدات GPU، وأكثر تعلقًا بمدى الكفاءة التي نستطيع بها استخدام وحدات GPU الموجودة بالفعل.
@Fluence الفكرة بسيطة لكنها مثيرة للاهتمام: إنشاء بنية تحتية يمكنها ربط الحوسبة المتاحة بالأشخاص وأعباء العمل التي تحتاجها.
إذا استمر الطلب على الذكاء الاصطناعي في التسارع، أعتقد أن النقاش سيتحول تدريجيًا من:
"من لديه أكبر عدد من وحدات GPU؟"
aلى:
"من يستطيع إتاحة أكبر قدر من الحوسبة، مع المرونة، والاستخدام الأكثر كفاءة؟"
قد لا يقتصر اقتصاد الـ GPU على العتاد بعد الآن.
بل قد يتعلق أيضًا ببناء أسواق أفضل حول الحوسبة الموجودة بالفعل.
#DePIN #AI #Web3
75
·
--
أسرع وحدة معالجة رسومات (GPU) على الورق ليست بالضرورة أفضل خيار لكل نوع من الأحمال.
قد يخبرك معيار أداء (Benchmark) أي وحدة GPU يمكنها دفع أكبر عدد من الرموز (tokens) في الثانية، لكن النشر الفعلي يواجه متغيرات أكثر للتعامل معها.
حجم النموذج، طول الإخراج، متطلبات الذاكرة، التزامن، المنطقة (region)، التوفر، وبالطبع التكلفة الفعلية لتشغيل الحمل—كلها قد تغيّر المعادلة.
وهنا تتبع @fluence نهجًا مثيرًا للاهتمام.
من خلال مزادات عُناقيد وحدات معالجة الرسومات (GPU Cluster Auctions)، يمكن للمشترين مقارنة العروض من مقدّمين مختلفين بناءً على نوع الـGPU، والسعة، والمنطقة، والتسعير، والتوفر.
وهذا ينقل قرار الشراء بعيدًا عن مجرد مطاردة أكثر العتاد أداءً.
بدلًا من أن تسأل:
“أي GPU هو الأسرع؟”
قد يكون السؤال الأفضل:
أي GPU يمنحني الأداء الذي أحتاجه بسعر منطقي فعلًا؟
لأن وحدة GPU أقوى قد تكلف أكثر بكثير لكنها لا توفر ميزة ملموسة لحملك المحدد، فقد لا يكون الأداء الإضافي يستحق الدفع.
وإذا كانت وحدة GPU أخرى تستطيع التعامل مع نفس الحمل بتكلفة أقل، فإن هذا الفرق يبدأ بالظهور كعامل مهم على نطاق واسع.
ومع استمرار تطور أحمال العمل الخاصة بالذكاء الاصطناعي، لن يكون الطلب على وحدات GPU مقتصرًا فقط على إيجاد المزيد من القدرة الحاسوبية.
بل سيكون أيضًا حول العثور على القدرة الحاسوبية المناسبة، في المكان المناسب، وبالسعر المناسب.
وهنا قد يصبح اكتشاف سعر GPU أكثر أهمية بشكل متزايد.
#Flt #DePIN #Web3 #AI
أسرع وحدة معالجة رسومات (GPU) على الورق ليست بالضرورة أفضل خيار لكل نوع من الأحمال.
قد يخبرك معيار أداء (Benchmark) أي وحدة GPU يمكنها دفع أكبر عدد من الرموز (tokens) في الثانية، لكن النشر الفعلي يواجه متغيرات أكثر للتعامل معها.
حجم النموذج، طول الإخراج، متطلبات الذاكرة، التزامن، المنطقة (region)، التوفر، وبالطبع التكلفة الفعلية لتشغيل الحمل—كلها قد تغيّر المعادلة.
وهنا تتبع @Fluence نهجًا مثيرًا للاهتمام.
من خلال مزادات عُناقيد وحدات معالجة الرسومات (GPU Cluster Auctions)، يمكن للمشترين مقارنة العروض من مقدّمين مختلفين بناءً على نوع الـGPU، والسعة، والمنطقة، والتسعير، والتوفر.
وهذا ينقل قرار الشراء بعيدًا عن مجرد مطاردة أكثر العتاد أداءً.
بدلًا من أن تسأل:
“أي GPU هو الأسرع؟”
قد يكون السؤال الأفضل:
أي GPU يمنحني الأداء الذي أحتاجه بسعر منطقي فعلًا؟
لأن وحدة GPU أقوى قد تكلف أكثر بكثير لكنها لا توفر ميزة ملموسة لحملك المحدد، فقد لا يكون الأداء الإضافي يستحق الدفع.
وإذا كانت وحدة GPU أخرى تستطيع التعامل مع نفس الحمل بتكلفة أقل، فإن هذا الفرق يبدأ بالظهور كعامل مهم على نطاق واسع.
ومع استمرار تطور أحمال العمل الخاصة بالذكاء الاصطناعي، لن يكون الطلب على وحدات GPU مقتصرًا فقط على إيجاد المزيد من القدرة الحاسوبية.
بل سيكون أيضًا حول العثور على القدرة الحاسوبية المناسبة، في المكان المناسب، وبالسعر المناسب.
وهنا قد يصبح اكتشاف سعر GPU أكثر أهمية بشكل متزايد.
#Flt #DePIN #Web3 #AI
قد يخبرك معيار أداء (Benchmark) أي وحدة GPU يمكنها دفع أكبر عدد من الرموز (tokens) في الثانية، لكن النشر الفعلي يواجه متغيرات أكثر للتعامل معها.
حجم النموذج، طول الإخراج، متطلبات الذاكرة، التزامن، المنطقة (region)، التوفر، وبالطبع التكلفة الفعلية لتشغيل الحمل—كلها قد تغيّر المعادلة.
وهنا تتبع @Fluence نهجًا مثيرًا للاهتمام.
من خلال مزادات عُناقيد وحدات معالجة الرسومات (GPU Cluster Auctions)، يمكن للمشترين مقارنة العروض من مقدّمين مختلفين بناءً على نوع الـGPU، والسعة، والمنطقة، والتسعير، والتوفر.
وهذا ينقل قرار الشراء بعيدًا عن مجرد مطاردة أكثر العتاد أداءً.
بدلًا من أن تسأل:
“أي GPU هو الأسرع؟”
قد يكون السؤال الأفضل:
أي GPU يمنحني الأداء الذي أحتاجه بسعر منطقي فعلًا؟
لأن وحدة GPU أقوى قد تكلف أكثر بكثير لكنها لا توفر ميزة ملموسة لحملك المحدد، فقد لا يكون الأداء الإضافي يستحق الدفع.
وإذا كانت وحدة GPU أخرى تستطيع التعامل مع نفس الحمل بتكلفة أقل، فإن هذا الفرق يبدأ بالظهور كعامل مهم على نطاق واسع.
ومع استمرار تطور أحمال العمل الخاصة بالذكاء الاصطناعي، لن يكون الطلب على وحدات GPU مقتصرًا فقط على إيجاد المزيد من القدرة الحاسوبية.
بل سيكون أيضًا حول العثور على القدرة الحاسوبية المناسبة، في المكان المناسب، وبالسعر المناسب.
وهنا قد يصبح اكتشاف سعر GPU أكثر أهمية بشكل متزايد.
#Flt #DePIN #Web3 #AI
58
·
--
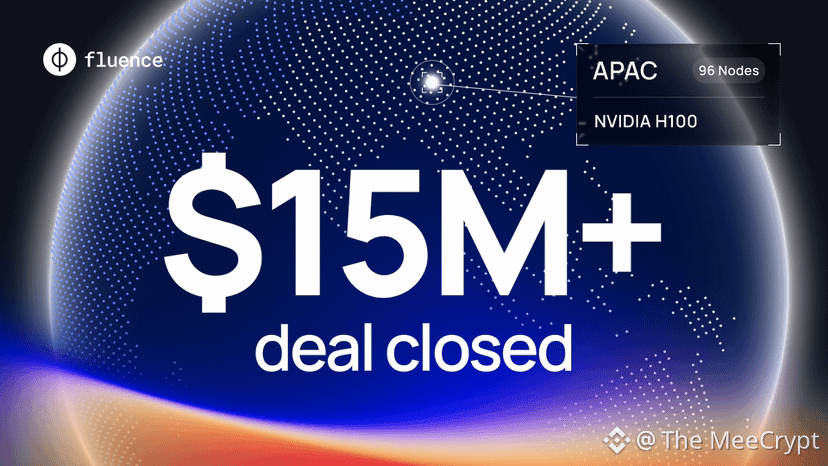
@fluence GPU مزادات GPU الجديدة وصلت للتو بعقد آخر بقيمة 15.4 مليون دولار+
نجحت شركة Fluence في تأمين صفقة رئيسية أخرى للـ GPU عبر منصة المزادات الخاصة بها.
تغطي هذه الصفقة 96 عقدة من طراز H100 عبر آسيا، مع الانتقال إلى مرحلة الإنتاج لدعم استدلال الذكاء الاصطناعي وتدريب النماذج.
الجزء المثير للاهتمام ليس فقط حجم الصفقة.
بل يشير ذلك إلى أن الطلب الحقيقي على وحدات GPU يتحرك عبر المنافسة بالمزايدات، حيث يربط بين المشترين الباحثين عن سعة وبين مقدمي الخدمات الذين لديهم وحدات GPU متاحة.
ومع تزايد الصفقات عالية القيمة التي تصل عبر المنصة، أصبحت مزادات GPU جزءًا مثيرًا للاهتمام من سوق بنية الذكاء الاصطناعي التحتية التي يستحق متابعتها.
#FLT #DePIN #Web3
@Fluence GPU مزادات GPU الجديدة وصلت للتو بعقد آخر بقيمة 15.4 مليون دولار+
نجحت شركة Fluence في تأمين صفقة رئيسية أخرى للـ GPU عبر منصة المزادات الخاصة بها.
تغطي هذه الصفقة 96 عقدة من طراز H100 عبر آسيا، مع الانتقال إلى مرحلة الإنتاج لدعم استدلال الذكاء الاصطناعي وتدريب النماذج.
الجزء المثير للاهتمام ليس فقط حجم الصفقة.
بل يشير ذلك إلى أن الطلب الحقيقي على وحدات GPU يتحرك عبر المنافسة بالمزايدات، حيث يربط بين المشترين الباحثين عن سعة وبين مقدمي الخدمات الذين لديهم وحدات GPU متاحة.
ومع تزايد الصفقات عالية القيمة التي تصل عبر المنصة، أصبحت مزادات GPU جزءًا مثيرًا للاهتمام من سوق بنية الذكاء الاصطناعي التحتية التي يستحق متابعتها.
#FLT #DePIN #Web3
نجحت شركة Fluence في تأمين صفقة رئيسية أخرى للـ GPU عبر منصة المزادات الخاصة بها.
تغطي هذه الصفقة 96 عقدة من طراز H100 عبر آسيا، مع الانتقال إلى مرحلة الإنتاج لدعم استدلال الذكاء الاصطناعي وتدريب النماذج.
الجزء المثير للاهتمام ليس فقط حجم الصفقة.
بل يشير ذلك إلى أن الطلب الحقيقي على وحدات GPU يتحرك عبر المنافسة بالمزايدات، حيث يربط بين المشترين الباحثين عن سعة وبين مقدمي الخدمات الذين لديهم وحدات GPU متاحة.
ومع تزايد الصفقات عالية القيمة التي تصل عبر المنصة، أصبحت مزادات GPU جزءًا مثيرًا للاهتمام من سوق بنية الذكاء الاصطناعي التحتية التي يستحق متابعتها.
#FLT #DePIN #Web3
79
·
--
هل تفضّل حمل توكن يمتلك منفعة فعلية أم توكن لا يجذب الانتباه إلا عندما يبدأ الرسم البياني بالتحرك؟
هذا ما يجعل $FLT يستحق الاهتمام.
@fluence يجري بناء بنية تحتية للحوسبة اللامركزية لاقتصاد الذكاء الاصطناعي، و$FLT يقع في قلب اقتصاديات شبكته.
فما الذي يمكن أن يفعله $FLT فعليًا؟
→ الحصص (Staking): يمكن إيداع FLT للمساعدة في تأمين وتوفير موارد الحوسبة، مع تمكّن حاملي التوكن من المشاركة في الإيداع.
→ الحوكمة: يمكن لحاملي FLT المشاركة في حوكمة Fluence DAO والتصويت على المقترحات التي تشكل مسار الشبكة.
→ حوافز الشبكة: يُعد $FLT جزءًا من نظام الحوافز الذي ينسّق مزودي الحوسبة ويساعد على تأمين الشبكة.
ما أراه مثيرًا للاهتمام هو أن التوكن ليس منفصلًا بالكامل عن البنية التحتية.
تركّز الشبكة على الذكاء الاصطناعي وحوسبة GPU، وتقول Fluence إنها تقدم الآن 1,400+ وحدة GPU عبر 32 منطقة و71 مركز بيانات.
وهنا أعتقد أن بعض الناس قد يكونون فاتهم الصورة الأكبر أثناء آخر حركة لـ $FLT.
الضخ (Pump) يجذب انتباه الجميع.
المنفعة هي ما يجعلني أستمر في المتابعة.
السؤال المثير للاهتمام الآن ليس فقط إلى أين سيتجه $FLT بعد ذلك.
بل: كم قيمة يمكن بناؤها حول البنية التحتية التي يدعمها.
الذكاء الاصطناعي يحتاج إلى حوسبة.
Fluence تبني طبقة الحوسبة.
$FLT جزء من طبقة الاقتصاد خلف ذلك.
هل تعتقد أن توكنات المنفعة ستتفوق على صفقات السرد/القصّة البحتة في المرحلة القادمة من DePIN؟
#Fluence #DePIN #AI
هل تفضّل حمل توكن يمتلك منفعة فعلية أم توكن لا يجذب الانتباه إلا عندما يبدأ الرسم البياني بالتحرك؟
هذا ما يجعل $FLT يستحق الاهتمام.
@Fluence يجري بناء بنية تحتية للحوسبة اللامركزية لاقتصاد الذكاء الاصطناعي، و$FLT يقع في قلب اقتصاديات شبكته.
فما الذي يمكن أن يفعله $FLT فعليًا؟
→ الحصص (Staking): يمكن إيداع FLT للمساعدة في تأمين وتوفير موارد الحوسبة، مع تمكّن حاملي التوكن من المشاركة في الإيداع.
→ الحوكمة: يمكن لحاملي FLT المشاركة في حوكمة Fluence DAO والتصويت على المقترحات التي تشكل مسار الشبكة.
→ حوافز الشبكة: يُعد $FLT جزءًا من نظام الحوافز الذي ينسّق مزودي الحوسبة ويساعد على تأمين الشبكة.
ما أراه مثيرًا للاهتمام هو أن التوكن ليس منفصلًا بالكامل عن البنية التحتية.
تركّز الشبكة على الذكاء الاصطناعي وحوسبة GPU، وتقول Fluence إنها تقدم الآن 1,400+ وحدة GPU عبر 32 منطقة و71 مركز بيانات.
وهنا أعتقد أن بعض الناس قد يكونون فاتهم الصورة الأكبر أثناء آخر حركة لـ $FLT.
الضخ (Pump) يجذب انتباه الجميع.
المنفعة هي ما يجعلني أستمر في المتابعة.
السؤال المثير للاهتمام الآن ليس فقط إلى أين سيتجه $FLT بعد ذلك.
بل: كم قيمة يمكن بناؤها حول البنية التحتية التي يدعمها.
الذكاء الاصطناعي يحتاج إلى حوسبة.
Fluence تبني طبقة الحوسبة.
$FLT جزء من طبقة الاقتصاد خلف ذلك.
هل تعتقد أن توكنات المنفعة ستتفوق على صفقات السرد/القصّة البحتة في المرحلة القادمة من DePIN؟
#Fluence #DePIN #AI
هذا ما يجعل $FLT يستحق الاهتمام.
@Fluence يجري بناء بنية تحتية للحوسبة اللامركزية لاقتصاد الذكاء الاصطناعي، و$FLT يقع في قلب اقتصاديات شبكته.
فما الذي يمكن أن يفعله $FLT فعليًا؟
→ الحصص (Staking): يمكن إيداع FLT للمساعدة في تأمين وتوفير موارد الحوسبة، مع تمكّن حاملي التوكن من المشاركة في الإيداع.
→ الحوكمة: يمكن لحاملي FLT المشاركة في حوكمة Fluence DAO والتصويت على المقترحات التي تشكل مسار الشبكة.
→ حوافز الشبكة: يُعد $FLT جزءًا من نظام الحوافز الذي ينسّق مزودي الحوسبة ويساعد على تأمين الشبكة.
ما أراه مثيرًا للاهتمام هو أن التوكن ليس منفصلًا بالكامل عن البنية التحتية.
تركّز الشبكة على الذكاء الاصطناعي وحوسبة GPU، وتقول Fluence إنها تقدم الآن 1,400+ وحدة GPU عبر 32 منطقة و71 مركز بيانات.
وهنا أعتقد أن بعض الناس قد يكونون فاتهم الصورة الأكبر أثناء آخر حركة لـ $FLT.
الضخ (Pump) يجذب انتباه الجميع.
المنفعة هي ما يجعلني أستمر في المتابعة.
السؤال المثير للاهتمام الآن ليس فقط إلى أين سيتجه $FLT بعد ذلك.
بل: كم قيمة يمكن بناؤها حول البنية التحتية التي يدعمها.
الذكاء الاصطناعي يحتاج إلى حوسبة.
Fluence تبني طبقة الحوسبة.
$FLT جزء من طبقة الاقتصاد خلف ذلك.
هل تعتقد أن توكنات المنفعة ستتفوق على صفقات السرد/القصّة البحتة في المرحلة القادمة من DePIN؟
#Fluence #DePIN #AI
97
·
--
<keep>$6M IN GPU CONTRACTS: @fluence
أصبحت وحدات معالجة الرسومات (GPUs) نادرةً ومكلفةً بشكل متزايد، ومهمةً على نحو متزايد للفرق التي تبني منتجات الذكاء الاصطناعي. لكن امتلاك وحدات GPU ليس سوى نصف المشكلة. أما النصف الآخر فهو ربط السعة المتاحة بالفرق التي تحتاج إليها بالفعل.
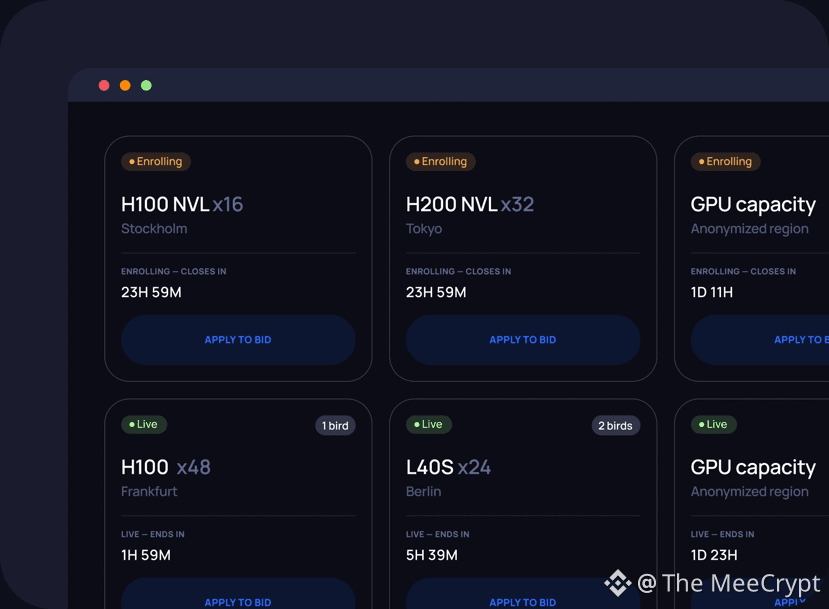
وهنا تأتي مزادات https://auctions.fluence.network/ لـ GPU.
منذ إطلاق السوق، تم بالفعل تسجيل 6 ملايين دولار من عقود عنقود GPU.
النموذج بسيط:
→ تقوم الفرق بنشر احتياجها من الحوسبة
→ يتنافس مقدمو الخدمة عبر العطاءات
→ يقارن المشترون السعر وSLA ونوافذ الإيجار
→ تُبرم العقود بناءً على العطاء المقبول
يعرض السوق الحالي 6,468 وحدة GPU متاحة عبر 4 دول.
ما أجدُه مثيرًا للاهتمام هنا هو التحوّل من مجرد تأجير الحوسبة إلى خلق سوق أكثر تنافسية حول سعة وحدات GPU.
يحتاج الذكاء الاصطناعي إلى مزيد من الحوسبة.
لكنّه يحتاج أيضًا إلى طرق أفضل لتوزيع الحوسبة التي لدينا بالفعل.
وتسعى Fluence إلى معالجة هذا الجانب من المعادلة.
تحتاج حوسبة؟ لديك سعة؟
#Fluence #DePIN #AI #Web3
<keep>$6M IN GPU CONTRACTS: @Fluence
أصبحت وحدات معالجة الرسومات (GPUs) نادرةً ومكلفةً بشكل متزايد، ومهمةً على نحو متزايد للفرق التي تبني منتجات الذكاء الاصطناعي. لكن امتلاك وحدات GPU ليس سوى نصف المشكلة. أما النصف الآخر فهو ربط السعة المتاحة بالفرق التي تحتاج إليها بالفعل.
وهنا تأتي مزادات https://auctions.fluence.network/ لـ GPU.
منذ إطلاق السوق، تم بالفعل تسجيل 6 ملايين دولار من عقود عنقود GPU.
النموذج بسيط:
→ تقوم الفرق بنشر احتياجها من الحوسبة
→ يتنافس مقدمو الخدمة عبر العطاءات
→ يقارن المشترون السعر وSLA ونوافذ الإيجار
→ تُبرم العقود بناءً على العطاء المقبول
يعرض السوق الحالي 6,468 وحدة GPU متاحة عبر 4 دول.
ما أجدُه مثيرًا للاهتمام هنا هو التحوّل من مجرد تأجير الحوسبة إلى خلق سوق أكثر تنافسية حول سعة وحدات GPU.
يحتاج الذكاء الاصطناعي إلى مزيد من الحوسبة.
لكنّه يحتاج أيضًا إلى طرق أفضل لتوزيع الحوسبة التي لدينا بالفعل.
وتسعى Fluence إلى معالجة هذا الجانب من المعادلة.
تحتاج حوسبة؟ لديك سعة؟
#Fluence #DePIN #AI #Web3
أصبحت وحدات معالجة الرسومات (GPUs) نادرةً ومكلفةً بشكل متزايد، ومهمةً على نحو متزايد للفرق التي تبني منتجات الذكاء الاصطناعي. لكن امتلاك وحدات GPU ليس سوى نصف المشكلة. أما النصف الآخر فهو ربط السعة المتاحة بالفرق التي تحتاج إليها بالفعل.
وهنا تأتي مزادات https://auctions.fluence.network/ لـ GPU.
منذ إطلاق السوق، تم بالفعل تسجيل 6 ملايين دولار من عقود عنقود GPU.
النموذج بسيط:
→ تقوم الفرق بنشر احتياجها من الحوسبة
→ يتنافس مقدمو الخدمة عبر العطاءات
→ يقارن المشترون السعر وSLA ونوافذ الإيجار
→ تُبرم العقود بناءً على العطاء المقبول
يعرض السوق الحالي 6,468 وحدة GPU متاحة عبر 4 دول.
ما أجدُه مثيرًا للاهتمام هنا هو التحوّل من مجرد تأجير الحوسبة إلى خلق سوق أكثر تنافسية حول سعة وحدات GPU.
يحتاج الذكاء الاصطناعي إلى مزيد من الحوسبة.
لكنّه يحتاج أيضًا إلى طرق أفضل لتوزيع الحوسبة التي لدينا بالفعل.
وتسعى Fluence إلى معالجة هذا الجانب من المعادلة.
تحتاج حوسبة؟ لديك سعة؟
#Fluence #DePIN #AI #Web3
80
·
--
لماذا يلفت DTEC الانتباه في مجال DePIN والتنقل؟
بدلًا من التعامل مع المركبات كآلات سلبية، يقوم @DtecAI ببناء الفكرة القائلة بأن التنقل اليومي يمكن أن يصبح جزءًا من شبكة لا مركزية للبيانات والذكاء الاصطناعي.
محركات القيمة الرئيسية:
• البيانات الواقعية: يمكن أن تصبح بيانات المركبات والتنقل موردًا قيّمًا للذكاء الاصطناعي والتطبيقات المتصلة.
• بنية تحتية لـ DePIN: تساهم المركبات والأجهزة المتصلة في تزويد الشبكة ببيانات واقعية عبر شبكة لا مركزية.
• تنقل مدعوم بالذكاء الاصطناعي: تجمع بنية DTEC بين بيانات المركبة ومُدخلات إنترنت الأشياء والذكاء الاصطناعي لإنشاء تجارب تنقل أكثر تخصيصًا.
• مشاركة السائق: صُمّم النظام البيئي لمكافأة المستخدمين على تقديم بيانات قيّمة للشبكة عبر توكن DTEC.
إذا تمكّنت بيانات التنقل اللا مركزية من التوسع بفعالية، فقد تمتد الفرصة بعيدًا عن عالم العملات المشفرة لتشمل الذكاء الاصطناعي وبيانات السيارات والمركبات المتصلة والنقل الذكي.
الجزء المثير بالنسبة لي هو التحول من مجرد استخدام مركبة إلى جعل المركبة جزءًا من شبكة بيانات أكبر.
هل أنت متفائل بشأن أطروحة $DTEC؟ 👀
#DePIN #AI #Web3 #DTEC
لماذا يلفت DTEC الانتباه في مجال DePIN والتنقل؟
بدلًا من التعامل مع المركبات كآلات سلبية، يقوم @DtecAI ببناء الفكرة القائلة بأن التنقل اليومي يمكن أن يصبح جزءًا من شبكة لا مركزية للبيانات والذكاء الاصطناعي.
محركات القيمة الرئيسية:
• البيانات الواقعية: يمكن أن تصبح بيانات المركبات والتنقل موردًا قيّمًا للذكاء الاصطناعي والتطبيقات المتصلة.
• بنية تحتية لـ DePIN: تساهم المركبات والأجهزة المتصلة في تزويد الشبكة ببيانات واقعية عبر شبكة لا مركزية.
• تنقل مدعوم بالذكاء الاصطناعي: تجمع بنية DTEC بين بيانات المركبة ومُدخلات إنترنت الأشياء والذكاء الاصطناعي لإنشاء تجارب تنقل أكثر تخصيصًا.
• مشاركة السائق: صُمّم النظام البيئي لمكافأة المستخدمين على تقديم بيانات قيّمة للشبكة عبر توكن DTEC.
إذا تمكّنت بيانات التنقل اللا مركزية من التوسع بفعالية، فقد تمتد الفرصة بعيدًا عن عالم العملات المشفرة لتشمل الذكاء الاصطناعي وبيانات السيارات والمركبات المتصلة والنقل الذكي.
الجزء المثير بالنسبة لي هو التحول من مجرد استخدام مركبة إلى جعل المركبة جزءًا من شبكة بيانات أكبر.
هل أنت متفائل بشأن أطروحة $DTEC؟ 👀
#DePIN #AI #Web3 #DTEC
بدلًا من التعامل مع المركبات كآلات سلبية، يقوم @DtecAI ببناء الفكرة القائلة بأن التنقل اليومي يمكن أن يصبح جزءًا من شبكة لا مركزية للبيانات والذكاء الاصطناعي.
محركات القيمة الرئيسية:
• البيانات الواقعية: يمكن أن تصبح بيانات المركبات والتنقل موردًا قيّمًا للذكاء الاصطناعي والتطبيقات المتصلة.
• بنية تحتية لـ DePIN: تساهم المركبات والأجهزة المتصلة في تزويد الشبكة ببيانات واقعية عبر شبكة لا مركزية.
• تنقل مدعوم بالذكاء الاصطناعي: تجمع بنية DTEC بين بيانات المركبة ومُدخلات إنترنت الأشياء والذكاء الاصطناعي لإنشاء تجارب تنقل أكثر تخصيصًا.
• مشاركة السائق: صُمّم النظام البيئي لمكافأة المستخدمين على تقديم بيانات قيّمة للشبكة عبر توكن DTEC.
إذا تمكّنت بيانات التنقل اللا مركزية من التوسع بفعالية، فقد تمتد الفرصة بعيدًا عن عالم العملات المشفرة لتشمل الذكاء الاصطناعي وبيانات السيارات والمركبات المتصلة والنقل الذكي.
الجزء المثير بالنسبة لي هو التحول من مجرد استخدام مركبة إلى جعل المركبة جزءًا من شبكة بيانات أكبر.
هل أنت متفائل بشأن أطروحة $DTEC؟ 👀
#DePIN #AI #Web3 #DTEC
1
65
·
--
هل يُعدّ DTEC الخيار الأهم في مجال التنقّل اللامركزي (DePIN Mobility)؟
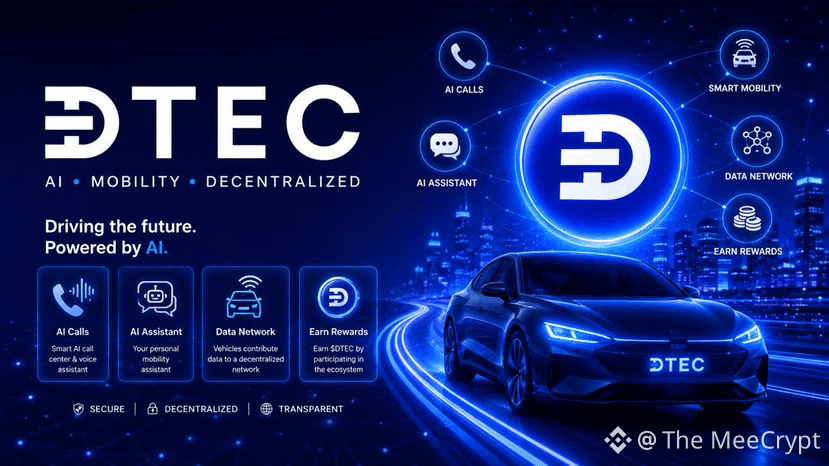
إن إضفاء اللامركزية على التنقّل ليس مجرد ترند، بل قد يعيد تشكيل طريقة تفاعل المركبات والبيانات والذكاء الاصطناعي. يعمل DTEC على بناء منظومة تربط المركبات والبيانات الواقعية والذكاء الاصطناعي والبنية التحتية اللامركزية عبر شبكة التنقّل الخاصة به.
أبرز النقاط:
• الربح من مركبتك: ساهم ببيانات المركبات والتنقّل في الشبكة واحصل على مكافآت مقابل المشاركة.
• تنقّل مدعوم بالذكاء الاصطناعي: يجمع Dtec بين بيانات المركبات الواقعية والذكاء الاصطناعي لتمكين تطبيقات تنقّل أكثر ذكاءً.
• بيانات لا مركزية: يمكن لبيانات المركبات المُولَّدة أن تصبح جزءًا من بنية تحتية لامركزية مفتوحة بدلًا من البقاء محبوسة داخل الأنظمة المركزية.
• مركز اتصال بالذكاء الاصطناعي: يطرح Dtec أيضًا الذكاء الاصطناعي في اتصالات الأعمال، للمساعدة في أتمتة تفاعلات العملاء والدعم.
• DePIN واقعي على أرض الواقع: بدل الاعتماد فقط على الأصول الرقمية، يربط Dtec البنية التحتية اللامركزية بالمركبات المادية والتنقّل اليومي.
مع تلاقي DePIN والذكاء الاصطناعي والتنقّل المتصل، يواصل DTEC البناء عند نقطة تقاطع مثيرة للاهتمام.
قد يصبح $DTEC أحد أكبر المشاريع التي تُعرّف جيل التنقّل اللامركزي القادم.
#Dtec #AI #DePIN
هل يُعدّ DTEC الخيار الأهم في مجال التنقّل اللامركزي (DePIN Mobility)؟
إن إضفاء اللامركزية على التنقّل ليس مجرد ترند، بل قد يعيد تشكيل طريقة تفاعل المركبات والبيانات والذكاء الاصطناعي. يعمل DTEC على بناء منظومة تربط المركبات والبيانات الواقعية والذكاء الاصطناعي والبنية التحتية اللامركزية عبر شبكة التنقّل الخاصة به.
أبرز النقاط:
• الربح من مركبتك: ساهم ببيانات المركبات والتنقّل في الشبكة واحصل على مكافآت مقابل المشاركة.
• تنقّل مدعوم بالذكاء الاصطناعي: يجمع Dtec بين بيانات المركبات الواقعية والذكاء الاصطناعي لتمكين تطبيقات تنقّل أكثر ذكاءً.
• بيانات لا مركزية: يمكن لبيانات المركبات المُولَّدة أن تصبح جزءًا من بنية تحتية لامركزية مفتوحة بدلًا من البقاء محبوسة داخل الأنظمة المركزية.
• مركز اتصال بالذكاء الاصطناعي: يطرح Dtec أيضًا الذكاء الاصطناعي في اتصالات الأعمال، للمساعدة في أتمتة تفاعلات العملاء والدعم.
• DePIN واقعي على أرض الواقع: بدل الاعتماد فقط على الأصول الرقمية، يربط Dtec البنية التحتية اللامركزية بالمركبات المادية والتنقّل اليومي.
مع تلاقي DePIN والذكاء الاصطناعي والتنقّل المتصل، يواصل DTEC البناء عند نقطة تقاطع مثيرة للاهتمام.
قد يصبح $DTEC أحد أكبر المشاريع التي تُعرّف جيل التنقّل اللامركزي القادم.
#Dtec #AI #DePIN
إن إضفاء اللامركزية على التنقّل ليس مجرد ترند، بل قد يعيد تشكيل طريقة تفاعل المركبات والبيانات والذكاء الاصطناعي. يعمل DTEC على بناء منظومة تربط المركبات والبيانات الواقعية والذكاء الاصطناعي والبنية التحتية اللامركزية عبر شبكة التنقّل الخاصة به.
أبرز النقاط:
• الربح من مركبتك: ساهم ببيانات المركبات والتنقّل في الشبكة واحصل على مكافآت مقابل المشاركة.
• تنقّل مدعوم بالذكاء الاصطناعي: يجمع Dtec بين بيانات المركبات الواقعية والذكاء الاصطناعي لتمكين تطبيقات تنقّل أكثر ذكاءً.
• بيانات لا مركزية: يمكن لبيانات المركبات المُولَّدة أن تصبح جزءًا من بنية تحتية لامركزية مفتوحة بدلًا من البقاء محبوسة داخل الأنظمة المركزية.
• مركز اتصال بالذكاء الاصطناعي: يطرح Dtec أيضًا الذكاء الاصطناعي في اتصالات الأعمال، للمساعدة في أتمتة تفاعلات العملاء والدعم.
• DePIN واقعي على أرض الواقع: بدل الاعتماد فقط على الأصول الرقمية، يربط Dtec البنية التحتية اللامركزية بالمركبات المادية والتنقّل اليومي.
مع تلاقي DePIN والذكاء الاصطناعي والتنقّل المتصل، يواصل DTEC البناء عند نقطة تقاطع مثيرة للاهتمام.
قد يصبح $DTEC أحد أكبر المشاريع التي تُعرّف جيل التنقّل اللامركزي القادم.
#Dtec #AI #DePIN
1
54
·
--
@fluence : تحويل سعة وحدات معالجة الرسوميات (GPU) إلى سوق
تتسبب أحمال العمل الخاصة بالذكاء الاصطناعي في طلب ضخم على وحدات معالجة الرسوميات (GPUs)، لكن لا يزال الوصول إلى العتاد المناسب مكلفًا وصعبًا.
تتعامل Fluence مع هذا الأمر بطريقة مختلفة.
فشبكتها اللامركزية للحوسبة تربط البنية التحتية المتاحة بالعملاء، بينما تقدم مزاد وحدات معالجة الرسوميات (GPU Auction) نموذجًا لسوق يمكن من خلاله المزايدة على سعة الـGPU بدلًا من شرائها ببساطة عبر تسعير سحابي ثابت.
بدلًا من أن يدفع كل عميل المعدل المحدد نفسه مسبقًا، يمكن أن يساعد المزاد في مواءمة توريد وحدات الـGPU المتاحة مع الطلب الحقيقي.
بالنسبة للمزوّدين، فهذا يخلق طريقة إضافية لتحقيق الدخل من عتادهم.
وبالنسبة للعملاء، فإنه يتيح إمكانية العثور على وصول تنافسي للحوسبة التي يحتاجون إليها.
وهنا يصبح طرح Fluence الأوسع أكثر إثارة للاهتمام.
قد لا يكون مستقبل الحوسبة متعلقًا بشركة واحدة تمتلك كل العتاد.
قد يكون الأمر متعلقًا بإنشاء أسواق مفتوحة حول العتاد الذي يتوفر بالفعل.
وهذا هو جانب البنية التحتية وراء $FLT الذي يستحق المتابعة.
#DePIN #AI #Web3 #FLT
@Fluence : تحويل سعة وحدات معالجة الرسوميات (GPU) إلى سوق
تتسبب أحمال العمل الخاصة بالذكاء الاصطناعي في طلب ضخم على وحدات معالجة الرسوميات (GPUs)، لكن لا يزال الوصول إلى العتاد المناسب مكلفًا وصعبًا.
تتعامل Fluence مع هذا الأمر بطريقة مختلفة.
فشبكتها اللامركزية للحوسبة تربط البنية التحتية المتاحة بالعملاء، بينما تقدم مزاد وحدات معالجة الرسوميات (GPU Auction) نموذجًا لسوق يمكن من خلاله المزايدة على سعة الـGPU بدلًا من شرائها ببساطة عبر تسعير سحابي ثابت.
بدلًا من أن يدفع كل عميل المعدل المحدد نفسه مسبقًا، يمكن أن يساعد المزاد في مواءمة توريد وحدات الـGPU المتاحة مع الطلب الحقيقي.
بالنسبة للمزوّدين، فهذا يخلق طريقة إضافية لتحقيق الدخل من عتادهم.
وبالنسبة للعملاء، فإنه يتيح إمكانية العثور على وصول تنافسي للحوسبة التي يحتاجون إليها.
وهنا يصبح طرح Fluence الأوسع أكثر إثارة للاهتمام.
قد لا يكون مستقبل الحوسبة متعلقًا بشركة واحدة تمتلك كل العتاد.
قد يكون الأمر متعلقًا بإنشاء أسواق مفتوحة حول العتاد الذي يتوفر بالفعل.
وهذا هو جانب البنية التحتية وراء $FLT الذي يستحق المتابعة.
#DePIN #AI #Web3 #FLT
تتسبب أحمال العمل الخاصة بالذكاء الاصطناعي في طلب ضخم على وحدات معالجة الرسوميات (GPUs)، لكن لا يزال الوصول إلى العتاد المناسب مكلفًا وصعبًا.
تتعامل Fluence مع هذا الأمر بطريقة مختلفة.
فشبكتها اللامركزية للحوسبة تربط البنية التحتية المتاحة بالعملاء، بينما تقدم مزاد وحدات معالجة الرسوميات (GPU Auction) نموذجًا لسوق يمكن من خلاله المزايدة على سعة الـGPU بدلًا من شرائها ببساطة عبر تسعير سحابي ثابت.
بدلًا من أن يدفع كل عميل المعدل المحدد نفسه مسبقًا، يمكن أن يساعد المزاد في مواءمة توريد وحدات الـGPU المتاحة مع الطلب الحقيقي.
بالنسبة للمزوّدين، فهذا يخلق طريقة إضافية لتحقيق الدخل من عتادهم.
وبالنسبة للعملاء، فإنه يتيح إمكانية العثور على وصول تنافسي للحوسبة التي يحتاجون إليها.
وهنا يصبح طرح Fluence الأوسع أكثر إثارة للاهتمام.
قد لا يكون مستقبل الحوسبة متعلقًا بشركة واحدة تمتلك كل العتاد.
قد يكون الأمر متعلقًا بإنشاء أسواق مفتوحة حول العتاد الذي يتوفر بالفعل.
وهذا هو جانب البنية التحتية وراء $FLT الذي يستحق المتابعة.
#DePIN #AI #Web3 #FLT
99
·
--
@fluence : حوسبة سحابية على مستوى المؤسسات، دون السعر الباهظ لشركات التقنية الكبرى
إذا كنت تحتاج إلى قوة حوسبة جدية—تلك التي تُدرّب نماذج الذكاء الاصطناعي أو تُشغّل أحمالًا ثقيلة على نطاق واسع—فلم تكن هناك سوى أماكن قليلة للحصول عليها. AWS وGoogle Cloud وAzure. موثوقة بالتأكيد، لكنها مكلفة، وتخضع بالكامل لعدة شركات قليلة.
تقوم Fluence ببناء بديل لا يطلب منك التنازل عن الجودة للوصول إلى ذلك.
نفس البنية التحتية، نموذج ملكية مختلف
تستمد Fluence حوسبتها من مراكز بيانات على مستوى رفيع تخدم بالفعل كبريات شركات Web2. هذه ليست شبكة من أجهزة عشوائية غير موثقة؛ بل هي نفس مستوى البنية التحتية التي يشغّلها السحابة التقليدية، فقط بتنظيم مختلف. بدلًا من أن تمتلك شركة واحدة تلك السعة وتسعّرها، تقوم Fluence بتجميع السعة المتاحة معًا في شبكة لا مركزية تعمل دائمًا ويمكن لأي شخص الاستفادة منها.
النتيجة: يحصل العملاء على خدمة على مستوى المؤسسات بتكلفة أقل. وقد وفّر مستخدمو Fluence بالفعل ملايين الدولارات مقارنةً بما كانوا سيدفعونه لمقدمي السحابة التقليديين—وفورات حقيقية من عملاء حقيقيين يقومون بأحمال عمل حقيقية على الشبكة.
$FLT هو الرمز المميز الذي يجمع النظام كله معًا:
• يقوم مقدمو الخدمة بوضع FLT كضمان لتأمين الشبكة والحصول على أجر مقابل سعة الحوسبة التي يساهمون بها
• تموّل عائدات العملاء برنامج إعادة شراء، بحيث يعود الاستخدام على الشبكة مباشرةً إلى اقتصاديات الرمز المميز الخاص بـ FLT
• يتم حاليًا وضع أكثر من 25 مليون FLT كضمان لتأمين الشبكة على نطاق واسع
• يمكن لحاملي الرموز وضع FLT عبر لوحة الرمز المميز Token Dashboard، والمشاركة في الحوكمة، والحصول على مكافآت مرتبطة بنشاط الشبكة
طلب الذكاء الاصطناعي على الحوسبة لا يتباطأ؛ تدريب النماذج وتشغيلها يتطلب بنية تحتية هائلة، وهذه الحاجة في تزايد مستمر. لقد بَنَت شركات السحابة التقليدية أعمالها على التحكم في الوصول إلى تلك البنية التحتية وتسعيرها وفقًا لذلك.
تقدم Fluence مسارًا مختلفًا: نفس جودة الحوسبة، من نفس مستوى مراكز البيانات، لكن مبني على شبكة تتدفق فيها القيمة إلى الأشخاص الذين يؤمّنون الشبكة ويستخدمونها.
#DePIN #FLT #AI #Web3
@Fluence : حوسبة سحابية على مستوى المؤسسات، دون السعر الباهظ لشركات التقنية الكبرى
إذا كنت تحتاج إلى قوة حوسبة جدية—تلك التي تُدرّب نماذج الذكاء الاصطناعي أو تُشغّل أحمالًا ثقيلة على نطاق واسع—فلم تكن هناك سوى أماكن قليلة للحصول عليها. AWS وGoogle Cloud وAzure. موثوقة بالتأكيد، لكنها مكلفة، وتخضع بالكامل لعدة شركات قليلة.
تقوم Fluence ببناء بديل لا يطلب منك التنازل عن الجودة للوصول إلى ذلك.
نفس البنية التحتية، نموذج ملكية مختلف
تستمد Fluence حوسبتها من مراكز بيانات على مستوى رفيع تخدم بالفعل كبريات شركات Web2. هذه ليست شبكة من أجهزة عشوائية غير موثقة؛ بل هي نفس مستوى البنية التحتية التي يشغّلها السحابة التقليدية، فقط بتنظيم مختلف. بدلًا من أن تمتلك شركة واحدة تلك السعة وتسعّرها، تقوم Fluence بتجميع السعة المتاحة معًا في شبكة لا مركزية تعمل دائمًا ويمكن لأي شخص الاستفادة منها.
النتيجة: يحصل العملاء على خدمة على مستوى المؤسسات بتكلفة أقل. وقد وفّر مستخدمو Fluence بالفعل ملايين الدولارات مقارنةً بما كانوا سيدفعونه لمقدمي السحابة التقليديين—وفورات حقيقية من عملاء حقيقيين يقومون بأحمال عمل حقيقية على الشبكة.
$FLT هو الرمز المميز الذي يجمع النظام كله معًا:
• يقوم مقدمو الخدمة بوضع FLT كضمان لتأمين الشبكة والحصول على أجر مقابل سعة الحوسبة التي يساهمون بها
• تموّل عائدات العملاء برنامج إعادة شراء، بحيث يعود الاستخدام على الشبكة مباشرةً إلى اقتصاديات الرمز المميز الخاص بـ FLT
• يتم حاليًا وضع أكثر من 25 مليون FLT كضمان لتأمين الشبكة على نطاق واسع
• يمكن لحاملي الرموز وضع FLT عبر لوحة الرمز المميز Token Dashboard، والمشاركة في الحوكمة، والحصول على مكافآت مرتبطة بنشاط الشبكة
طلب الذكاء الاصطناعي على الحوسبة لا يتباطأ؛ تدريب النماذج وتشغيلها يتطلب بنية تحتية هائلة، وهذه الحاجة في تزايد مستمر. لقد بَنَت شركات السحابة التقليدية أعمالها على التحكم في الوصول إلى تلك البنية التحتية وتسعيرها وفقًا لذلك.
تقدم Fluence مسارًا مختلفًا: نفس جودة الحوسبة، من نفس مستوى مراكز البيانات، لكن مبني على شبكة تتدفق فيها القيمة إلى الأشخاص الذين يؤمّنون الشبكة ويستخدمونها.
#DePIN #FLT #AI #Web3
إذا كنت تحتاج إلى قوة حوسبة جدية—تلك التي تُدرّب نماذج الذكاء الاصطناعي أو تُشغّل أحمالًا ثقيلة على نطاق واسع—فلم تكن هناك سوى أماكن قليلة للحصول عليها. AWS وGoogle Cloud وAzure. موثوقة بالتأكيد، لكنها مكلفة، وتخضع بالكامل لعدة شركات قليلة.
تقوم Fluence ببناء بديل لا يطلب منك التنازل عن الجودة للوصول إلى ذلك.
نفس البنية التحتية، نموذج ملكية مختلف
تستمد Fluence حوسبتها من مراكز بيانات على مستوى رفيع تخدم بالفعل كبريات شركات Web2. هذه ليست شبكة من أجهزة عشوائية غير موثقة؛ بل هي نفس مستوى البنية التحتية التي يشغّلها السحابة التقليدية، فقط بتنظيم مختلف. بدلًا من أن تمتلك شركة واحدة تلك السعة وتسعّرها، تقوم Fluence بتجميع السعة المتاحة معًا في شبكة لا مركزية تعمل دائمًا ويمكن لأي شخص الاستفادة منها.
النتيجة: يحصل العملاء على خدمة على مستوى المؤسسات بتكلفة أقل. وقد وفّر مستخدمو Fluence بالفعل ملايين الدولارات مقارنةً بما كانوا سيدفعونه لمقدمي السحابة التقليديين—وفورات حقيقية من عملاء حقيقيين يقومون بأحمال عمل حقيقية على الشبكة.
$FLT هو الرمز المميز الذي يجمع النظام كله معًا:
• يقوم مقدمو الخدمة بوضع FLT كضمان لتأمين الشبكة والحصول على أجر مقابل سعة الحوسبة التي يساهمون بها
• تموّل عائدات العملاء برنامج إعادة شراء، بحيث يعود الاستخدام على الشبكة مباشرةً إلى اقتصاديات الرمز المميز الخاص بـ FLT
• يتم حاليًا وضع أكثر من 25 مليون FLT كضمان لتأمين الشبكة على نطاق واسع
• يمكن لحاملي الرموز وضع FLT عبر لوحة الرمز المميز Token Dashboard، والمشاركة في الحوكمة، والحصول على مكافآت مرتبطة بنشاط الشبكة
طلب الذكاء الاصطناعي على الحوسبة لا يتباطأ؛ تدريب النماذج وتشغيلها يتطلب بنية تحتية هائلة، وهذه الحاجة في تزايد مستمر. لقد بَنَت شركات السحابة التقليدية أعمالها على التحكم في الوصول إلى تلك البنية التحتية وتسعيرها وفقًا لذلك.
تقدم Fluence مسارًا مختلفًا: نفس جودة الحوسبة، من نفس مستوى مراكز البيانات، لكن مبني على شبكة تتدفق فيها القيمة إلى الأشخاص الذين يؤمّنون الشبكة ويستخدمونها.
#DePIN #FLT #AI #Web3
81
·
--
الجميع يتسابقون لبناء منتج ذكاء اصطناعي كبير جديد، لكن بالكاد يتحدث أحد عن ما الذي يبطئ هذا السباق فعليًا: الحصول على عدد كافٍ من وحدات GPUs دون انتظار أشهر أو دفع أسعار مرتفعة من مزودي الخدمات السحابية الكبار مقابل ذلك.
@fluence هو أحد المشاريع القليلة التي تحل هذه المشكلة فعلًا بدلًا من مجرد الحديث عنها.
هذه هي الفكرة: بدلًا من توجيه الجميع عبر AWS أو Google Cloud أو Azure، تقوم Fluence بربط المطورين مباشرة بشبكة عالمية من مزودي حوسبة مستقلين. مراكز بيانات حقيقية، عتاد حقيقي، دون أن تتحكم شركة واحدة في التسعير أو خط الأنابيب.
والأمر يعمل بالفعل أيضًا. سوق وحدات GPU لديهم متاح الآن، ويوفر حوسبة بمستوى مؤسسي بتكلفة أقل تصل إلى 85% مقارنةً بالسحابات الكبيرة. وعلى جانب وحدات CPU، حققوا بالفعل أكثر من 1 مليون دولار كإيرادات سنوية—هذه ليست وعودًا ضمن خارطة طريق، بل منتج يدفع الناس فعليًا لاستخدامه.
الجزء الأحدث هو GPU Cluster Auctions، وهو سوق مزادات حقيقي للمزايدة على سعة GPUs المحجوزة. بدلًا من الأمل في أن تكون لدى أحد المزودين توفر بسعر عادل، تقوم الفرق بنشر ما تحتاجه تحديدًا (طراز الـGPU، والكمية، والمنطقة، والإطار الزمني)، ويتنافس المزودون على الصفقة. هذا هو اكتشاف السعر الذي ببساطة لا وجود له في أي مكان آخر داخل هذا المجال الآن.
يتصادمان حاليًا بين DePIN وAI بقوة، ومعظم المشاريع ضمن هذا التقاطع ما تزال نظريّة. Fluence ليست كذلك—إنها بنية تحتية تُستخدم بالفعل لحل مشكلة حقيقية ومكلفة.
إذا كنت تتابع مجال Web3 × AI، فإن $FLT يستحق الفهم ليس من زاوية السردية، بل لما يجري بناؤه فعليًا.
#Fluence #DePIN #AI
الجميع يتسابقون لبناء منتج ذكاء اصطناعي كبير جديد، لكن بالكاد يتحدث أحد عن ما الذي يبطئ هذا السباق فعليًا: الحصول على عدد كافٍ من وحدات GPUs دون انتظار أشهر أو دفع أسعار مرتفعة من مزودي الخدمات السحابية الكبار مقابل ذلك.
@Fluence هو أحد المشاريع القليلة التي تحل هذه المشكلة فعلًا بدلًا من مجرد الحديث عنها.
هذه هي الفكرة: بدلًا من توجيه الجميع عبر AWS أو Google Cloud أو Azure، تقوم Fluence بربط المطورين مباشرة بشبكة عالمية من مزودي حوسبة مستقلين. مراكز بيانات حقيقية، عتاد حقيقي، دون أن تتحكم شركة واحدة في التسعير أو خط الأنابيب.
والأمر يعمل بالفعل أيضًا. سوق وحدات GPU لديهم متاح الآن، ويوفر حوسبة بمستوى مؤسسي بتكلفة أقل تصل إلى 85% مقارنةً بالسحابات الكبيرة. وعلى جانب وحدات CPU، حققوا بالفعل أكثر من 1 مليون دولار كإيرادات سنوية—هذه ليست وعودًا ضمن خارطة طريق، بل منتج يدفع الناس فعليًا لاستخدامه.
الجزء الأحدث هو GPU Cluster Auctions، وهو سوق مزادات حقيقي للمزايدة على سعة GPUs المحجوزة. بدلًا من الأمل في أن تكون لدى أحد المزودين توفر بسعر عادل، تقوم الفرق بنشر ما تحتاجه تحديدًا (طراز الـGPU، والكمية، والمنطقة، والإطار الزمني)، ويتنافس المزودون على الصفقة. هذا هو اكتشاف السعر الذي ببساطة لا وجود له في أي مكان آخر داخل هذا المجال الآن.
يتصادمان حاليًا بين DePIN وAI بقوة، ومعظم المشاريع ضمن هذا التقاطع ما تزال نظريّة. Fluence ليست كذلك—إنها بنية تحتية تُستخدم بالفعل لحل مشكلة حقيقية ومكلفة.
إذا كنت تتابع مجال Web3 × AI، فإن $FLT يستحق الفهم ليس من زاوية السردية، بل لما يجري بناؤه فعليًا.
#Fluence #DePIN #AI
@Fluence هو أحد المشاريع القليلة التي تحل هذه المشكلة فعلًا بدلًا من مجرد الحديث عنها.
هذه هي الفكرة: بدلًا من توجيه الجميع عبر AWS أو Google Cloud أو Azure، تقوم Fluence بربط المطورين مباشرة بشبكة عالمية من مزودي حوسبة مستقلين. مراكز بيانات حقيقية، عتاد حقيقي، دون أن تتحكم شركة واحدة في التسعير أو خط الأنابيب.
والأمر يعمل بالفعل أيضًا. سوق وحدات GPU لديهم متاح الآن، ويوفر حوسبة بمستوى مؤسسي بتكلفة أقل تصل إلى 85% مقارنةً بالسحابات الكبيرة. وعلى جانب وحدات CPU، حققوا بالفعل أكثر من 1 مليون دولار كإيرادات سنوية—هذه ليست وعودًا ضمن خارطة طريق، بل منتج يدفع الناس فعليًا لاستخدامه.
الجزء الأحدث هو GPU Cluster Auctions، وهو سوق مزادات حقيقي للمزايدة على سعة GPUs المحجوزة. بدلًا من الأمل في أن تكون لدى أحد المزودين توفر بسعر عادل، تقوم الفرق بنشر ما تحتاجه تحديدًا (طراز الـGPU، والكمية، والمنطقة، والإطار الزمني)، ويتنافس المزودون على الصفقة. هذا هو اكتشاف السعر الذي ببساطة لا وجود له في أي مكان آخر داخل هذا المجال الآن.
يتصادمان حاليًا بين DePIN وAI بقوة، ومعظم المشاريع ضمن هذا التقاطع ما تزال نظريّة. Fluence ليست كذلك—إنها بنية تحتية تُستخدم بالفعل لحل مشكلة حقيقية ومكلفة.
إذا كنت تتابع مجال Web3 × AI، فإن $FLT يستحق الفهم ليس من زاوية السردية، بل لما يجري بناؤه فعليًا.
#Fluence #DePIN #AI
58
·
--
@fluence Brings تزويد الحوسبة الرسومية اللامركزية لبنّائي الذكاء الاصطناعي
أصبح الوصول إلى وحدات GPU أكبر عائق في مجال الذكاء الاصطناعي حالياً؛ ليس بسبب نقص الأفكار أو المواهب، بل بسبب صعوبة الحصول على قدر كافٍ من الحوسبة دون دفع أسعار باهظة لدى مزوّدي الخدمات السحابية الكبار. تتجه Fluence، وهي منصة DePIN رائدة، لمعالجة هذه المشكلة مباشرةً.
تدير Fluence بالفعل بديلاً لامركزياً لـ "السحابة الخالية" لـ AWS وGoogle Cloud، يتيح للمطوّرين استئجار خوادم من شبكة عالمية من مزوّدي الخدمات المستقلين بدل الاعتماد على شركة واحدة. وقد ولّدت أسواق وحدات المعالجة المركزية تلك إيرادات سنوية تجاوزت 1 مليون دولار، ووفّرت على العملاء ملايين الدولارات مقارنةً بتسعير السحابة التقليدي. والآن يقومون بالأمر نفسه بالنسبة لوحدات GPU.
يمكن للمطوّرين نشر حاويات GPU أو آلات افتراضية VMs أو استخدام الأجهزة المعدنية العارية (bare metal) حسب ما يحتاجون إليه، وكل ذلك يعمل عبر عقود ذكية تتولى التعامل مع التسعير والمدفوعات تلقائياً، مع اشتراط أن يقوم المزوّدون بتقديم ضمان (collateral) والالتزام بمعايير موثوقية قبل الانضمام إلى الشبكة. والنتيجة: وصول إلى GPU بمستوى جاهزية للمؤسسات بتكلفة أقل حتى 85% مقارنةً بالسحابات الكبيرة.
والدعم قائم أيضاً على بنية تحتية حقيقية: مراكز بيانات بمستوى مؤسسي مع امتثال GDPR وISO 27001 وSOC2، ما يوسّع من إمدادات GPU. كما قال أحد المؤسسين المشاركين، يفغيني بونوماريف (Evgeny Ponomarev)، الفكرة بسيطة: إزالة ندرة الموارد وحواجز التكلفة التي تمنع فرق الذكاء الاصطناعي من الحصول على الحوسبة التي تحتاجها.
الخلاصة: تراهن Fluence على نفس منهج اللامركزية الذي نجح مع وحدات CPUs السحابية، والآن قد يصلح أيضاً لعلاج نقص GPUs. يستحق المتابعة.
#DePIN #Ai #GPU
@Fluence Brings تزويد الحوسبة الرسومية اللامركزية لبنّائي الذكاء الاصطناعي
أصبح الوصول إلى وحدات GPU أكبر عائق في مجال الذكاء الاصطناعي حالياً؛ ليس بسبب نقص الأفكار أو المواهب، بل بسبب صعوبة الحصول على قدر كافٍ من الحوسبة دون دفع أسعار باهظة لدى مزوّدي الخدمات السحابية الكبار. تتجه Fluence، وهي منصة DePIN رائدة، لمعالجة هذه المشكلة مباشرةً.
تدير Fluence بالفعل بديلاً لامركزياً لـ "السحابة الخالية" لـ AWS وGoogle Cloud، يتيح للمطوّرين استئجار خوادم من شبكة عالمية من مزوّدي الخدمات المستقلين بدل الاعتماد على شركة واحدة. وقد ولّدت أسواق وحدات المعالجة المركزية تلك إيرادات سنوية تجاوزت 1 مليون دولار، ووفّرت على العملاء ملايين الدولارات مقارنةً بتسعير السحابة التقليدي. والآن يقومون بالأمر نفسه بالنسبة لوحدات GPU.
يمكن للمطوّرين نشر حاويات GPU أو آلات افتراضية VMs أو استخدام الأجهزة المعدنية العارية (bare metal) حسب ما يحتاجون إليه، وكل ذلك يعمل عبر عقود ذكية تتولى التعامل مع التسعير والمدفوعات تلقائياً، مع اشتراط أن يقوم المزوّدون بتقديم ضمان (collateral) والالتزام بمعايير موثوقية قبل الانضمام إلى الشبكة. والنتيجة: وصول إلى GPU بمستوى جاهزية للمؤسسات بتكلفة أقل حتى 85% مقارنةً بالسحابات الكبيرة.
والدعم قائم أيضاً على بنية تحتية حقيقية: مراكز بيانات بمستوى مؤسسي مع امتثال GDPR وISO 27001 وSOC2، ما يوسّع من إمدادات GPU. كما قال أحد المؤسسين المشاركين، يفغيني بونوماريف (Evgeny Ponomarev)، الفكرة بسيطة: إزالة ندرة الموارد وحواجز التكلفة التي تمنع فرق الذكاء الاصطناعي من الحصول على الحوسبة التي تحتاجها.
الخلاصة: تراهن Fluence على نفس منهج اللامركزية الذي نجح مع وحدات CPUs السحابية، والآن قد يصلح أيضاً لعلاج نقص GPUs. يستحق المتابعة.
#DePIN #Ai #GPU
أصبح الوصول إلى وحدات GPU أكبر عائق في مجال الذكاء الاصطناعي حالياً؛ ليس بسبب نقص الأفكار أو المواهب، بل بسبب صعوبة الحصول على قدر كافٍ من الحوسبة دون دفع أسعار باهظة لدى مزوّدي الخدمات السحابية الكبار. تتجه Fluence، وهي منصة DePIN رائدة، لمعالجة هذه المشكلة مباشرةً.
تدير Fluence بالفعل بديلاً لامركزياً لـ "السحابة الخالية" لـ AWS وGoogle Cloud، يتيح للمطوّرين استئجار خوادم من شبكة عالمية من مزوّدي الخدمات المستقلين بدل الاعتماد على شركة واحدة. وقد ولّدت أسواق وحدات المعالجة المركزية تلك إيرادات سنوية تجاوزت 1 مليون دولار، ووفّرت على العملاء ملايين الدولارات مقارنةً بتسعير السحابة التقليدي. والآن يقومون بالأمر نفسه بالنسبة لوحدات GPU.
يمكن للمطوّرين نشر حاويات GPU أو آلات افتراضية VMs أو استخدام الأجهزة المعدنية العارية (bare metal) حسب ما يحتاجون إليه، وكل ذلك يعمل عبر عقود ذكية تتولى التعامل مع التسعير والمدفوعات تلقائياً، مع اشتراط أن يقوم المزوّدون بتقديم ضمان (collateral) والالتزام بمعايير موثوقية قبل الانضمام إلى الشبكة. والنتيجة: وصول إلى GPU بمستوى جاهزية للمؤسسات بتكلفة أقل حتى 85% مقارنةً بالسحابات الكبيرة.
والدعم قائم أيضاً على بنية تحتية حقيقية: مراكز بيانات بمستوى مؤسسي مع امتثال GDPR وISO 27001 وSOC2، ما يوسّع من إمدادات GPU. كما قال أحد المؤسسين المشاركين، يفغيني بونوماريف (Evgeny Ponomarev)، الفكرة بسيطة: إزالة ندرة الموارد وحواجز التكلفة التي تمنع فرق الذكاء الاصطناعي من الحصول على الحوسبة التي تحتاجها.
الخلاصة: تراهن Fluence على نفس منهج اللامركزية الذي نجح مع وحدات CPUs السحابية، والآن قد يصلح أيضاً لعلاج نقص GPUs. يستحق المتابعة.
#DePIN #Ai #GPU
132
·
--
عندما يقوم الناس بتقييم مشاريع الذكاء الاصطناعي، غالبًا ما يبحثون عن الإعلانات وسعر التوكن. أنا أميل أكثر إلى النظر إلى التفاعل على مستوى المؤسسات.
أكبر الفرص في مجال الذكاء الاصطناعي لن تنشأ من التطبيقات وحدها. بل ستأتي من البنية التحتية التي تجعل تلك التطبيقات ممكنة. ومع ازدياد قوة نماذج الذكاء الاصطناعي، تستمر الحاجة إلى الحوسبة الموثوقة والقابلة للتوسع في النمو.
وهذا ما قادني إلى @fluence $FLT.
بدلًا من محاولة أن نصبح الجيل التالي من ترندات السوق، تركز Fluence على بنية الحوسبة اللامركزية، وهي قطاع قد يصبح ذا أهمية متزايدة مع توسّع اعتماد الذكاء الاصطناعي عبر مختلف الصناعات.
كما أعتقد أن مشاريع البنية التحتية تستحق أن تُقيَّم بشكل مختلف. فالتقدم لا يُقاس دائمًا بما يحدث يوميًا في حركة السعر. بل يُقاس بمدى استمرار تحسن التكنولوجيا، وبما إذا كان المطورون يبنون عليها، وبما إذا كانت الشركات ترى قيمة في استخدامها.
لا تزال سباق الذكاء الاصطناعي في مراحله المبكرة، والحاجة إلى الحوسبة لا تتباطأ. لذلك، يظل $FLT واحدًا من المشاريع التي أواصل متابعتها بينما يتطور مشهد البنية التحتية للذكاء الاصطناعي اللامركزية.
#Fluence #AI #DePIN #GPU
عندما يقوم الناس بتقييم مشاريع الذكاء الاصطناعي، غالبًا ما يبحثون عن الإعلانات وسعر التوكن. أنا أميل أكثر إلى النظر إلى التفاعل على مستوى المؤسسات.
أكبر الفرص في مجال الذكاء الاصطناعي لن تنشأ من التطبيقات وحدها. بل ستأتي من البنية التحتية التي تجعل تلك التطبيقات ممكنة. ومع ازدياد قوة نماذج الذكاء الاصطناعي، تستمر الحاجة إلى الحوسبة الموثوقة والقابلة للتوسع في النمو.
وهذا ما قادني إلى @Fluence $FLT.
بدلًا من محاولة أن نصبح الجيل التالي من ترندات السوق، تركز Fluence على بنية الحوسبة اللامركزية، وهي قطاع قد يصبح ذا أهمية متزايدة مع توسّع اعتماد الذكاء الاصطناعي عبر مختلف الصناعات.
كما أعتقد أن مشاريع البنية التحتية تستحق أن تُقيَّم بشكل مختلف. فالتقدم لا يُقاس دائمًا بما يحدث يوميًا في حركة السعر. بل يُقاس بمدى استمرار تحسن التكنولوجيا، وبما إذا كان المطورون يبنون عليها، وبما إذا كانت الشركات ترى قيمة في استخدامها.
لا تزال سباق الذكاء الاصطناعي في مراحله المبكرة، والحاجة إلى الحوسبة لا تتباطأ. لذلك، يظل $FLT واحدًا من المشاريع التي أواصل متابعتها بينما يتطور مشهد البنية التحتية للذكاء الاصطناعي اللامركزية.
#Fluence #AI #DePIN #GPU
أكبر الفرص في مجال الذكاء الاصطناعي لن تنشأ من التطبيقات وحدها. بل ستأتي من البنية التحتية التي تجعل تلك التطبيقات ممكنة. ومع ازدياد قوة نماذج الذكاء الاصطناعي، تستمر الحاجة إلى الحوسبة الموثوقة والقابلة للتوسع في النمو.
وهذا ما قادني إلى @Fluence $FLT.
بدلًا من محاولة أن نصبح الجيل التالي من ترندات السوق، تركز Fluence على بنية الحوسبة اللامركزية، وهي قطاع قد يصبح ذا أهمية متزايدة مع توسّع اعتماد الذكاء الاصطناعي عبر مختلف الصناعات.
كما أعتقد أن مشاريع البنية التحتية تستحق أن تُقيَّم بشكل مختلف. فالتقدم لا يُقاس دائمًا بما يحدث يوميًا في حركة السعر. بل يُقاس بمدى استمرار تحسن التكنولوجيا، وبما إذا كان المطورون يبنون عليها، وبما إذا كانت الشركات ترى قيمة في استخدامها.
لا تزال سباق الذكاء الاصطناعي في مراحله المبكرة، والحاجة إلى الحوسبة لا تتباطأ. لذلك، يظل $FLT واحدًا من المشاريع التي أواصل متابعتها بينما يتطور مشهد البنية التحتية للذكاء الاصطناعي اللامركزية.
#Fluence #AI #DePIN #GPU
80
·
--
لماذا قد يكون AI4 علامة فارقة مهمة لـ @fluence $FLT
بينما يعيد الذكاء الاصطناعي تشكيل الصناعات، أصبح واضحًا بشكل متزايد أن قوة الذكاء الاصطناعي لا تتجاوز قوة البنية التحتية الداعمة له. بينما تركز معظم العناوين على النماذج والتطبيقات الجديدة، فإن الشركات التي تبني طبقة الحوسبة أصبحت بنفس القدر من الأهمية.
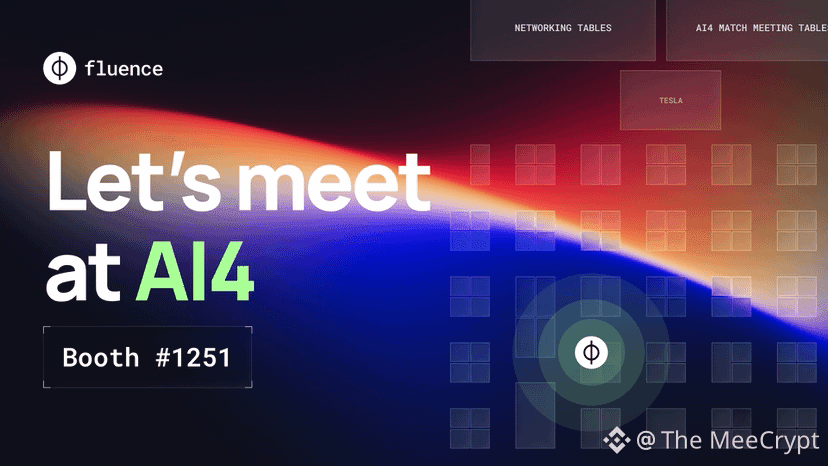
لهذا السبب أولي اهتمامًا لأن شركة Fluence ($FLT) ستحضر مؤتمر AI4، أكبر مؤتمر للذكاء الاصطناعي في أمريكا، المقرر في 4–6 أغسطس في The Venetian بمدينة لاس فيغاس، حيث سيكون الفريق في الجناح رقم 1251.
بالنسبة لشركة مختصة ببنية تحتية للذكاء الاصطناعي، فهذا ليس مجرد ظهور آخر في مؤتمر. يجمع AI4 بين قادة الشركات، والمطورين، والمستثمرين، ومقدمي خدمات السحابة، والمنظمات التي تبحث بنشاط عن حلول ذكاء اصطناعي قابلة للتوسع. إنه بيئة تبدأ فيها العلاقات التجارية، وتُعرض فيها المنتجات، وغالبًا ما تتبلور فيها الشراكات المستقبلية.
على عكس المنتجات الموجهة للمستهلكين، نادرًا ما يتم اعتماد البنية التحتية المؤسسية بمجرد التسويق. يريد صانعو القرار مناقشات تقنية، وعروضًا مباشرة، وحوارات مباشرة مع الفرق خلف التقنية. تخلق مؤتمرات مثل AI4 الإعداد المثالي لتلك التفاعلات.
بالنسبة لـ Fluence، تمثل هذه فرصة لعرض بنيتها التحتية اللامركزية لوحدات معالجة الرسوميات للأشخاص الذين يمكن أن يصبحوا في النهاية عملاء أو شركاء استراتيجيين. ورغم أن حضور حدث ما لا يضمن تلقائيًا الاعتماد، فإن التواجد حيث تجري محادثات ذكاء اصطناعي مؤسسية يعد خطوة مهمة.
سأتابع عن كثب ما الذي سيسفر عنه AI4. سواء كانت شراكات جديدة، أو رؤى صناعية قيمة، أو تعاونات مستقبلية، فهذه الأنواع من التطورات يمكن أن يكون لها أثر مستمر على المشاريع التي تبني البنية التحتية وراء جيل الذكاء الاصطناعي القادم.
📍 مؤتمر AI4
📅 4–6 أغسطس
🏨 The Venetian، لاس فيغاس
📌 جناح Fluence رقم 1251
#Fluence #DePIN #AI #AI4
لماذا قد يكون AI4 علامة فارقة مهمة لـ @Fluence $FLT
بينما يعيد الذكاء الاصطناعي تشكيل الصناعات، أصبح واضحًا بشكل متزايد أن قوة الذكاء الاصطناعي لا تتجاوز قوة البنية التحتية الداعمة له. بينما تركز معظم العناوين على النماذج والتطبيقات الجديدة، فإن الشركات التي تبني طبقة الحوسبة أصبحت بنفس القدر من الأهمية.
لهذا السبب أولي اهتمامًا لأن شركة Fluence ($FLT) ستحضر مؤتمر AI4، أكبر مؤتمر للذكاء الاصطناعي في أمريكا، المقرر في 4–6 أغسطس في The Venetian بمدينة لاس فيغاس، حيث سيكون الفريق في الجناح رقم 1251.
بالنسبة لشركة مختصة ببنية تحتية للذكاء الاصطناعي، فهذا ليس مجرد ظهور آخر في مؤتمر. يجمع AI4 بين قادة الشركات، والمطورين، والمستثمرين، ومقدمي خدمات السحابة، والمنظمات التي تبحث بنشاط عن حلول ذكاء اصطناعي قابلة للتوسع. إنه بيئة تبدأ فيها العلاقات التجارية، وتُعرض فيها المنتجات، وغالبًا ما تتبلور فيها الشراكات المستقبلية.
على عكس المنتجات الموجهة للمستهلكين، نادرًا ما يتم اعتماد البنية التحتية المؤسسية بمجرد التسويق. يريد صانعو القرار مناقشات تقنية، وعروضًا مباشرة، وحوارات مباشرة مع الفرق خلف التقنية. تخلق مؤتمرات مثل AI4 الإعداد المثالي لتلك التفاعلات.
بالنسبة لـ Fluence، تمثل هذه فرصة لعرض بنيتها التحتية اللامركزية لوحدات معالجة الرسوميات للأشخاص الذين يمكن أن يصبحوا في النهاية عملاء أو شركاء استراتيجيين. ورغم أن حضور حدث ما لا يضمن تلقائيًا الاعتماد، فإن التواجد حيث تجري محادثات ذكاء اصطناعي مؤسسية يعد خطوة مهمة.
سأتابع عن كثب ما الذي سيسفر عنه AI4. سواء كانت شراكات جديدة، أو رؤى صناعية قيمة، أو تعاونات مستقبلية، فهذه الأنواع من التطورات يمكن أن يكون لها أثر مستمر على المشاريع التي تبني البنية التحتية وراء جيل الذكاء الاصطناعي القادم.
📍 مؤتمر AI4
📅 4–6 أغسطس
🏨 The Venetian، لاس فيغاس
📌 جناح Fluence رقم 1251
#Fluence #DePIN #AI #AI4
بينما يعيد الذكاء الاصطناعي تشكيل الصناعات، أصبح واضحًا بشكل متزايد أن قوة الذكاء الاصطناعي لا تتجاوز قوة البنية التحتية الداعمة له. بينما تركز معظم العناوين على النماذج والتطبيقات الجديدة، فإن الشركات التي تبني طبقة الحوسبة أصبحت بنفس القدر من الأهمية.
لهذا السبب أولي اهتمامًا لأن شركة Fluence ($FLT) ستحضر مؤتمر AI4، أكبر مؤتمر للذكاء الاصطناعي في أمريكا، المقرر في 4–6 أغسطس في The Venetian بمدينة لاس فيغاس، حيث سيكون الفريق في الجناح رقم 1251.
بالنسبة لشركة مختصة ببنية تحتية للذكاء الاصطناعي، فهذا ليس مجرد ظهور آخر في مؤتمر. يجمع AI4 بين قادة الشركات، والمطورين، والمستثمرين، ومقدمي خدمات السحابة، والمنظمات التي تبحث بنشاط عن حلول ذكاء اصطناعي قابلة للتوسع. إنه بيئة تبدأ فيها العلاقات التجارية، وتُعرض فيها المنتجات، وغالبًا ما تتبلور فيها الشراكات المستقبلية.
على عكس المنتجات الموجهة للمستهلكين، نادرًا ما يتم اعتماد البنية التحتية المؤسسية بمجرد التسويق. يريد صانعو القرار مناقشات تقنية، وعروضًا مباشرة، وحوارات مباشرة مع الفرق خلف التقنية. تخلق مؤتمرات مثل AI4 الإعداد المثالي لتلك التفاعلات.
بالنسبة لـ Fluence، تمثل هذه فرصة لعرض بنيتها التحتية اللامركزية لوحدات معالجة الرسوميات للأشخاص الذين يمكن أن يصبحوا في النهاية عملاء أو شركاء استراتيجيين. ورغم أن حضور حدث ما لا يضمن تلقائيًا الاعتماد، فإن التواجد حيث تجري محادثات ذكاء اصطناعي مؤسسية يعد خطوة مهمة.
سأتابع عن كثب ما الذي سيسفر عنه AI4. سواء كانت شراكات جديدة، أو رؤى صناعية قيمة، أو تعاونات مستقبلية، فهذه الأنواع من التطورات يمكن أن يكون لها أثر مستمر على المشاريع التي تبني البنية التحتية وراء جيل الذكاء الاصطناعي القادم.
📍 مؤتمر AI4
📅 4–6 أغسطس
🏨 The Venetian، لاس فيغاس
📌 جناح Fluence رقم 1251
#Fluence #DePIN #AI #AI4
96
·
--
لماذا تمتلك حوسبة أكثر مما تستخدم؟
أحد أكبر التحديات في مجال الذكاء الاصطناعي ليس دائمًا هو الوصول إلى وحدات معالجة الرسوميات (GPUs)، بل كيفية استخدام هذه الموارد بكفاءة.
العديد من الأحمال لا تحتاج إلى أقصى قدرة حوسبة طوال اليوم، ومع ذلك غالبًا ما يدفع المطورون مقابل أجهزة يكون معظم وقتها خاملًا. وهذا يخلق تكاليف غير ضرورية بينما تظل موارد قيّمة غير مستغلة بالشكل الأمثل.
@fluence يتبع نهجًا مختلفًا.
بدلًا من الاعتماد على أجهزة مخصصة، يدعم $FLT سوقًا حوسبيًا لامركزيًا يمكن من خلاله مشاركة السعة غير المستخدمة من وحدات الـGPU مع المطورين الذين يحتاجون إليها. يمكن للمزودين تحقيق قيمة من الموارد الخاملة، بينما يدفع المطورون فقط مقابل الحوسبة التي يستهلكونها.
يمتلك هذا النموذج القدرة على تحسين استغلال الموارد وتقليل تكاليف البنية التحتية وجعل حوسبة الذكاء الاصطناعي أكثر إتاحة دون الحاجة إلى أن تمتلك كل فرقة أجهزة عالية الأداء.
ومع استمرار نمو الطلب على الذكاء الاصطناعي، قد يصبح تحسين كيفية تخصيص موارد الحوسبة بنفس أهمية زيادة كمية الموارد المتاحة.
هل استكشفت شبكات الـGPU اللامركزية، أم ما زلت تعتمد على مقدمي الخدمات السحابية التقليديين؟
#Fluence #AI #DePIN #GPU #CloudComputing
لماذا تمتلك حوسبة أكثر مما تستخدم؟
أحد أكبر التحديات في مجال الذكاء الاصطناعي ليس دائمًا هو الوصول إلى وحدات معالجة الرسوميات (GPUs)، بل كيفية استخدام هذه الموارد بكفاءة.
العديد من الأحمال لا تحتاج إلى أقصى قدرة حوسبة طوال اليوم، ومع ذلك غالبًا ما يدفع المطورون مقابل أجهزة يكون معظم وقتها خاملًا. وهذا يخلق تكاليف غير ضرورية بينما تظل موارد قيّمة غير مستغلة بالشكل الأمثل.
@Fluence يتبع نهجًا مختلفًا.
بدلًا من الاعتماد على أجهزة مخصصة، يدعم $FLT سوقًا حوسبيًا لامركزيًا يمكن من خلاله مشاركة السعة غير المستخدمة من وحدات الـGPU مع المطورين الذين يحتاجون إليها. يمكن للمزودين تحقيق قيمة من الموارد الخاملة، بينما يدفع المطورون فقط مقابل الحوسبة التي يستهلكونها.
يمتلك هذا النموذج القدرة على تحسين استغلال الموارد وتقليل تكاليف البنية التحتية وجعل حوسبة الذكاء الاصطناعي أكثر إتاحة دون الحاجة إلى أن تمتلك كل فرقة أجهزة عالية الأداء.
ومع استمرار نمو الطلب على الذكاء الاصطناعي، قد يصبح تحسين كيفية تخصيص موارد الحوسبة بنفس أهمية زيادة كمية الموارد المتاحة.
هل استكشفت شبكات الـGPU اللامركزية، أم ما زلت تعتمد على مقدمي الخدمات السحابية التقليديين؟
#Fluence #AI #DePIN #GPU #CloudComputing
أحد أكبر التحديات في مجال الذكاء الاصطناعي ليس دائمًا هو الوصول إلى وحدات معالجة الرسوميات (GPUs)، بل كيفية استخدام هذه الموارد بكفاءة.
العديد من الأحمال لا تحتاج إلى أقصى قدرة حوسبة طوال اليوم، ومع ذلك غالبًا ما يدفع المطورون مقابل أجهزة يكون معظم وقتها خاملًا. وهذا يخلق تكاليف غير ضرورية بينما تظل موارد قيّمة غير مستغلة بالشكل الأمثل.
@Fluence يتبع نهجًا مختلفًا.
بدلًا من الاعتماد على أجهزة مخصصة، يدعم $FLT سوقًا حوسبيًا لامركزيًا يمكن من خلاله مشاركة السعة غير المستخدمة من وحدات الـGPU مع المطورين الذين يحتاجون إليها. يمكن للمزودين تحقيق قيمة من الموارد الخاملة، بينما يدفع المطورون فقط مقابل الحوسبة التي يستهلكونها.
يمتلك هذا النموذج القدرة على تحسين استغلال الموارد وتقليل تكاليف البنية التحتية وجعل حوسبة الذكاء الاصطناعي أكثر إتاحة دون الحاجة إلى أن تمتلك كل فرقة أجهزة عالية الأداء.
ومع استمرار نمو الطلب على الذكاء الاصطناعي، قد يصبح تحسين كيفية تخصيص موارد الحوسبة بنفس أهمية زيادة كمية الموارد المتاحة.
هل استكشفت شبكات الـGPU اللامركزية، أم ما زلت تعتمد على مقدمي الخدمات السحابية التقليديين؟
#Fluence #AI #DePIN #GPU #CloudComputing
1
87
·
--
تجربة المطوّر أصبحت تُماثل أهمية أداء الحوسبة.
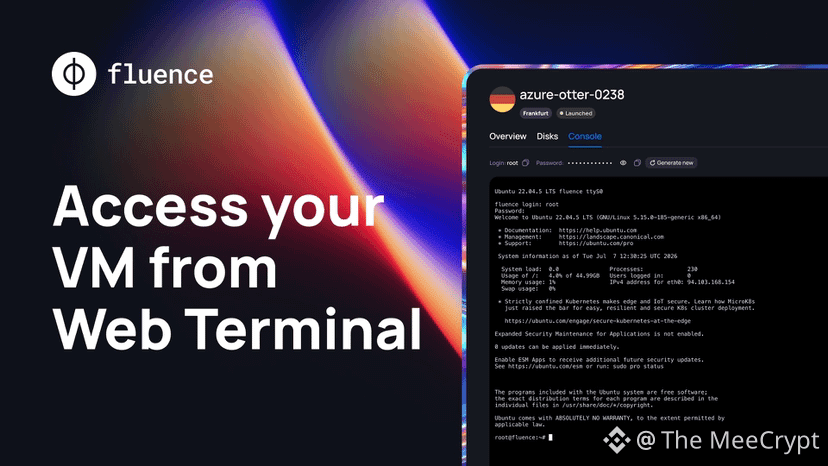
@fluence قد أدخلت محطة الويب (Web Terminal) في وحدة تحكم Fluence (Fluence Console)، ما يتيح للمطوّرين الوصول بشكل آمن إلى غلاف جذر كامل (full root shell) لأي جهاز افتراضي قيد التشغيل مباشرةً من المتصفح. دون الحاجة إلى عميل SSH، أو إعداد مفاتيح، أو أي تهيئة محلية.
سواءً لمراقبة أحمال عمل الذكاء الاصطناعي، أو التحقق من السجلات، أو إعادة تشغيل التطبيقات، يمكن للمطوّرين إدارة أجهزتهم الافتراضية (VMs) من تقريبًا أي جهاز، بما في ذلك الهاتف المحمول.
تعمل التحديثات من هذا النوع على تقليل التعقيد التشغيلي وجعل الحوسبة اللامركزية أكثر إتاحة للمطوّرين الذين يبنون تطبيقات الذكاء الاصطناعي وتطبيقات سحابية أصلية.
وبينما تستمرّ منظومة DePIN في التطور، فإن الأدوات العملية التي تُبسّط النشر والإدارة يمكن أن تلعب دورًا مهمًا في دفع معدلات التبنّي. تواصل Fluence التركيز على تقديم هذه التجربة، مع توسيع فائدة منظومة $FLT.
ما ميزة المطوّر التي ترغب في رؤيتها تاليًا على Fluence؟
#Fluence #DePIN #CloudComputing #AI #Web3
تجربة المطوّر أصبحت تُماثل أهمية أداء الحوسبة.
@Fluence قد أدخلت محطة الويب (Web Terminal) في وحدة تحكم Fluence (Fluence Console)، ما يتيح للمطوّرين الوصول بشكل آمن إلى غلاف جذر كامل (full root shell) لأي جهاز افتراضي قيد التشغيل مباشرةً من المتصفح. دون الحاجة إلى عميل SSH، أو إعداد مفاتيح، أو أي تهيئة محلية.
سواءً لمراقبة أحمال عمل الذكاء الاصطناعي، أو التحقق من السجلات، أو إعادة تشغيل التطبيقات، يمكن للمطوّرين إدارة أجهزتهم الافتراضية (VMs) من تقريبًا أي جهاز، بما في ذلك الهاتف المحمول.
تعمل التحديثات من هذا النوع على تقليل التعقيد التشغيلي وجعل الحوسبة اللامركزية أكثر إتاحة للمطوّرين الذين يبنون تطبيقات الذكاء الاصطناعي وتطبيقات سحابية أصلية.
وبينما تستمرّ منظومة DePIN في التطور، فإن الأدوات العملية التي تُبسّط النشر والإدارة يمكن أن تلعب دورًا مهمًا في دفع معدلات التبنّي. تواصل Fluence التركيز على تقديم هذه التجربة، مع توسيع فائدة منظومة $FLT.
ما ميزة المطوّر التي ترغب في رؤيتها تاليًا على Fluence؟
#Fluence #DePIN #CloudComputing #AI #Web3
@Fluence قد أدخلت محطة الويب (Web Terminal) في وحدة تحكم Fluence (Fluence Console)، ما يتيح للمطوّرين الوصول بشكل آمن إلى غلاف جذر كامل (full root shell) لأي جهاز افتراضي قيد التشغيل مباشرةً من المتصفح. دون الحاجة إلى عميل SSH، أو إعداد مفاتيح، أو أي تهيئة محلية.
سواءً لمراقبة أحمال عمل الذكاء الاصطناعي، أو التحقق من السجلات، أو إعادة تشغيل التطبيقات، يمكن للمطوّرين إدارة أجهزتهم الافتراضية (VMs) من تقريبًا أي جهاز، بما في ذلك الهاتف المحمول.
تعمل التحديثات من هذا النوع على تقليل التعقيد التشغيلي وجعل الحوسبة اللامركزية أكثر إتاحة للمطوّرين الذين يبنون تطبيقات الذكاء الاصطناعي وتطبيقات سحابية أصلية.
وبينما تستمرّ منظومة DePIN في التطور، فإن الأدوات العملية التي تُبسّط النشر والإدارة يمكن أن تلعب دورًا مهمًا في دفع معدلات التبنّي. تواصل Fluence التركيز على تقديم هذه التجربة، مع توسيع فائدة منظومة $FLT.
ما ميزة المطوّر التي ترغب في رؤيتها تاليًا على Fluence؟
#Fluence #DePIN #CloudComputing #AI #Web3
1
92
·
--
@fluence continues expanding its decentralized compute platform with persistent storage, VM IP management, and credit card support for on-demand compute.
The upcoming GPU Cluster Auctions is a step forward, allowing GPU clusters to be allocated through competitive bidding instead of traditional centralized provisioning.
A few numbers stood out to me:
• 357.2M FLT in treasury reserves.
• $1.46M in stablecoin reserves.
• 11.5% average staking APR.
• 7M FLT added through open-market liquidity operations.
Infrastructure projects are often judged by execution rather than hype.
From what I've been following, $FLT continues to focus on expanding its compute network while improving capital efficiency and developer access two things that could matter significantly as AI demand continues to scale.
#DePIN #Fluence #Ai
@Fluence continues expanding its decentralized compute platform with persistent storage, VM IP management, and credit card support for on-demand compute.
The upcoming GPU Cluster Auctions is a step forward, allowing GPU clusters to be allocated through competitive bidding instead of traditional centralized provisioning.
A few numbers stood out to me:
• 357.2M FLT in treasury reserves.
• $1.46M in stablecoin reserves.
• 11.5% average staking APR.
• 7M FLT added through open-market liquidity operations.
Infrastructure projects are often judged by execution rather than hype.
From what I've been following, $FLT continues to focus on expanding its compute network while improving capital efficiency and developer access two things that could matter significantly as AI demand continues to scale.
#DePIN #Fluence #Ai
The upcoming GPU Cluster Auctions is a step forward, allowing GPU clusters to be allocated through competitive bidding instead of traditional centralized provisioning.
A few numbers stood out to me:
• 357.2M FLT in treasury reserves.
• $1.46M in stablecoin reserves.
• 11.5% average staking APR.
• 7M FLT added through open-market liquidity operations.
Infrastructure projects are often judged by execution rather than hype.
From what I've been following, $FLT continues to focus on expanding its compute network while improving capital efficiency and developer access two things that could matter significantly as AI demand continues to scale.
#DePIN #Fluence #Ai
85
·
--
توضيح القيمة المقترحة وراء @fluence ($FLT) يصبح أوضح عندما تنظر إلى سؤال واحد بسيط:
يسأل كل منشئ للذكاء الاصطناعي في النهاية السؤال نفسه:
"أي وحدة معالجة رسومية (GPU) يجب أن أشتري؟"
لكن السؤال الأفضل قد يكون:
"هل أحتاج فعلًا إلى امتلاك واحدة؟"
ليست كل أحمال عمل الذكاء الاصطناعي تتطلب عتادًا مخصصًا يجلس خاملاً معظم اليوم. بعضها يحتاج إلى السرعة، وبعضها يحتاج إلى الذاكرة، وكثير منها يحتاج إلى قدر إضافي من الحوسبة من وقت لآخر.
بدلًا من التركيز على امتلاك وحدة الـGPU، تعمل @fluence ($FLT) على بناء بنية تحتية حوسبية لا مركزية تُمكّن المطورين من الوصول إلى موارد الحوسبة عندما يحتاجون إليها.
ومع استمرار نمو الذكاء الاصطناعي، لن تصبح الحوسبة مجرد مسألة شراء أكبر وحدة GPU. بل ستكون مسألة استخدام الموارد المناسبة في الوقت المناسب.
من المرجح أن تجمع البنية التحتية للذكاء الاصطناعي مستقبلًا بين العتاد المحلي وخدمات السحابة والحوسبة اللامركزية، وهذا هو سبب كون $FLT مشروعًا يستحق المتابعة.
#DePIN #GPU #AI
توضيح القيمة المقترحة وراء @Fluence ($FLT) يصبح أوضح عندما تنظر إلى سؤال واحد بسيط:
يسأل كل منشئ للذكاء الاصطناعي في النهاية السؤال نفسه:
"أي وحدة معالجة رسومية (GPU) يجب أن أشتري؟"
لكن السؤال الأفضل قد يكون:
"هل أحتاج فعلًا إلى امتلاك واحدة؟"
ليست كل أحمال عمل الذكاء الاصطناعي تتطلب عتادًا مخصصًا يجلس خاملاً معظم اليوم. بعضها يحتاج إلى السرعة، وبعضها يحتاج إلى الذاكرة، وكثير منها يحتاج إلى قدر إضافي من الحوسبة من وقت لآخر.
بدلًا من التركيز على امتلاك وحدة الـGPU، تعمل @Fluence ($FLT) على بناء بنية تحتية حوسبية لا مركزية تُمكّن المطورين من الوصول إلى موارد الحوسبة عندما يحتاجون إليها.
ومع استمرار نمو الذكاء الاصطناعي، لن تصبح الحوسبة مجرد مسألة شراء أكبر وحدة GPU. بل ستكون مسألة استخدام الموارد المناسبة في الوقت المناسب.
من المرجح أن تجمع البنية التحتية للذكاء الاصطناعي مستقبلًا بين العتاد المحلي وخدمات السحابة والحوسبة اللامركزية، وهذا هو سبب كون $FLT مشروعًا يستحق المتابعة.
#DePIN #GPU #AI
يسأل كل منشئ للذكاء الاصطناعي في النهاية السؤال نفسه:
"أي وحدة معالجة رسومية (GPU) يجب أن أشتري؟"
لكن السؤال الأفضل قد يكون:
"هل أحتاج فعلًا إلى امتلاك واحدة؟"
ليست كل أحمال عمل الذكاء الاصطناعي تتطلب عتادًا مخصصًا يجلس خاملاً معظم اليوم. بعضها يحتاج إلى السرعة، وبعضها يحتاج إلى الذاكرة، وكثير منها يحتاج إلى قدر إضافي من الحوسبة من وقت لآخر.
بدلًا من التركيز على امتلاك وحدة الـGPU، تعمل @Fluence ($FLT) على بناء بنية تحتية حوسبية لا مركزية تُمكّن المطورين من الوصول إلى موارد الحوسبة عندما يحتاجون إليها.
ومع استمرار نمو الذكاء الاصطناعي، لن تصبح الحوسبة مجرد مسألة شراء أكبر وحدة GPU. بل ستكون مسألة استخدام الموارد المناسبة في الوقت المناسب.
من المرجح أن تجمع البنية التحتية للذكاء الاصطناعي مستقبلًا بين العتاد المحلي وخدمات السحابة والحوسبة اللامركزية، وهذا هو سبب كون $FLT مشروعًا يستحق المتابعة.
#DePIN #GPU #AI
1
92
سجّل الدخول لاستكشاف المزيد من المُحتوى
انضم إلى مُستخدمي العملات الرقمية حول العالم على Binance Square
⚡️ احصل على أحدث المعلومات المفيدة عن العملات الرقمية.
💬 موثوقة من قبل أكبر منصّة لتداول العملات الرقمية في العالم.
👍 اكتشف الرؤى الحقيقية من صنّاع المُحتوى الموثوقين.
البريد الإلكتروني / رقم الهاتف
المواضيع الرائجة
BitcoinSurpasses$77000
12,643 مشاهدات
190 يقومون بالنقاش
$BTC يتجه للأعلى بعنف رغم كل شيء. 🚀
اليوم شهدنا أول رفع لأسعار الفائدة منذ أكثر من 3 سنوات، بينما تعثّر قانون CLARITY مجددًا أمس.
التهيئة: دخول طويل كبير مرة أخرى — شكرًا لي لاحقًا
الدخول : $75500 - $76500
إيقاف الخسارة : $74900
جني الربح : $77000 - $78000
استعدوا لدورة نمو مجنونة. 🔥
TF_bnb
·16 إعجاب
·6.8k مشاهدات
ParadigmDisclosesZECHolding
48,874 مشاهدات
875 يقومون بالنقاش
BitcoinETFsShed$450M
22,298 مشاهدات
197 يقومون بالنقاش