
Agen AI sedang memasuki fase yang berbeda.
Mereka tidak lagi terbatas pada menghasilkan teks atau menjawab pertanyaan. Mereka dapat melakukan riset, mengelola file, berinteraksi dengan situs web, berkomunikasi lintas platform, dan menjalankan alur kerja multi-tahap. Namun ketika para agen semakin mampu bertindak atas nama kita, saya pikir satu pertanyaan menjadi semakin penting:
Bagaimana kita memberi AI otonomi yang cukup agar berguna tanpa memberinya wewenang tanpa batas?
Itulah yang membuat IronClaw 1.0 dari #NEARAI khususnya menarik bagi saya.
Memisahkan Berpikir Dari Bertindak
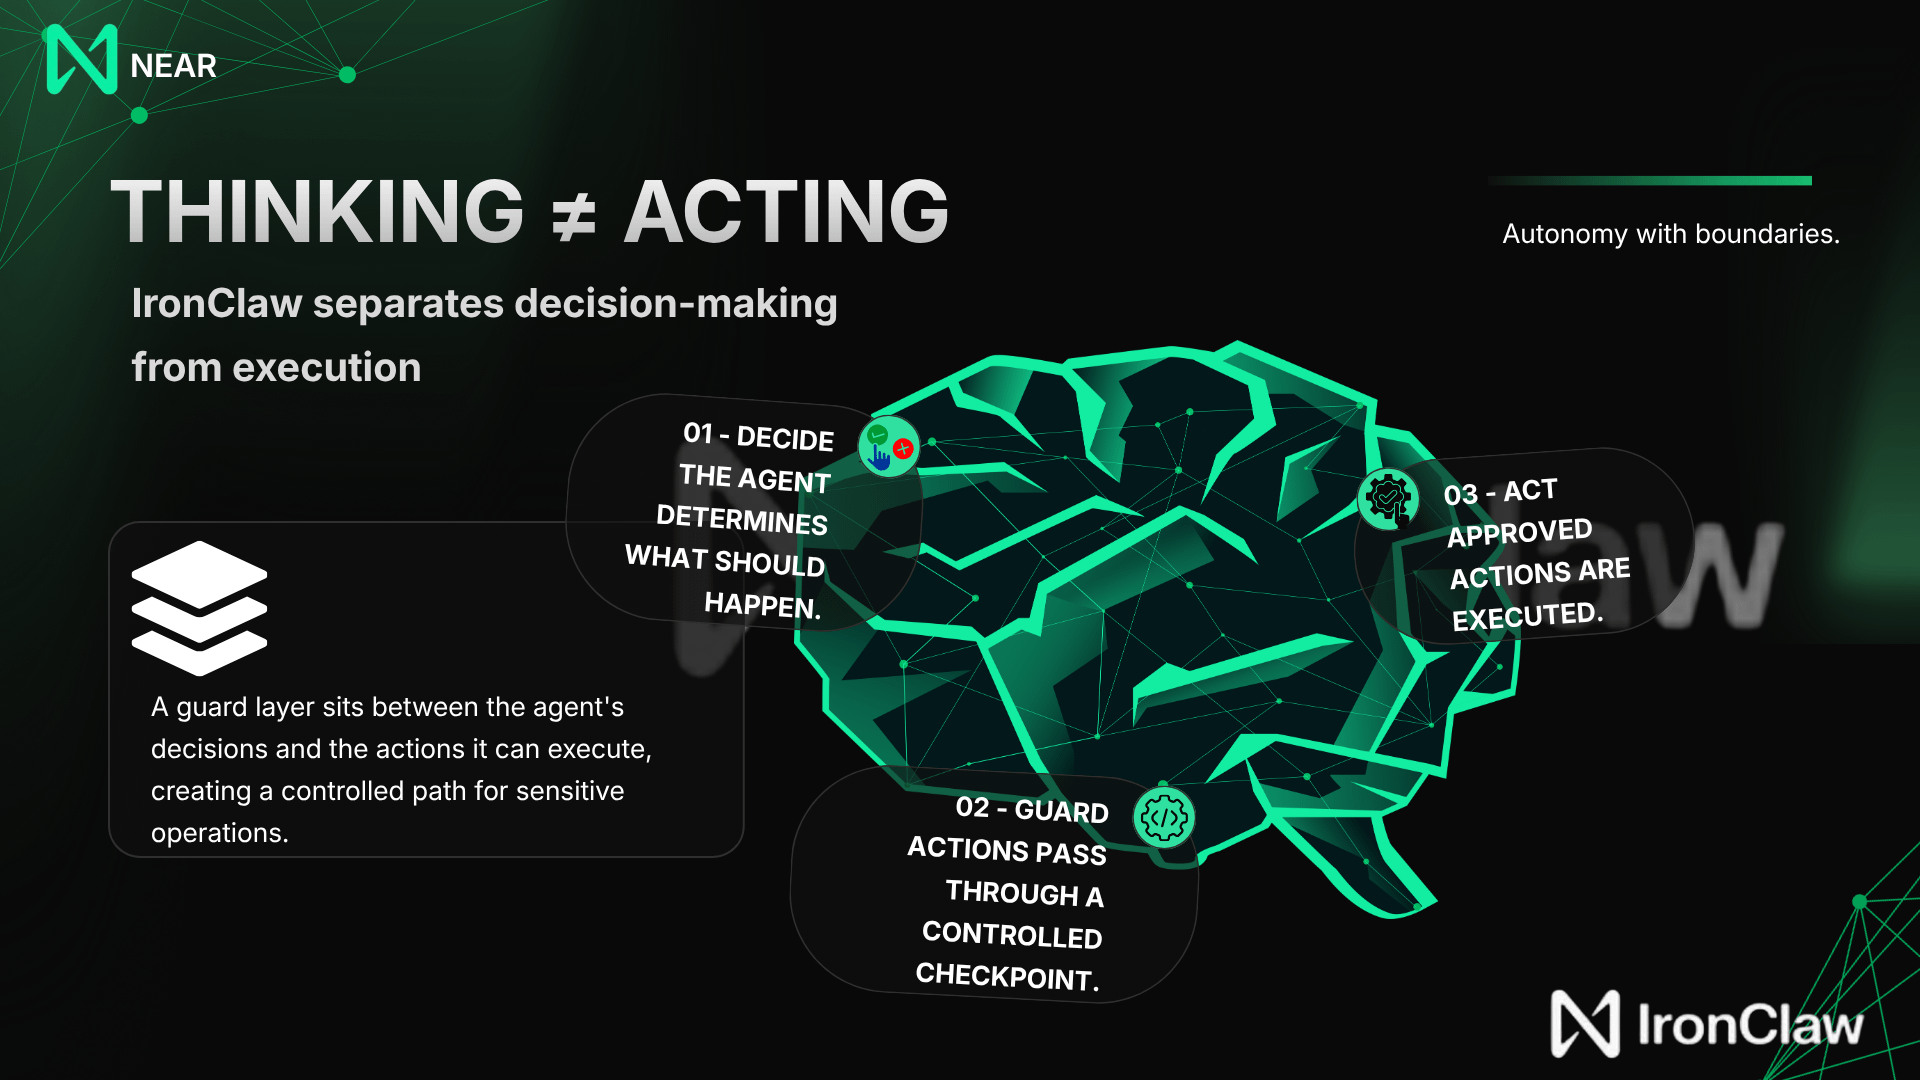
IronClaw mendekati keamanan agen pada tingkat arsitektur.
Alih-alih membiarkan model yang membuat keputusan mengeksekusi langsung aksi yang dihasilkan, #ironclaw menempatkan lapisan pengaman di antara pengambilan keputusan dan eksekusi. Aksi melewati jalur terkontrol ini, dan operasi yang sensitif dapat memerlukan persetujuan eksplisit sebelum dijalankan.
Itu menciptakan pemisahan yang berguna:
Agen dapat memutuskan apa yang ingin dilakukannya, tetapi agen itu tidak otomatis memiliki izin tanpa batas untuk melakukannya.
Bagi saya, itu lebih menarik daripada sekadar menambahkan fitur keamanan lain ke agen AI. Mekanisme kontrol menjadi bagian dari cara agen beroperasi.
#ironclaw juga mengatasi masalah praktis lain: apa yang terjadi ketika alur kerja otonom terputus?
Checkpointing berkelanjutannya memungkinkan pekerjaan dilanjutkan alih-alih memaksa agen mulai lagi. Status dan memori persisten juga dapat terbawa lintas CLI, Web, Slack, dan Telegram, sehingga asisten yang sama dapat mempertahankan konteks di berbagai antarmuka.
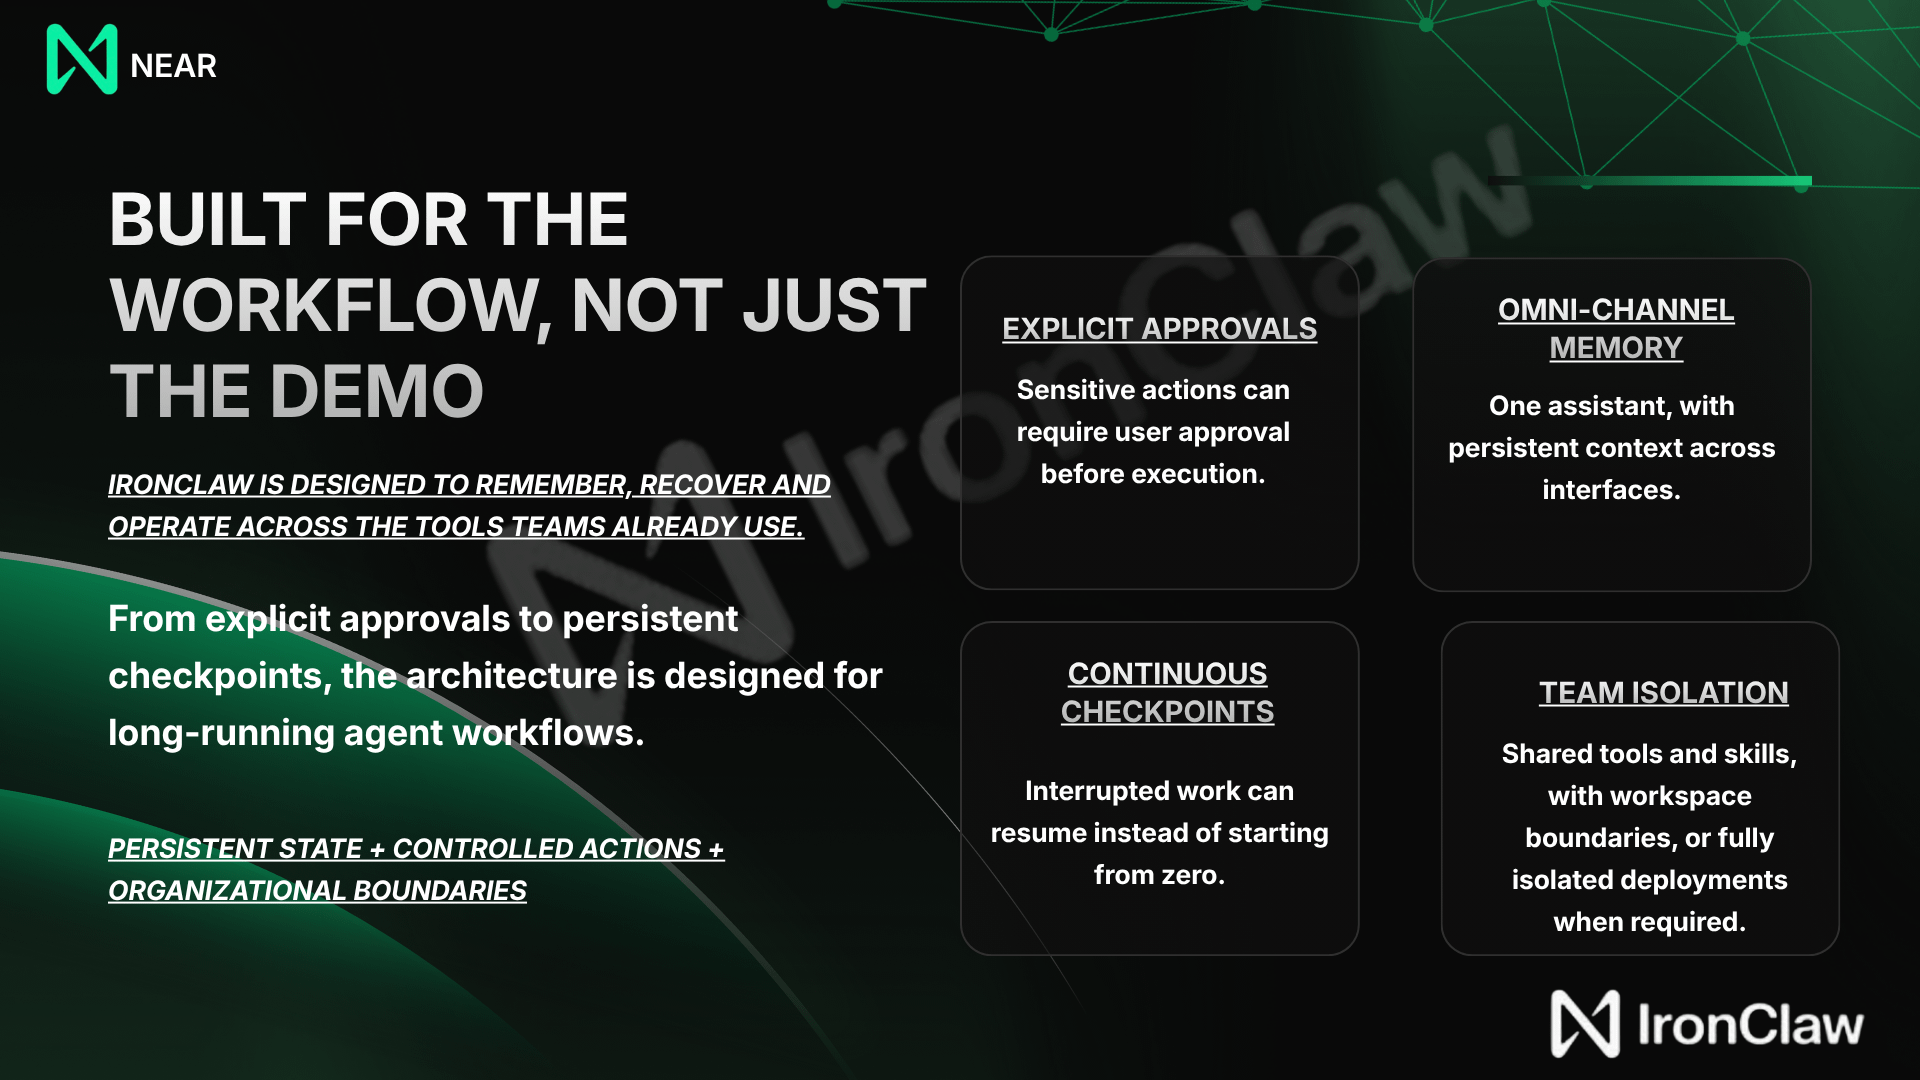
Untuk organisasi, #ironclaw mendukung alat dan keahlian bersama melalui penerapan multi-tenant sambil tetap menjaga batas ruang kerja, dengan penerapan single-tenant tersedia jika diperlukan isolasi penuh.
Performa di Balik Arsitektur
Model keamanan akan menjadi kurang meyakinkan jika harus mengorbankan kapabilitas.
Dalam evaluasi Ironclaw 1.0 oleh NEAR AI pada 27 Juli, sistem menempati posisi teratas yang dilaporkan di tiga benchmark agen berbeda dengan menggunakan model dasar DeepSeek-V4-Flash yang sama untuk perbandingan pada harness.
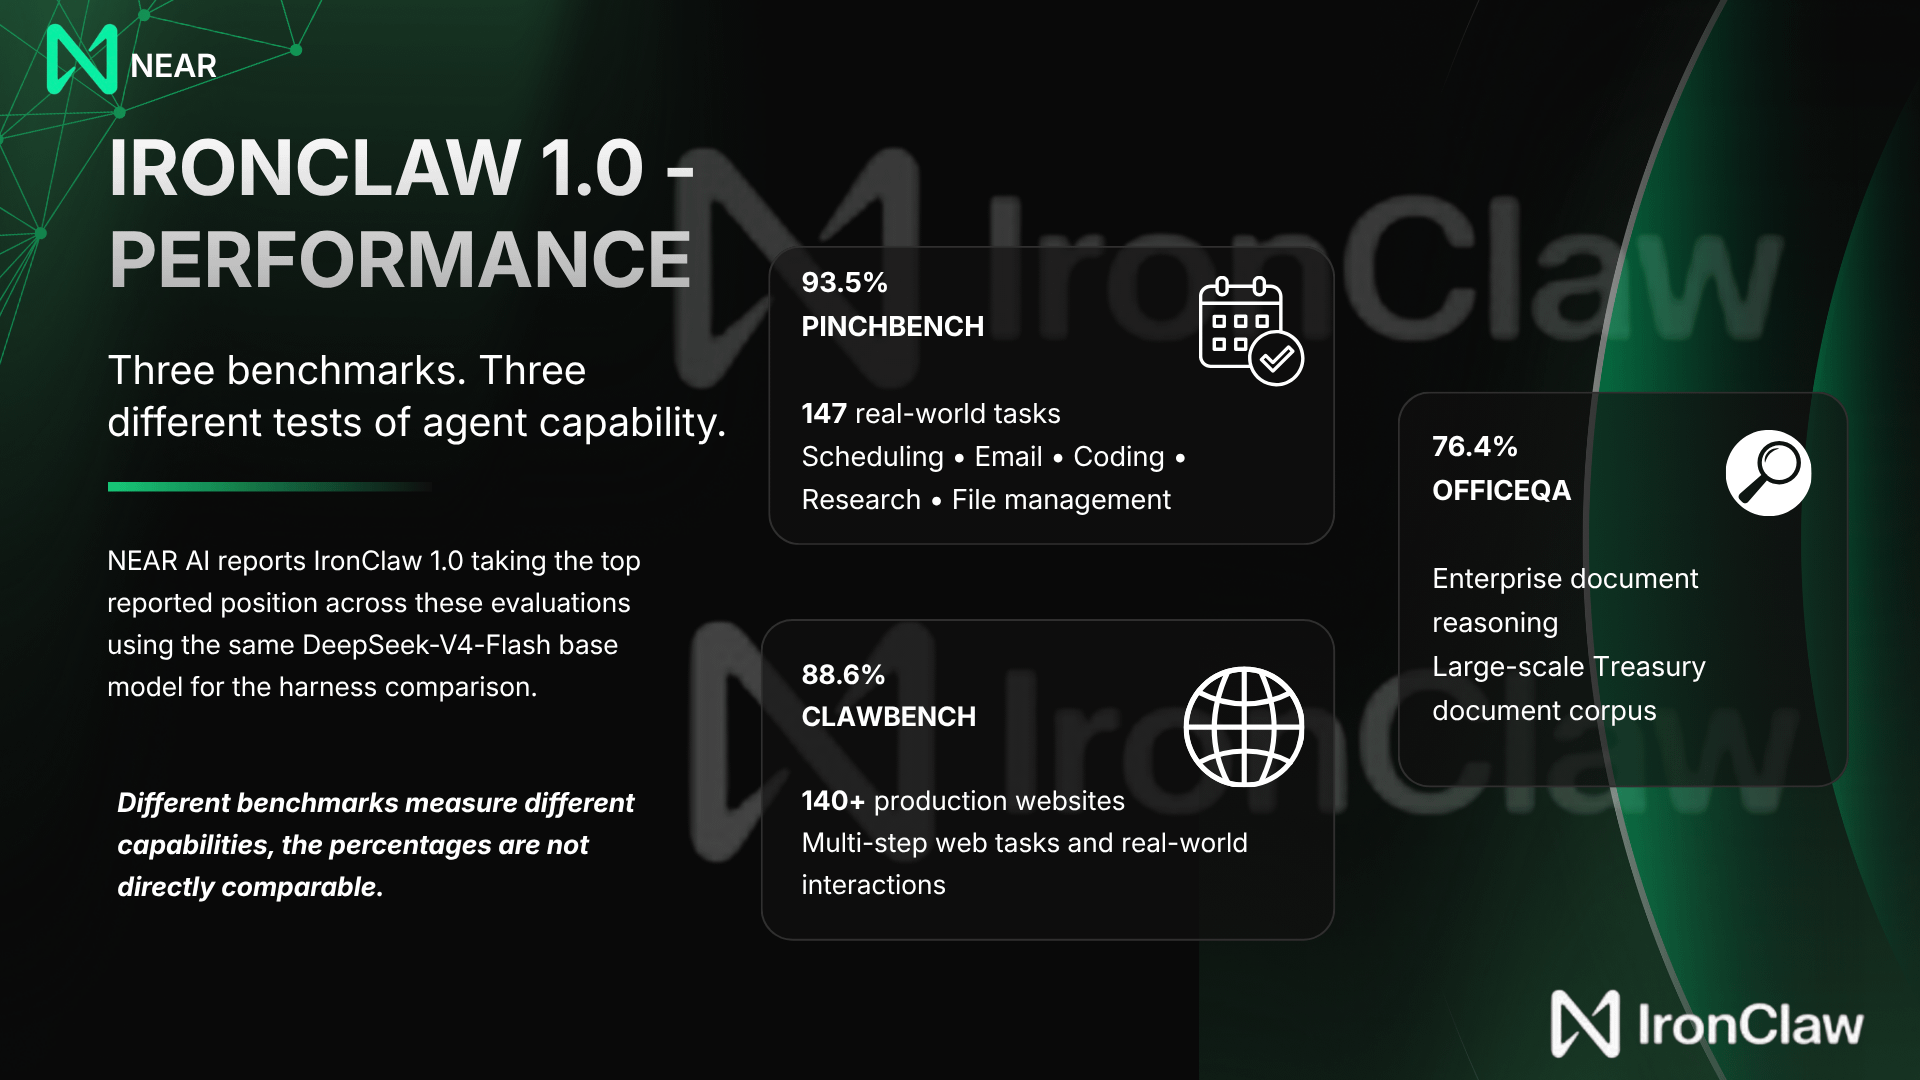
IronClaw mencatat 93,5% pada PinchBench, yang mengevaluasi 147 tugas dunia nyata termasuk penjadwalan, triase email, pemrograman, riset, dan manajemen file.
Di ClawBench, yang menguji tugas multi-langkah di lebih dari 140 situs produksi dunia nyata, IronClaw mencatat 88,6%.
Dan di OfficeQA, yang menilai penalaran berbasis konteks atas kumpulan besar dokumen Treasury AS, ia mencapai 76,4%.
Angka-angka ini seharusnya tidak dianggap dapat dibandingkan secara langsung karena setiap benchmark mengukur kapabilitas yang berbeda. Yang menonjol bagi saya adalah arsitektur yang sama tampil kuat dalam eksekusi tugas praktis, interaksi web, dan penalaran dokumen.
Gambaran Besar NEAR AI
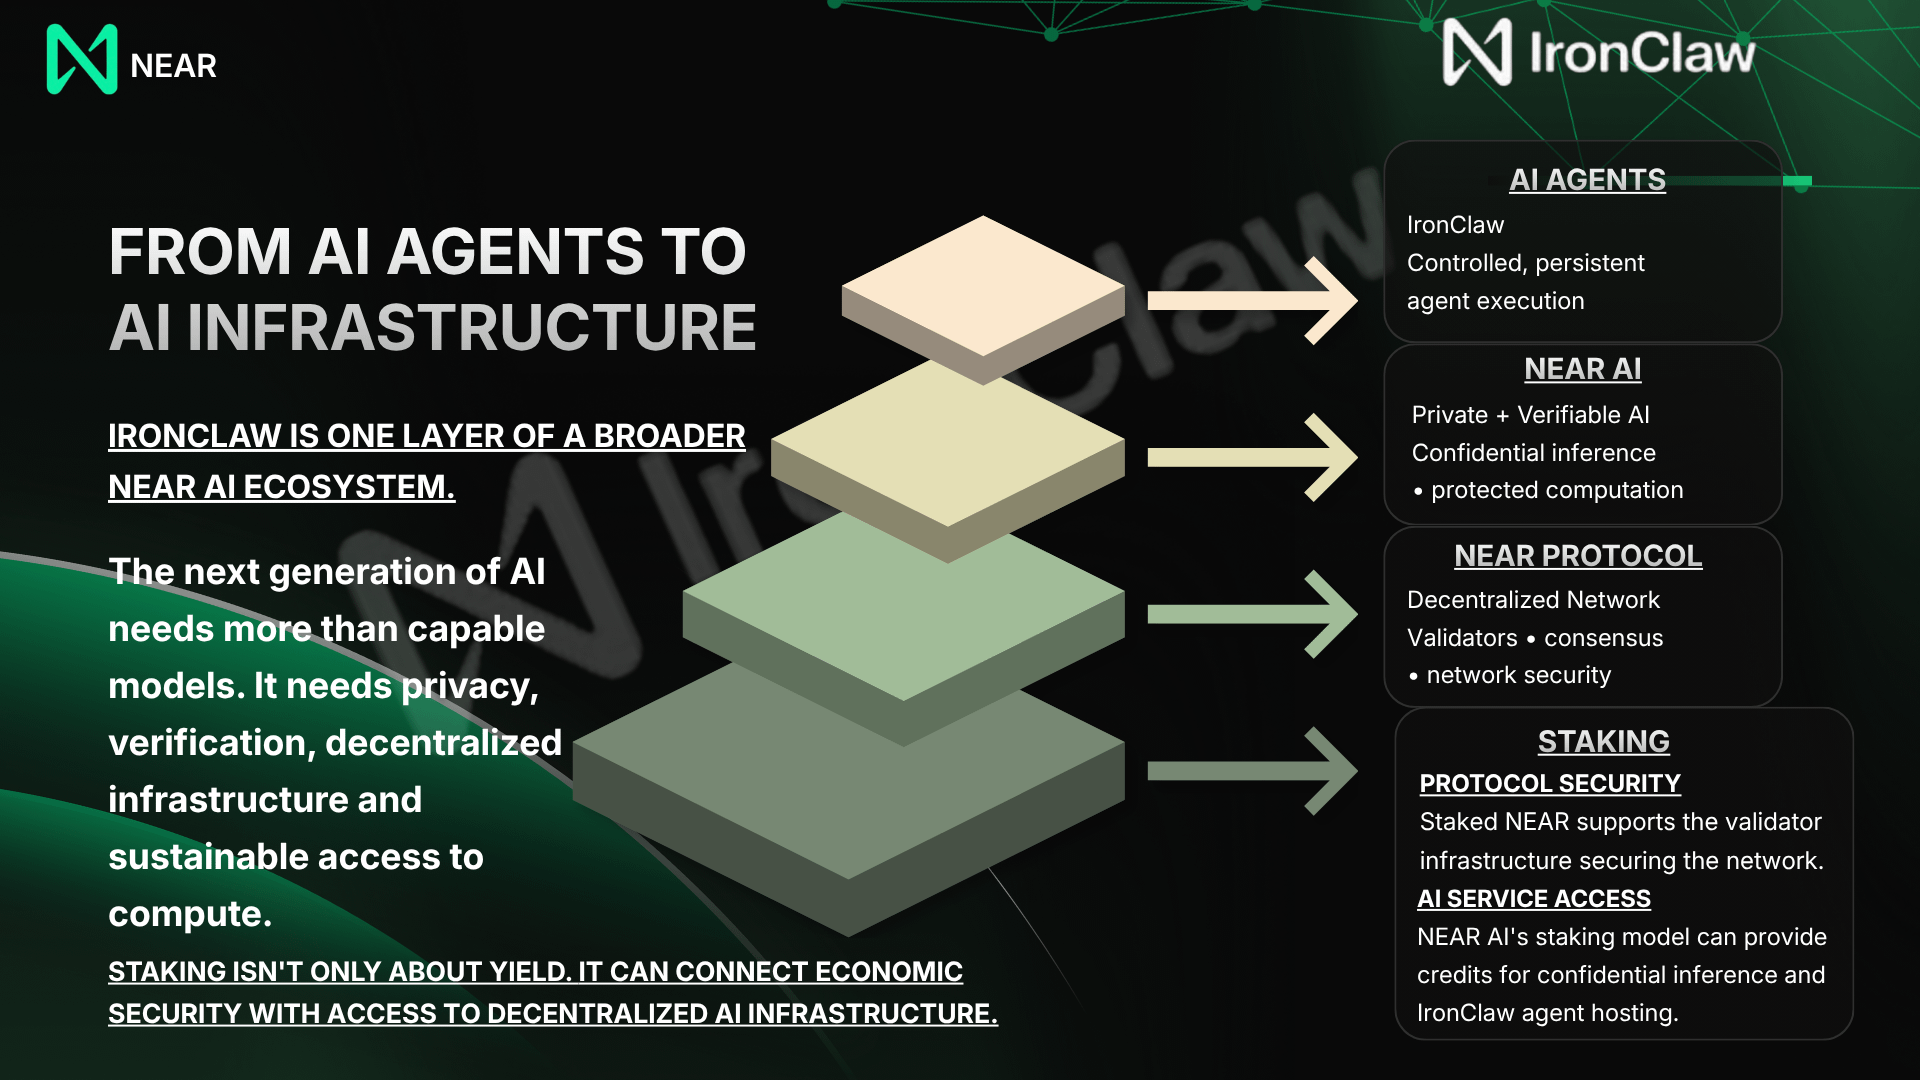
IronClaw berada dalam visi besar #NEARAI , yang berfokus pada infrastruktur AI yang privat, rahasia (confidential), dan dapat diverifikasi.
Itu membawa peran @NEAR Protocol dan staking ke dalam percakapan.
Staking sering dipandang terutama dari lensa imbalan. Namun, pada tingkat protokol, NEAR yang dipertaruhkan mendukung infrastruktur validator yang bertanggung jawab untuk menjaga konsensus jaringan dan keamanan.
Sekarang ada koneksi yang bahkan lebih langsung ke infrastruktur AI. #NEARAI telah memperkenalkan akses berbasis staking yang memungkinkan pengguna mempertaruhkan NEAR untuk mendapatkan kredit guna mendukung inferensi yang rahasia (confidential) dan hosting agen IronClaw yang selalu aktif.
Hal itu mengubah cara saya memandang hubungan antara staking dan AI terdesentralisasi.
Masa depan bukan sekadar membangun agen yang bisa berpikir lebih baik. Ini tentang menciptakan infrastruktur tempat agen dapat bertindak dalam batasan, menjaga pekerjaan mereka, melindungi komputasi sensitif, serta beroperasi pada sistem terdesentralisasi dengan jaminan keamanan yang bermakna.
IronClaw 1.0 karenanya mewakili sesuatu yang saya anggap lebih berharga daripada contoh kemampuan AI lainnya: langkah menuju menjadikan otonomi yang terkontrol sebagai bagian fundamental dari cara agen AI dirancang.
Pertanyaan bagi generasi berikutnya AI mungkin bukan apakah agen bisa menjadi makin otonom?
Mungkin:
Bagaimana kita membuat otonomi cukup tepercaya untuk digunakan?