

0x9810
157 Beiträge
0x9810
Melden
Nutzer blockieren
Hochfrequenz-Trader
6.2 Jahre
20 Following
94 Follower
89 Like gegeben
Beiträge
Alle
Zitierungen
·
--
#币安神算子 Mach schnell bei der Binance-Orakel-Aktion mit – anscheinend ist die Mindestschwelle für die garantierte Belohnung gar nicht so hoch.
#币安神算子 Mach schnell bei der Binance-Orakel-Aktion mit – anscheinend ist die Mindestschwelle für die garantierte Belohnung gar nicht so hoch.
69
·
--
#币安神算子
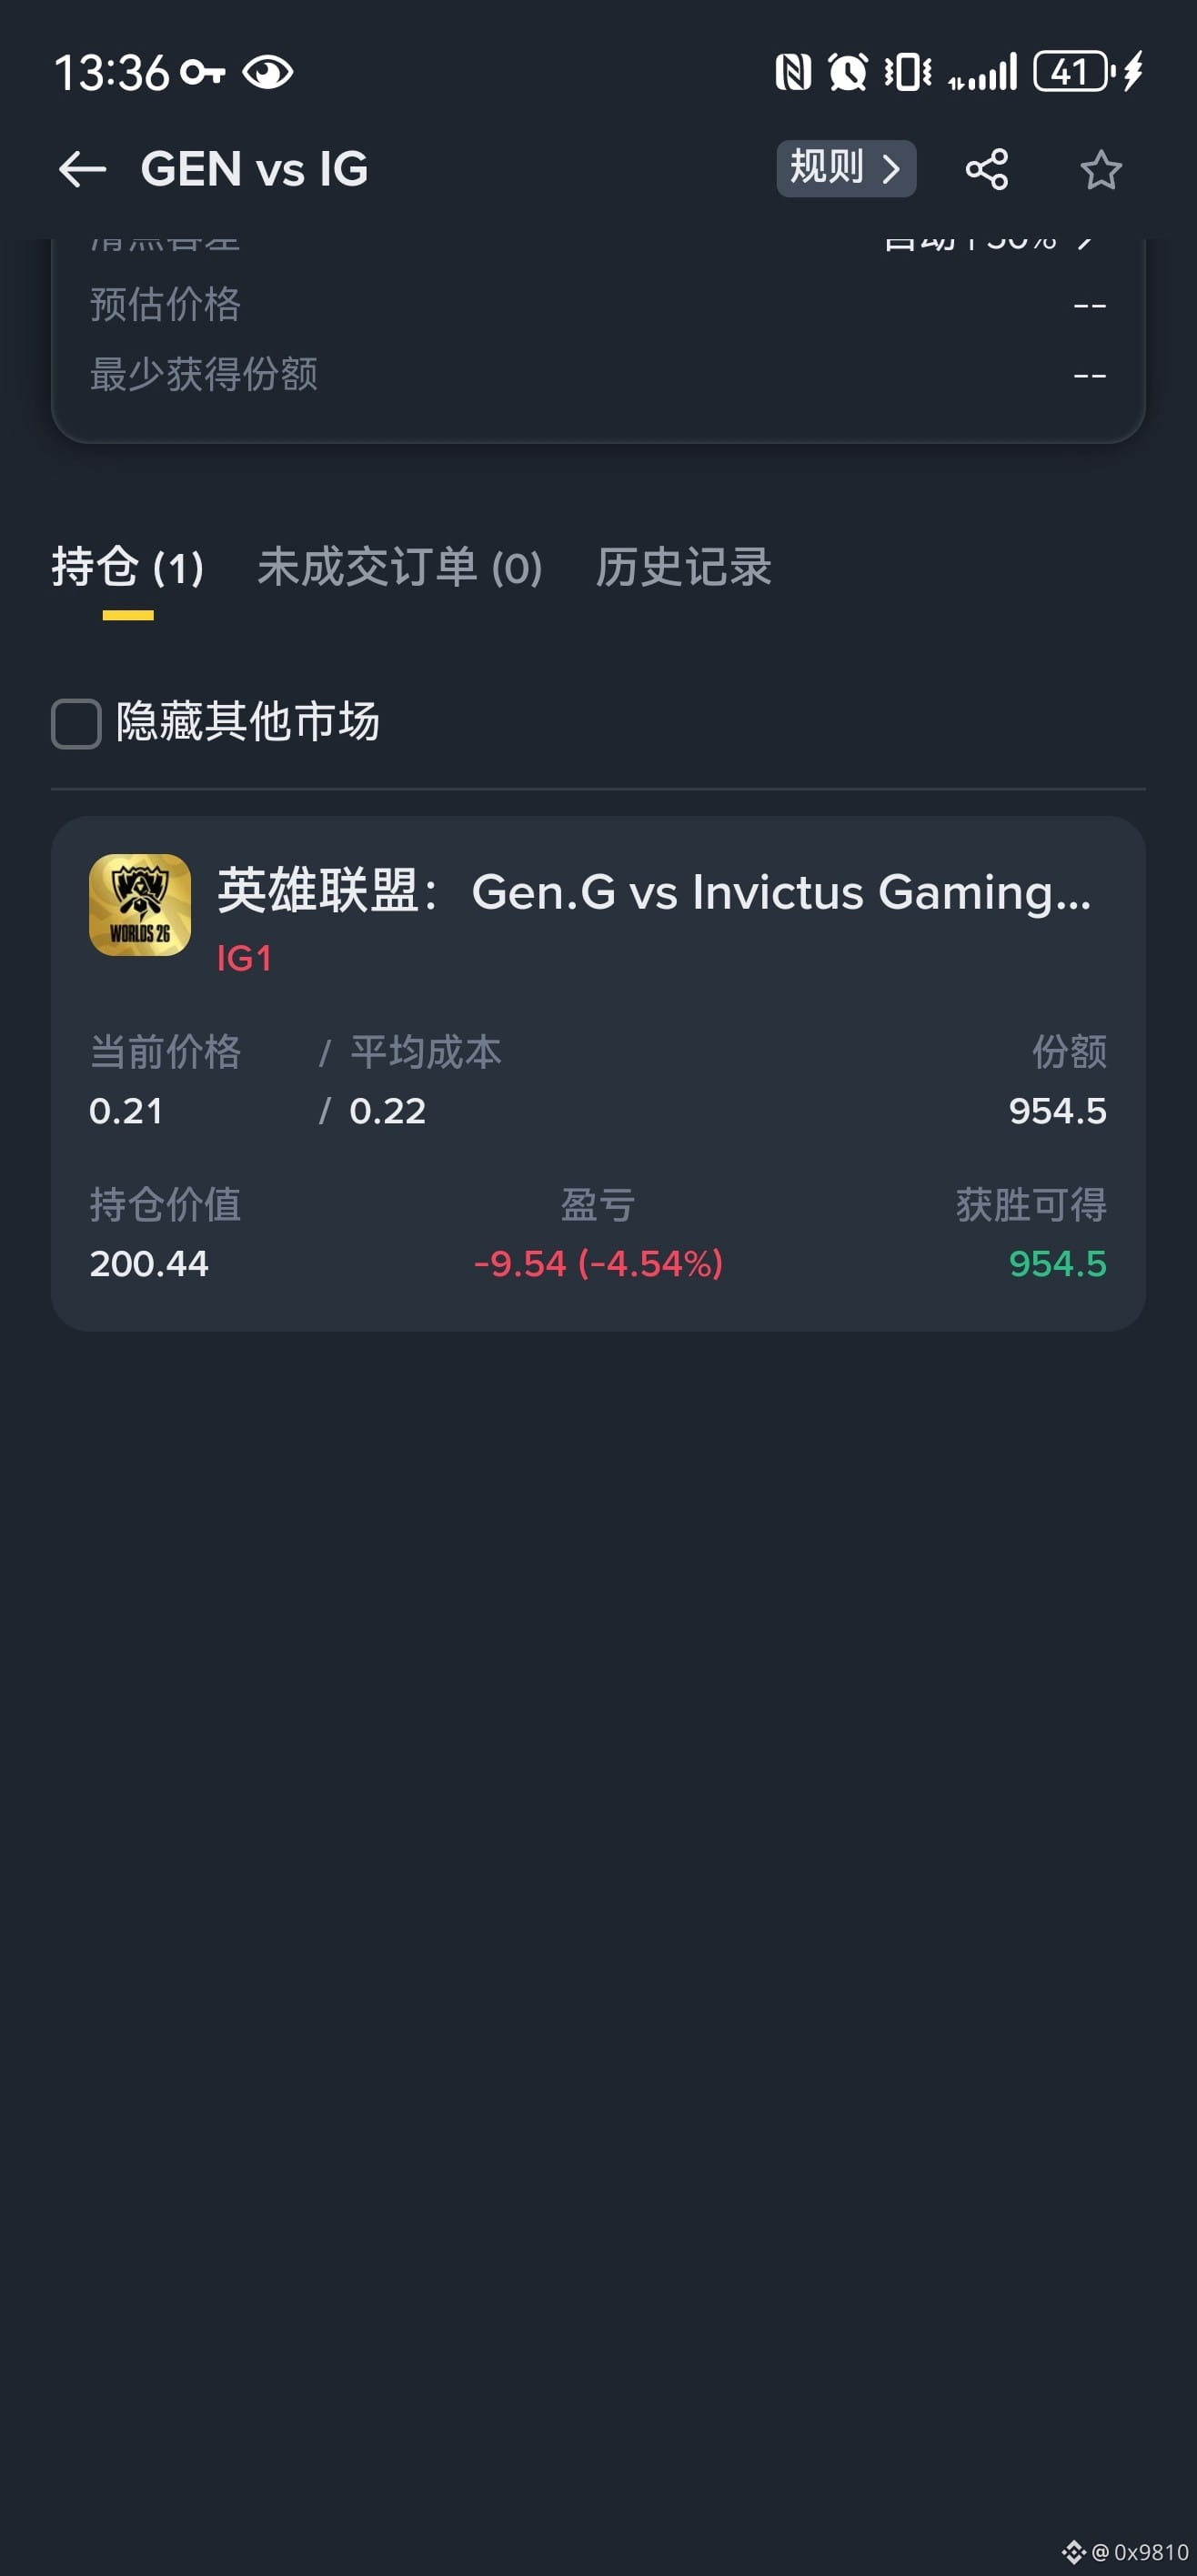
Ich habe gerade beim Binance-Orakel-Event ordentlich auf IG gesetzt. Auch wenn Dagen bockstark ist – in einem BO1 ist alles möglich.
#币安神算子
Ich habe gerade beim Binance-Orakel-Event ordentlich auf IG gesetzt. Auch wenn Dagen bockstark ist – in einem BO1 ist alles möglich.
Ich habe gerade beim Binance-Orakel-Event ordentlich auf IG gesetzt. Auch wenn Dagen bockstark ist – in einem BO1 ist alles möglich.
84
·
--
Nimm an der Binance-Prognoseaktion teil!
#币安神算子
Nimm an der Binance-Prognoseaktion teil!
#币安神算子
#币安神算子
73
·
--
Übersetzung ansehen
1
1


PANews
·
--
Arbitrum 推出 USDG 稳定币增长计划,设 200 万 ARB 奖励池
PANews 10月17日消息,据 DeFiprime 报道,Arbitrum 基金会于 10 月 15 日面向稳定币余额不低于 100 万美元的协议开放 Stablecoin Growth Program,要求入选团队将 USDG 设为其在 Arbitrum One 上的主要稳定币。计划设 200 万 ARB 奖励池,前 10 个将 USDG 30 天平均余额做到 1000 万美元的团队,各可获最高 20 万 ARB(上限 20 万美元)。奖励池有效期至 2027 年 12 月 31 日,每个参与者仅可领取一次。入选为自主裁量制,需完成 KYC/AML,最终协议可能附带在 Arbitrum 独家部署协议及代币的排他性条款。截至 10 月 17 日,Arbitrum 上 USDG 流通量约 3360 万美元。
20
·
--
Mit 100 USDT eine ZEC-Position eröffnen und ein bisschen herumspielen
Mit 100 USDT eine ZEC-Position eröffnen und ein bisschen herumspielen
282
·
--
Erzählen wir mal über $QNTSchon seit vielen Jahren nicht mehr an der Oberfläche gewesen, um mal durchzuatmen. Heute schauen wir uns $QNT @quant_network an.
(Ein Teil der Informationen wurde aus GPT abgefragt; die Zahlen sind möglicherweise nicht ganz genau. Binance und CMP dürften jedoch ungefähr stimmen.)
Quant(QNT) liegt mit seiner Kernpositionierung nicht auf einer einzelnen öffentlichen Blockchain, sondern als „Unternehmens-Interoperabilitätsschicht“, die traditionelles Finanzwesen und Blockchain verbindet. Von der Emissionszeit her ist es bereits eine alte Coin; sie hat bereits mindestens zwei komplette Bullen- und Bärenzyklen durchlaufen. Die dokumentierten Tiefs innerhalb von Binance liegen bei etwa 0,16 u. Jetzt pendelt sie über 200 u; das wirkt bereits sehr hoch. Aber schauen wir uns diesen Coin trotzdem an: Ob er sich nach oben bewegen kann, hängt davon ab, ob seine Bank-Infrastruktur-Aufträge in eine nachhaltige Entwicklung umgewandelt werden können – also in eine echte, anhaltende Nachfrage nach dem QNT-Token.
Erzählen wir mal über $QNT
Schon seit vielen Jahren nicht mehr an der Oberfläche gewesen, um mal durchzuatmen. Heute schauen wir uns $QNT @quant_network an.
(Ein Teil der Informationen wurde aus GPT abgefragt; die Zahlen sind möglicherweise nicht ganz genau. Binance und CMP dürften jedoch ungefähr stimmen.)
Quant(QNT) liegt mit seiner Kernpositionierung nicht auf einer einzelnen öffentlichen Blockchain, sondern als „Unternehmens-Interoperabilitätsschicht“, die traditionelles Finanzwesen und Blockchain verbindet. Von der Emissionszeit her ist es bereits eine alte Coin; sie hat bereits mindestens zwei komplette Bullen- und Bärenzyklen durchlaufen. Die dokumentierten Tiefs innerhalb von Binance liegen bei etwa 0,16 u. Jetzt pendelt sie über 200 u; das wirkt bereits sehr hoch. Aber schauen wir uns diesen Coin trotzdem an: Ob er sich nach oben bewegen kann, hängt davon ab, ob seine Bank-Infrastruktur-Aufträge in eine nachhaltige Entwicklung umgewandelt werden können – also in eine echte, anhaltende Nachfrage nach dem QNT-Token.
1
1
974
·
--
Wenn ihr vorbeikommt, lasst gern ein Follow da – danke.
Der heftige Bärenmarkt liegt bereits hinter uns. Achtet verstärkt auf den Spotmarkt und verschiedene Coins aus der zweiten Reihe. Wenn ihr einen Favoriten habt, schreibt den Coin gern in die Kommentare.
$QNT $BTC $ETH
Wenn ihr vorbeikommt, lasst gern ein Follow da – danke.
Der heftige Bärenmarkt liegt bereits hinter uns. Achtet verstärkt auf den Spotmarkt und verschiedene Coins aus der zweiten Reihe. Wenn ihr einen Favoriten habt, schreibt den Coin gern in die Kommentare.
$QNT $BTC $ETH
Der heftige Bärenmarkt liegt bereits hinter uns. Achtet verstärkt auf den Spotmarkt und verschiedene Coins aus der zweiten Reihe. Wenn ihr einen Favoriten habt, schreibt den Coin gern in die Kommentare.
$QNT $BTC $ETH

求个关注,谢谢
Von 小貔貅2026
1
659
·
--
Bullisch
Wenn man im Alltag einen Rest an Staub hat, kann man ihn gegen $QNT tauschen
Diese Münze sollte innerhalb eines Jahres steigen; wie hoch sie steigen kann und ob sie eine Stufe erklimmen kann, ist eine andere Frage. Alle können im Alltag ruhig ein bisschen davon horten. Die Gesamtmenge liegt nur bei etwas über 11 Millionen Stück. Das ist eine alte Währung.
Diese Münze sollte innerhalb eines Jahres steigen; wie hoch sie steigen kann und ob sie eine Stufe erklimmen kann, ist eine andere Frage. Alle können im Alltag ruhig ein bisschen davon horten. Die Gesamtmenge liegt nur bei etwas über 11 Millionen Stück. Das ist eine alte Währung.
2
1.1k
·
--
10u auf 0,1zec genommen, 5941 als Take-Profit gesetzt. Mal sehen, ob die 10u auf 0 gehen oder bis 5941 kommen.
10u auf 0,1zec genommen, 5941 als Take-Profit gesetzt. Mal sehen, ob die 10u auf 0 gehen oder bis 5941 kommen.
226
·
--
23
·
--
Als ich anfing, über automatisierte Postings nachzudenken, war meine erste Reaktion: "Wie kann ich 20041 abfangen?"
Die Einrichtung einer automatisierten Pipeline für Binance Square basiert auf einer vierstufigen Zerlegung.
**Erste Stufe: Datensammlung** Mein Gedanke ist einfach – ein cron-Skript schreiben, das jeden Abend automatisch CoinGecko-Daten, Ankündigungsströme, Änderungen im Holdings und Funding-Raten abruft. Nicht um den Markt vorherzusagen, sondern um täglich relevante Themen zu erfassen, die es wert sind, geteilt zu werden. Die Sammlungsebene ist nicht kompliziert, es ist einfach die Kombination aus Datenquelle und Timer.
**Zweite Stufe: Umschreibung** Hier kommt das LLM ins Spiel. Rohdaten fließen hinein, und nach meinem vorgegebenen Template wird ein Newsletter von maximal 1200 Wörtern generiert, der objektiv berichtet. Die Kernanforderungen sind: konkrete Zahlen, Zeitstempel, subjektive Urteile vermeiden. Mein Prompt für das LLM ist sehr streng, um den "kreativen Spielraum" zu minimieren.
**Dritte Stufe: Zugangskontrolle** Hier kommt der eigentliche Disziplinaspekt ins Spiel. Ich habe 4 Abfangmechanismen eingerichtet: Wortzahlprüfung (80-1800 Wörter), URL-Überprüfung, Liste sensibler Wörter und tägliche Quotenprüfung. Jeder Mechanismus ist eine unabhängige boolesche Bewertung; jeder Misserfolg führt zu einem direkten Block, ohne Ausnahmen. Die interessanteste Sache an dieser Stufe ist, dass sie sicherstellt, dass mein Inhalt den Plattformregeln entspricht, anstatt auf "Glück" zu setzen.
**Vierte Stufe: Push** Mit OpenAPI direkt zu Binance Square pushen, der Status von Erfolg oder Misserfolg wird in Echtzeit in eine lokale Datei geschrieben, um eine Rückverfolgung der Protokolle zu erleichtern.
Das gesamte System habe ich an zwei Abenden aufgebaut. Aber ich möchte sagen, dass das eigentliche Schwierige nicht die technische Umsetzung ist, sondern die dritte Stufe – die Zugangskontrolle. Der Grund für das Scheitern vieler Automatisierungen liegt oft nicht an technischen Bugs, sondern daran, dass die Zugangskontrollregeln nicht streng genug sind. Wenn deine Zugangskontrollstufe ausreichend diszipliniert ist, kann die gesamte Pipeline lange genug bestehen.
$BTC #BinanceSquare #AI
132
·
--
Meine Binance Skills Vier-Eck-Nutzungs-Karte
Nach fast einem halben Jahr im Binance Skills Hub habe ich sowohl die gesehen, die mühsam die Meinungen anderer weiterverbreiten, als auch die, die sich in Werkzeuge und Automatisierung vertiefen. Tatsächlich ist es nicht nötig, sich für das eine oder das andere zu entscheiden.
Ich habe zusammengefasst, dass die echten Skills, die ich täglich nutze und kontinuierlich verbessere, nur 4 sind. Andere sind zwar auch interessant und werden in der Community verwendet, haben aber keinen Einfluss auf meinen spezifischen Arbeitsablauf. Mag vielleicht ein bisschen realistisch klingen, aber um ehrlich zu sein: Nicht jeder Skill passt zu dir.
**Erstes Quadrat: Trading-Monitoring-System** 📊
Das ist das Basis-Setup. Ich habe 3 Regeln aufgestellt: halbautomatische Order-Pipeline (wenn die Eingangsbedingungen erfüllt sind, wird eine Bestätigung gesendet), Take-Profit und Stop-Loss (einmal gesetzt, muss man sich nicht mehr darum kümmern), Gebührenüberwachung (alle 4 Stunden wird die Gebühr automatisch überprüft, und Coins mit negativen Zinsen werden rot markiert und verkauft).
Klingt kompliziert, aber einmal eingerichtet, ist es nur Hintergrundarbeit. Meine tägliche Zeit für diese Aktivitäten ist von ursprünglich 2 Stunden auf 15 Minuten gesunken. Diese Art von Skill macht etwa 50% meiner täglichen Effizienzsteigerung aus.
**Zweites Quadrat: On-Chain-Signal-Input**
Ich benutze dafür Smart Money Tracking und neue Coin-Scans. Jeden Morgen gehe ich in 7-8 Minuten schnell durch, um zu sehen, ob es in der Nacht irgendwelche Markt-Signale gab. Das ist 2-3 Stunden schneller als die offiziellen Nachrichten der Börsen und 30 Minuten schneller als soziale Medien.
Interessanterweise liegt der größte Wert dieses Moduls nicht darin, dir zu sagen, "was zu kaufen", sondern "wo die Liquidität jetzt ist". Ich nutze es, um die Eingangssignale des ersten Quadrats zu ergänzen, was die Genauigkeit erheblich verbessert hat.
**Drittes Quadrat: DeFi Passive Einkünfte**
Hier gebe ich zu, dass ich am faulsten bin. Ich werfe einfach ungenutztes Kapital in bestimmte Protokolle mit hohen APY-Pools, monatliche Renditen von 30%-60%. Ein Skill hilft mir, Gelegenheiten für kurzfristige Arbitrage zu überwachen.
Ich schaue jede Woche nach, ob es besonders lukrative Gelegenheiten gibt, ohne ständig darauf achten zu müssen. Tatsächlich kann ich aus ursprünglich ungenutztem Guthaben 1-2% zusätzliches monatliches Cashflow herausholen. Unauffällig, aber auf lange Sicht summiert sich das.
**Viertes Quadrat: Inhaltsverteilung** 🔥
Das wird stark unterschätzt. Ich wandel meine Trading-Beobachtungen automatisch in Community-News um, Hotspot-Zusammenfassungen werden automatisch erstellt, ohne dass ich handschriftlich eingreifen muss. Es geht nicht darum, ein KOL zu werden, sondern darum, meine Gedanken in eine automatisierte Pipeline zu bringen.
Von "täglichen manuellen Zusammenfassungen" zu "systemautomatisch empfohlen" – sieht klein aus, aber hat den gesamten Informationsfluss verändert.
**Wichtige Erkenntnis**
Nach all der Zeit habe ich festgestellt:
Das alleinige Nutzen des ersten Quadrats ist wie auf einen Glückstreffer zu warten; nur in Kombination mit den Alpha-Signal-Eingängen des zweiten Quadrats kann man eine andere Gewinnquote erzielen. Das dritte Quadrat mag nicht relevant erscheinen, aber in Verbindung mit dem Risikomanagement des ersten Quadrats kann es die gesamte ROI-Kurve glätten. Die meisten bleiben beim ersten Quadrat stehen, denken, es reicht, aber das ist eigentlich eine verpasste Hebelmöglichkeit.
Es ist nicht zwingend erforderlich, alles zu nutzen. Aber wenn man nur beim passiven Monitoring des ersten Quadrats bleibt, hat man den Kern dieses Werkzeugs wirklich nicht erfasst.
Mein Vorschlag: Wähle einen Freitagnachmittag, nimm dir 2-3 Stunden Zeit, um das erste Quadrat zu meistern. Dann nimm dir 1-2 Wochen zerstreute Zeit, um die Signale des zweiten Quadrats einzubinden. Warte, bis diese Kombination stabil ist, bevor du über andere nachdenkst.
$BTC $ETH $BNB #BinanceSquare #Skills
161
·
--
Am Wochenende habe ich wieder einen halben Tag mit repetitiven Aufgaben verbracht und plötzlich realisiert, dass mein AI-Automatisierungsstack nun schon seit einem halben Jahr läuft und die Effizienz ziemlich deutlich gestiegen ist. Ich dachte mir, ich fasse mal zusammen, wie dieses Setup zusammenarbeitet.
Im Kern gibt es zwei Rollen: **Hermes macht die Organisation**, Claude Code ist für die Ausführung zuständig. Hermes ist im Grunde ein Aufgabenmanager, der Zeitpläne, Erinnerungsverwaltung, Hintergrund-Cron-Jobs abwickelt und Nachrichten an Telegram und Feishu verteilt. Stell es dir vor wie einen immer verfügbaren Sekretär, der sich an die Ideen von gestern erinnert, heute rechtzeitig erinnert und morgen automatisch ein Datensammelskript ausführt.
Echte komplexe Programmierarbeiten überlasse ich Claude Code, der das einmalig erledigt. Große Refaktorisierungen, Code-Audits oder das Design einer Funktion von 0 auf 1 – das erledigt Claude Code direkt im CLI-Modus. Beide Seiten können auf meine Skill-Bibliothek (Methoden-Reflexion) zugreifen, wenn Hermes eine bestehende Logik wiederverwenden möchte, ruft er einfach den Skill auf; Claude Code kann das auch nutzen, der Umstieg kostet kaum etwas.
Bei der Modellauswahl ist es ein Kosten-Nutzen-Gleichgewicht. Für alltägliche Gespräche, tägliche Berichte und Marktüberwachung, die häufige Interaktionen erfordern, nutzen wir Haiku (günstig), und bei wirklich anspruchsvollen Aufgaben, die tiefere Überlegungen erfordern, upgraden wir auf Sonnet oder Opus. So kann die Token-Kosten im Monat in Schach gehalten werden.
Aus einer anderen Perspektive betrachtet, ist **der Agent das Gehirn der automatisierten Produktionslinie**, das Entscheidungen trifft und plant; **der Skill ist die Hand der Linie**, die die eigentliche Arbeit verrichtet. Hermes ist auf der Agent-Seite und gibt jedem Schritt in der Linie Gedächtnis und Kontext. Wenn eine Aufgabe außerhalb des Rahmens liegt, eskaliert sie direkt an den Experten Claude Code.
Vor der Implementierung dieser Lösung habe ich wöchentlich 8 Stunden mit repetitiven Aufgaben verbracht. Jetzt laufen einige Arbeiten im Hintergrund und ich muss nur regelmäßig Berichte oder Fehlermeldungen überprüfen. Die größte Falle war, dass die Skill-Dokumentation unklar war, was zu Fehlern bei der Verwendung führte. Jetzt zwinge ich für jeden neuen Skill die Ergänzung von "Häufigen Fallen" und "Anwendungsszenarien".
In diesem Zusammenhang denke ich, dass der Kern der AI-Automatisierung nicht darin besteht, das stärkste Modell zu verwenden, sondern **die Arbeit so fein zu zerlegen, dass jede Einheit unabhängig genug ist und Fehler leicht zu debuggen sind**. Ein kleines Team könnte in diese Richtung investiert viel manuelle Arbeit einsparen.
$BTC #AI #Agent
150
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
FedWatch
16.3M Aufrufe
39,429 Kommentare
🚨 🇺🇸 PETER SCHIFF HAT SOEBEN EINE DEUTLICHE WARNUNG AN DIE FED GERICHTET!
Peter Schiff bezeichnet Kevin Warshs harte Rhetorik zur Inflation als „Bluff“, und seine Prognose könnte erhebliche Auswirkungen auf die Märkte haben.
Schiff glaubt, dass die Fed irgendwann wieder zur Geldschöpfung durch quantitative Lockerung (QE) zurückkehren und sogar im nächsten Jahr die Zinsen senken könnte, obwohl die Inflation weiter steigt.
Denk einen Moment darüber nach.
🔥 Die Inflation könnte weiterhin ein Problem bleiben. 🔥 Die Fed könnte trotzdem auf eine lockerere Geldpolitik zusteuern. 🔥 Mehr Liquidität könnte in die Finanzmärkte fließen.
Sollte dieses Szenario eintreten, könnte das für Aktien, Gold, Bitcoin und den gesamten Kryptomarkt ein völlig anderes Marktumfeld schaffen.
Doch es gibt einen Haken: Bleibt die Inflation hoch, könnte die Fed vor der schwierigen Entscheidung stehen, ob sie steigende Preise bekämpfen oder die Wirtschaft stützen soll.
Wird Warsh an einer strikten Inflationspolitik festhalten, oder wird die Fed irgendwann ihren Kurs ändern?
Der nächste Schritt könnte für Anleger sehr wichtig sein.
#FedWatch #EarningsSeason #USMidtermElections #BrazilCryptoExchangesMustApplyForLicensesByFriday #StanDruckenmillerBecomesInvestorInTradeXYZ
Jackson Liam
·4 Likes
·8.5k Aufrufe
EarningsSeason
6.4M Aufrufe
32,125 Kommentare
USMidtermElections
45,540 Aufrufe
634 Kommentare