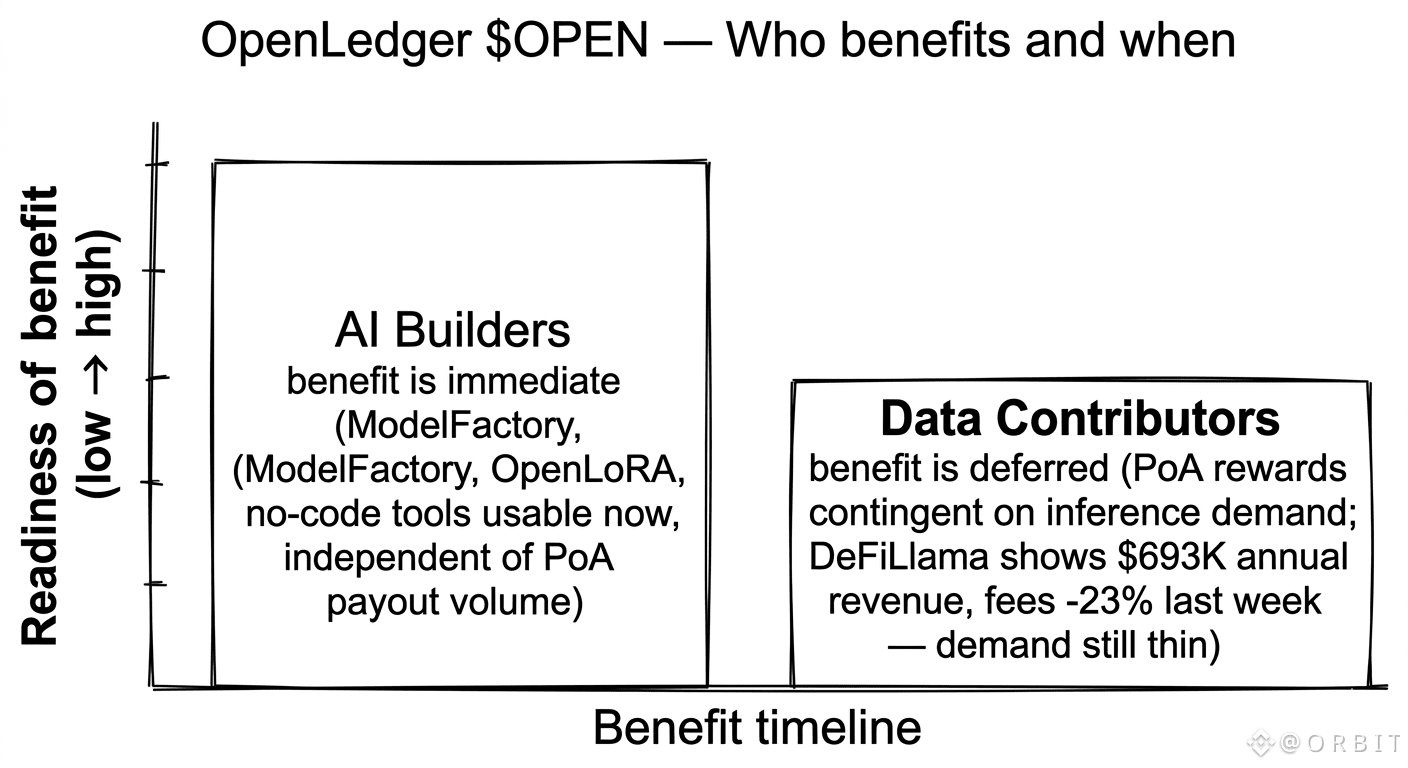
Was mir von der OpenLedger-Aufgabe $OPEN #OpenLedger @OpenLedger im Gedächtnis geblieben ist: Die beiden Begünstigtengruppen – KI-Entwickler und Datenbeitragende – bewegen sich auf sehr unterschiedlichen Zeitachsen, obwohl der Pitch sie so darstellt, als kämen sie gemeinsam ans Ziel. Entwickler profitieren sofort: ModelFactory funktioniert schon heute, No-Code-Fine-Tuning funktioniert schon heute, und OpenLoRA stellt Modelle ohne großen Infrastrukturaufwand bereit. Dieser Nutzen steht von Anfang an zur Verfügung und hängt nicht davon ab, dass das Proof-of-Attribution-Schwungrad in Gang kommt. Bei den Beitragenden ist das anders. Ihre Belohnungen werden erst dann greifbar, wenn die auf ihren Datanets aufgebauten Modelle in großem Umfang tatsächlich abgefragt werden – doch DeFiLlama weist jährliche Protokolleinnahmen von 693.000 US-Dollar aus, während die Gebühren in der vergangenen Woche um 23 % gesunken sind. Das deutet darauf hin, dass die Nachfrage nach Inferenz noch gering ist. Das Design ist stimmig; der zeitliche Ablauf ist jedoch wichtiger, als es die Darstellung vermuten lässt. Entwickler kommen hinzu, bauen auf der Infrastruktur auf, und die Modelle warten. Die Beitragenden haben bereits Daten hochgeladen, bereits ihren Beitrag geleistet und bereits ihre Attributionsnachweise erhalten … und warten nun auf eine Nachfrage, die noch nicht vollständig da ist. Ob sich diese Lücke schließt, hängt einzig davon ab, ob die Entwickler, die gekommen sind, tatsächlich Produkte auf den Markt bringen, die Menschen nutzen.


Veröffentlichen
Haftungsausschluss: Enthält Meinungen von Drittanbietern. Keine Beratung. Binance AI wird ohne Gewähr bereitgestellt. Siehe AGB.